 Capital de Tokens
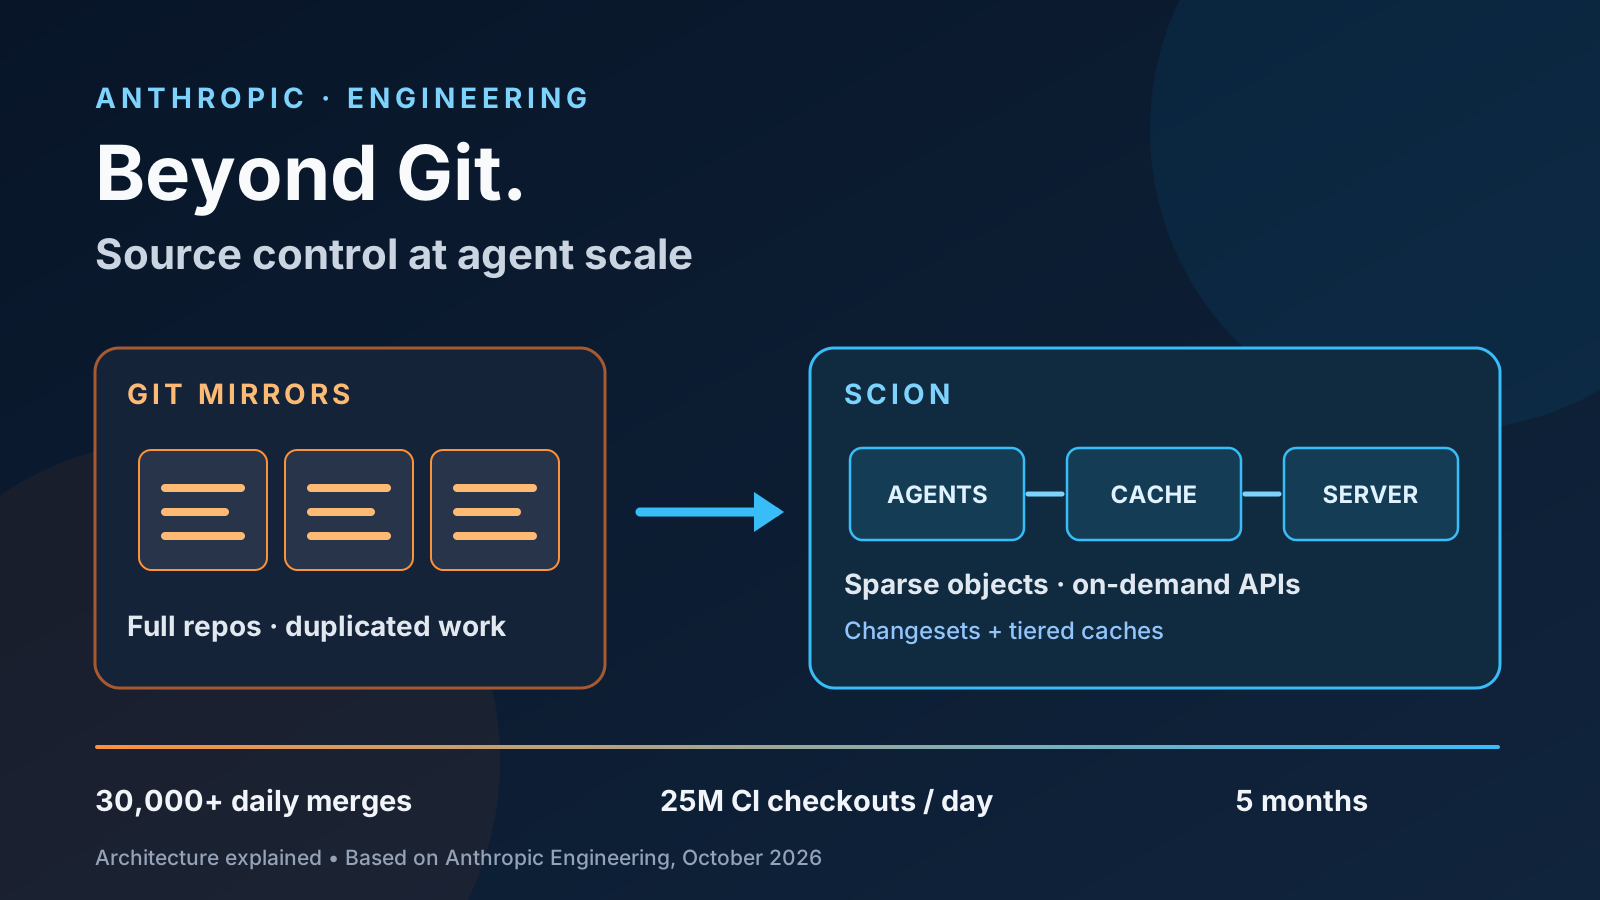
Durante décadas, una premisa ha definido el control de versiones moderno: cada desarrollador puede disponer de una copia del repositorio, consultar su historial y crear commits sin conexión. Git es extraordinariamente bueno en ese escenario. Pero ¿qué ocurre cuando quienes producen cambios son miles de procesos automatizados, casi siempre conectados, y la misma base de código se descarga millones de veces al día?
El 13 de octubre de 2026, Anthropic publicó Redesigning source control at Anthropic, actualizado el día 15. Allí contó cómo construyó Scion, su propio sistema de control de versiones, y completó la migración de su monorepo desde Git en cinco meses. La historia no demuestra que Git haya quedado obsoleto. Demuestra algo más preciso: una arquitectura optimizada para el desarrollo humano y desconectado puede resultar costosa cuando el cliente típico es un agente o un job de CI.
El problema no era escribir código: era moverlo y coordinarlo
La escala descrita por Anthropic es excepcional:
| Indicador | Cifra comunicada por Anthropic |
|---|---|
| Cambios integrados al día, mayo de 2026 | Aproximadamente 2.500 |
| Cambios integrados al día, septiembre de 2026 | Más de 30.000 |
| Historial de la rama principal | Casi 100 GB |
| Copia de trabajo comprimida | Más de 25 GB |
| Checkouts de código para CI | Del orden de 25 millones al día |
| Tráfico teórico con descargas ingenuas de Git | Más de 600 PB al día |
El salto de 2.500 a más de 30.000 merges diarios equivale a multiplicar el volumen por más de doce. La carga no procede solamente de desarrolladores interactivos: también de agentes, entornos efímeros, pruebas e infraestructura de investigación.
Anthropic ya había probado shallow clones, sparse checkouts, partial clones, copias semilla (seeds) y cientos de espejos de Git. Esas técnicas mitigaban el problema, pero el mantenimiento y la sincronización de los espejos seguían escalando mal.
La pregunta de diseño cambió: si casi todos los clientes están conectados permanentemente, ¿por qué obligarlos a comportarse como pequeños servidores Git autónomos?
Git y Scion parten de supuestos diferentes
| Decisión | Git convencional | Scion en Anthropic |
|---|---|---|
| Conectividad | El cliente puede trabajar sin red | Se asume acceso al servidor |
| Historial y operaciones | Cada clon puede calcular gran parte localmente | El servidor responde consultas, merges y rebases |
| Almacenamiento del cliente | Repositorio local, con opciones parciales | Caché acotada y archivos solicitados |
| Transferencia | Negociación de objetos y packs | Peticiones puntuales de árboles y blobs inmutables |
| Automatización | Frecuentemente requiere checkout | Muchas operaciones funcionan vía API sin checkout |
| Escalado | Espejos, snapshots y mantenimiento | Servicios y cachés distribuidos horizontalmente |
Esto no quiere decir que Git carezca de partial clone o sparse checkout: sí los tiene. La diferencia es que Scion diseña todo el protocolo y los servicios alrededor de esa modalidad, en vez de añadirla como optimización a un modelo distribuido.
Cómo funciona Scion, pieza por pieza
1. El changeset es la unidad de trabajo
En Git, un commit apunta a un árbol que representa el estado de los archivos. En Scion, un changeset registra principalmente los archivos modificados respecto de su primer padre y referencias direccionadas por contenido a sus blobs comprimidos. Los changesets se escriben del lado del servidor en un registro anticipado de escritura (write-ahead log).
La consecuencia es relevante: crear un cambio puede depender de cuánto cambió, y no del tamaño total del monorepo. La creación de cambios no requiere transferir packfiles, mover una rama por cada trabajo o coordinar bloqueos globales.
Scion sí admite referencias, pero desincentiva su proliferación; la actualización de una referencia —por ejemplo, la principal— se resuelve por separado mediante una operación de comparación e intercambio en una fila de Spanner.
2. El historial consultable se construye como datos derivados
Un registro de archivos modificados no basta para responder rápidamente «¿quién cambió esta línea?» o «¿cuál es la base común de estos commits?». Scion materializa estructuras adicionales para blame, historial por ruta y relaciones del grafo de cambios, incluidas skip lists.
Anthropic llama derived data a esos índices. Cada estructura se calcula a partir de los cambios y de datos derivados de sus padres; algunas se generan inmediatamente y otras solo cuando son necesarias. Así pueden introducir nuevos índices sin cambiar el protocolo del cliente.
La idea arquitectónica es potente: el log de cambios es pequeño y la capacidad de consulta se construye como servicios e índices especializados.
3. El checkout puede ser parcial, virtual o inexistente
El cliente scn solo solicita los árboles y blobs que necesita. Revisa su caché, identifica objetos ausentes y los pide de forma recursiva. Como cada objeto es inmutable y está identificado por su contenido, diferentes niveles de caché pueden servirlo sin renegociar el estado completo del repositorio.
El recorrido simplificado es:
Agente o job de CI
        |
        v
      scn
        |
        v
scion-daemon (caché del nodo)
        |
        v
scion-cache (caché regional)
        |
        v
scion-server (servicio autoritativo)
        |
        +--> Spanner / almacenamiento de blobs
Cada nivel utiliza las mismas RPC; la topología se impone para aislar fallos regionales. Un job que solo necesita un diff o metadatos puede llamar al servicio sin materializar una copia de trabajo. Si necesita archivos, el checkout puede ser disperso o virtualizado.
4. Las operaciones difíciles se ejecutan en el servidor
Commits, merges, rebases, consultas de historia y cálculo de diferencias pasan a servicios centrales. Esto elimina muchas copias locales completas y hace más fácil exponer esas operaciones como APIs para pipelines y agentes. A cambio, crea dependencia de la conectividad y exige ingeniería seria de disponibilidad, autenticación y control de acceso.
Anthropic también construyó Antique, su propia interfaz de revisión de código, junto con búsqueda de código y permisos granulares por directorio. Scion no fue una sustitución aislada de un comando de Git: fue una reorganización de la plataforma de desarrollo.
Qué resultados reportó Anthropic (y qué no significan)
Según sus mediciones internas:
- La infraestructura de Scion requiere una huella 200 veces menor en CPU y memoria que su anterior infraestructura de espejos Git. Es una comparación de esas infraestructuras, no una promesa universal de que Scion consume 200 veces menos que cualquier instalación de Git.
- Los checkouts de CI e investigación son aproximadamente dos órdenes de magnitud más rápidos: segundos en lugar de minutos.
- CI obtuvo un 25 % de ahorro de capacidad de CPU.
- Cada nivel de la jerarquía de caché mantiene más del 99 % de aciertos.
Estas cifras son resultados comunicados por Anthropic para su carga concreta; el artículo original no aporta un benchmark neutral que permita extrapolarlas a cualquier empresa.
Claude fue parte del problema y parte de la solución
La historia tiene una paradoja: Claude ayudó a generar tantos cambios que la infraestructura de control de versiones se convirtió en cuello de botella; después ayudó a construir su reemplazo.
Anthropic afirma que siete ingenieros desarrollaron Scion, Antique y sistemas relacionados, y migraron el monorepo en cinco meses. En un ejemplo específico, una versión de su pipeline de ingestión reescrita por un modelo interno temprano de Claude Mythos Preview utilizó 20 veces menos memoria y fue cuatro veces más rápida que el prototipo anterior.
Es importante no borrar el papel humano detrás del titular. Los ingenieros decidieron las invariantes, los límites entre sistemas, las compensaciones arquitectónicas y qué propuestas del agente debían rechazarse. Anthropic menciona simulaciones herméticas, fuzzing, límites de tasa y revisión de la intención de los cambios. Generar código más deprisa no sustituye definir qué propiedades no pueden romperse.
La lección incómoda: también hay que rediseñar CI y el review
Cuando cientos o miles de cambios pueden integrarse mientras se ejecutan las pruebas, una cola de merge con bloqueo global deja de representar bien el sistema. Anthropic describe una mayor inversión en pruebas posteriores al merge y anteriores al despliegue, aceptando que puedan existir conflictos concurrentes que los agentes ayudan a corregir.
Esta decisión tiene riesgos. No equivale a recomendar que todos eliminen las puertas de calidad antes del merge. Funciona, o falla, dentro de un contexto con observabilidad, pruebas y mecanismos de recuperación adaptados a su velocidad.
El salto conceptual es pasar de pensar en una secuencia de programadores a pensar en un flujo continuo de cambios producido por múltiples agentes.
¿Debería tu equipo abandonar Git?
Para la inmensa mayoría de equipos, no. Lo que sí conviene es aprovechar las ideas de Scion antes de considerar una migración radical:
- Medir antes de reemplazar. ¿Se pierde tiempo descargando el repositorio, ejecutando builds innecesarios, esperando revisiones o coordinando merges?
- Reducir los datos movidos. Probar sparse checkout, partial clone, cachés de dependencias y artefactos de CI.
- Consultar sin clonar cuando sea posible. Una API de metadatos y diffs puede ahorrar checkouts a jobs y agentes.
- Aislar servicios y límites. Usar cachés regionales, límites de concurrencia, controles de acceso y planes de degradación.
- Evaluar el sistema completo. El control de versiones, la revisión, las pruebas y el despliegue forman una misma cadena de capacidad.
Estos cinco pasos son recomendaciones editoriales, no una lista de instrucciones emitida por Anthropic.
Scion tampoco debe presentarse como herramienta pública disponible para instalar: el artículo describe un sistema interno y no anuncia su liberación como producto open source. Anthropic reconoce precedentes de gran escala como Piper de Google y Sapling de Meta.
Conclusión
El dato más importante de Scion no es que una empresa sustituyera Git. Es que cambió el cliente que estaba optimizando: de una persona que necesita una copia autónoma a miles de agentes y jobs que necesitan pequeñas respuestas muy rápidas de un servicio en línea.
Cuando la producción de código se multiplica, puede que el recurso escaso deje de ser escribirlo y pase a ser integrarlo, validarlo y moverlo de forma segura. Ese es el verdadero aviso para quienes diseñan plataformas de ingeniería con agentes.
Fuentes y lecturas adicionales
- Anthropic Engineering: Redesigning source control at Anthropic (13 de octubre de 2026; actualizado el 15) — fuente primaria de cifras, arquitectura y declaraciones.
- Documentación de Git: partial clone — capacidades de Git para evitar descargar todos los objetos.
- Documentación de Git: sparse-checkout — trabajo con subconjuntos de archivos.
- Sapling SCM — sistema de control de versiones desarrollado por Meta, antecedente citado por Anthropic.