 Capital de Tokens
Durante años hemos usado asistentes de inteligencia artificial con una limitación bastante incómoda: cada conversación empieza casi desde cero.
El modelo puede ser excelente razonando, programando o escribiendo, pero si hace una hora estabas depurando una aplicación, revisando documentación y cambiando entre varias herramientas, normalmente debes reconstruir todo ese contexto manualmente.
Con Computer History, OpenAI empieza a atacar precisamente ese problema.
La función, anunciada para la aplicación de ChatGPT en macOS, permite que ChatGPT y Codex utilicen contexto procedente de aplicaciones y sitios web seleccionados por el usuario. OpenAI la describe como una forma de continuar trabajo sin tener que volver a explicar cada detalle.
Eso puede parecer una mejora de memoria. En realidad apunta a algo bastante mayor: convertir la actividad del sistema operativo en contexto utilizable por un agente.
Qué es exactamente Computer History
Computer History es una función opcional de la aplicación de ChatGPT para macOS.
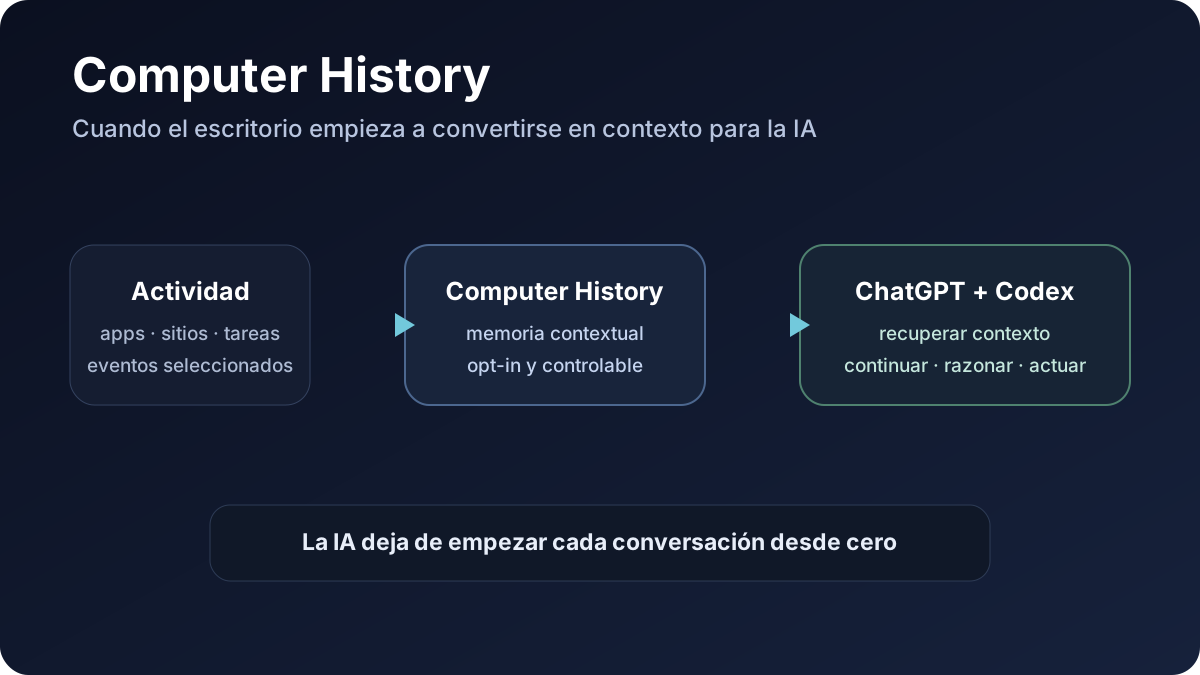
Según las notas oficiales de OpenAI publicadas el 13 de agosto de 2026, puede registrar eventos de interacción procedentes de aplicaciones y sitios web que el usuario decida incluir. Después, ChatGPT y Codex pueden consultar ese historial para entender mejor qué estaba haciendo la persona y retomar una tarea con menos explicaciones.
La idea puede resumirse así:
actividad en el Mac
        ↓
Computer History
        ↓
contexto recuperable
        ↓
ChatGPT / Codex
        ↓
continuar trabajo
La diferencia con un historial convencional es importante.
No se trata solamente de recordar qué conversaciones tuviste dentro de ChatGPT. El sistema empieza a tener contexto sobre actividad realizada fuera del chat.
En términos de experiencia de usuario, eso abre la puerta a preguntas como:
- “¿Qué estaba haciendo antes de salir?”
- “¿Cuál era el documento que estaba revisando esta mañana?”
- “Continúa desde donde dejé esta tarea.”
- “Resume en qué trabajé durante la última hora.”
Ese tipo de interacción cambia la relación entre usuario y asistente. El humano deja de ser el único responsable de reconstruir el estado de la sesión.
Lo importante: no funciona como Windows Recall
Una de las primeras preguntas inevitables es qué información captura realmente.
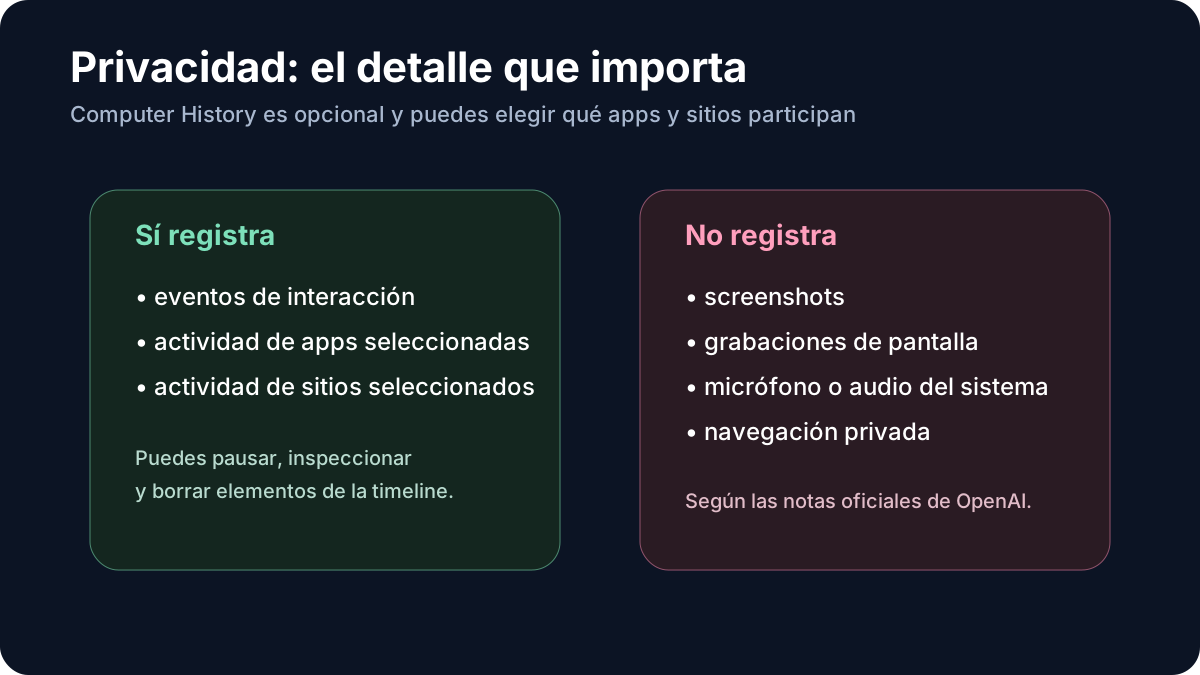
OpenAI especifica que Computer History registra eventos de interacción, pero no screenshots, grabaciones de pantalla, entrada de micrófono ni audio del sistema. La navegación privada tampoco se incluye.
Además, la función está desactivada por defecto. El usuario puede:
- activarla voluntariamente;
- seleccionar qué aplicaciones y sitios participan;
- pausarla;
- inspeccionar elementos de la timeline;
- eliminar elementos almacenados.
En planes Business y Enterprise, el administrador debe permitir la función antes de que cada miembro pueda activarla.
Esta distinción es relevante porque el contexto persistente puede ser extremadamente útil, pero también extremadamente sensible.
Cuanto mejor recuerde un asistente nuestra actividad, más importante resulta tener controles claros sobre qué entra en esa memoria, cuánto permanece y quién puede utilizarlo.
La verdadera novedad: el escritorio se convierte en contexto
Hasta ahora, el modelo mental dominante era sencillo:
usuario
  ↓
prompt
  ↓
modelo
  ↓
respuesta
Computer History introduce otra capa:
actividad previa
      ↓
memoria contextual
      ↓
prompt actual
      ↓
modelo
      ↓
respuesta o acción
La diferencia parece pequeña sobre el papel, pero es enorme para los agentes.
Un agente útil no debería necesitar que el usuario vuelva a describir constantemente el mundo en el que está trabajando. Necesita una representación del estado actual y del estado reciente.
En desarrollo de software lo vemos todo el tiempo. Para continuar una tarea no basta con saber el objetivo general. También importa:
- qué repositorio estaba abierto;
- qué archivo se modificó;
- qué error apareció;
- qué documentación se consultó;
- qué decisión se tomó hace diez minutos;
- qué pasos ya fueron ejecutados.
Computer History empieza a proporcionar una capa de continuidad entre esas interacciones.
De memoria a agente residente
Por sí sola, la memoria no convierte a ChatGPT en un agente residente del sistema operativo.
Pero combinada con otras capacidades empieza a aparecer una arquitectura bastante clara.
Podemos dividirla en cuatro capas:
- Memoria: Computer History conserva contexto de actividad seleccionada.
- Razonamiento: ChatGPT y Codex interpretan ese contexto y deciden qué hacer.
- Acción: capacidades de computer use permiten interactuar con interfaces y herramientas.
- Integraciones: archivos, plugins, navegador y servicios externos amplían lo que el agente puede ejecutar.
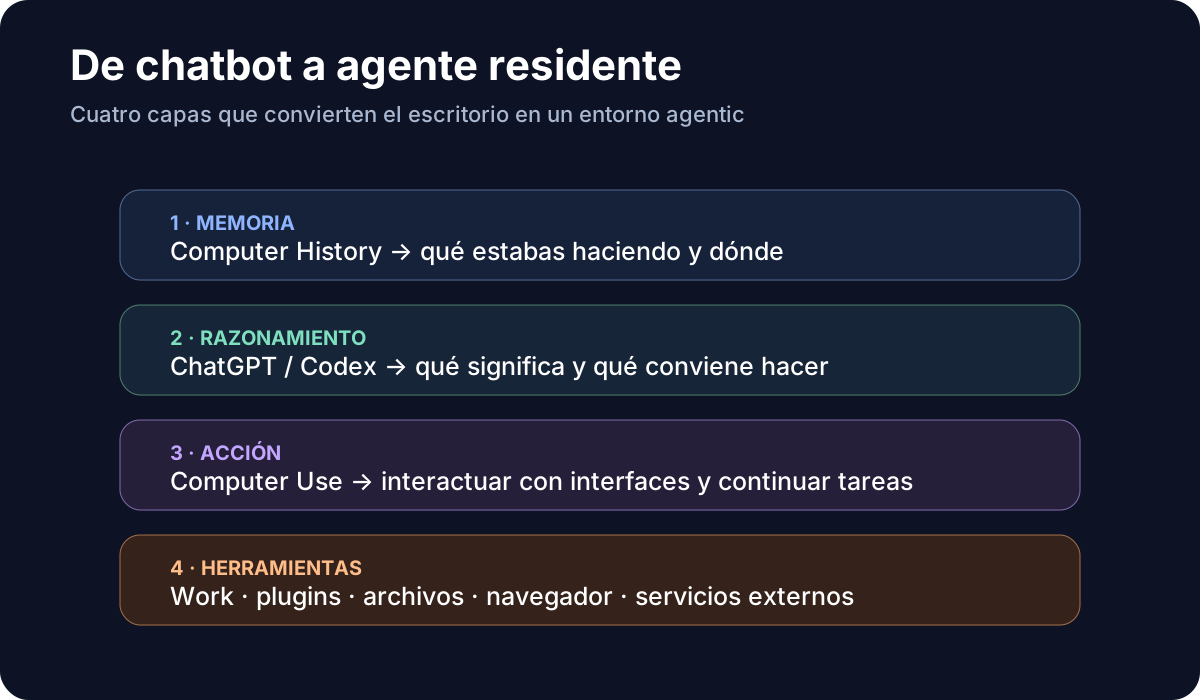
Conceptualmente:
Computer History
      ↓
   memoria
      +
ChatGPT / Codex
      ↓
 razonamiento
      +
Computer Use
      ↓
    acción
      +
plugins / Work / archivos / navegador
      ↓
 herramientas
Ese conjunto se aproxima mucho más a la idea de un agente personal persistente que a la de un chatbot tradicional.
El salto importante no es “recordar”, sino “continuar”
La palabra historial puede hacer que Computer History parezca una función pasiva.
Pero el valor real aparece cuando esa memoria alimenta una acción posterior.
Imaginemos una sesión de trabajo:
09:00  abres un repositorio
09:15  lees un issue
09:30  revisas documentación
10:00  modificas una función
10:20  aparece un error
10:30  sales del escritorio
Horas después vuelves y dices:
“Continúa con el problema que estaba resolviendo.”
Un chatbot tradicional necesita una explicación extensa.
Un agente con contexto histórico podría recuperar señales suficientes para reconstruir parte de la situación y reducir drásticamente el costo de reentrada.
Eso tiene implicaciones especialmente fuertes para tareas largas: programación, investigación, análisis financiero, documentación, soporte técnico o cualquier trabajo que atraviese varias aplicaciones.
La evolución de Codex encaja perfectamente con esta dirección
Codex ya está evolucionando desde el paradigma de “genera este fragmento de código” hacia tareas delegadas de mayor duración.
En ese tipo de flujo, la calidad del modelo sigue siendo importante, pero deja de ser el único cuello de botella.
También hacen falta:
- memoria de estado;
- herramientas;
- capacidad de ejecutar acciones;
- mecanismos para reanudar;
- observación del entorno;
- permisos bien definidos.
Por eso Computer History resulta interesante incluso si no genera una sola línea de código.
Es infraestructura contextual.
Y la infraestructura contextual es exactamente lo que un agente necesita para trabajar durante más tiempo sin pedir continuamente al usuario que le vuelva a contar la historia.
Del “AI assistant” al “AI operating layer”
Aquí aparece una posibilidad más ambiciosa.
Los sistemas operativos tradicionales organizan procesos, archivos, ventanas, dispositivos y permisos. Una capa de IA situada encima del sistema puede empezar a organizar algo diferente: intenciones, tareas y contexto humano.
En lugar de pensar solamente en aplicaciones independientes:
editor
navegador
terminal
correo
mensajería
podemos imaginar una capa que entiende una tarea transversal:
"publicar esta versión"
        ↓
lee el issue
        ↓
revisa el código
        ↓
ejecuta pruebas
        ↓
abre el PR
        ↓
comprueba CI
        ↓
avisa al equipo
La tarea es una sola, aunque atraviese seis aplicaciones.
Ese es uno de los cambios fundamentales que prometen los agentes: la unidad de trabajo deja de ser la aplicación y empieza a ser el objetivo.
Computer History ayuda a mantener el hilo que conecta esas aplicaciones.
El problema difícil será el control
Cuanta más continuidad tenga un agente, más útil puede ser.
Pero también aumenta la importancia del control.
Un sistema realmente persistente necesitará responder con claridad preguntas como:
¿Qué recuerda?
¿Qué puede ver?
¿Qué puede ejecutar?
¿Qué requiere aprobación?
¿Qué puede hacer automáticamente?
¿Qué información debe olvidar?
En ese sentido, que Computer History sea opt-in y permita elegir fuentes es una decisión importante.
La carrera por los agentes no será solamente una competición por autonomía. Será también una competición por construir autonomía gobernable.
El agente más capaz no necesariamente será el que pueda hacer más cosas sin preguntar. Puede terminar siendo el que entienda mejor cuándo actuar, cuándo pedir permiso y qué contexto no debería conservar.
Entonces, ¿por qué esta función importa tanto?
Porque resuelve una de las debilidades históricas de los asistentes de IA: la discontinuidad.
Un modelo puede tener un millón de tokens de contexto y seguir siendo torpe si el usuario debe introducir manualmente la información correcta cada vez.
Computer History mueve parte de ese trabajo hacia el propio sistema.
La evolución podría verse así:
Chatbot
  ↓
Asistente con memoria
  ↓
Asistente con herramientas
  ↓
Agente con contexto del escritorio
  ↓
Agente persistente orientado a objetivos
Todavía no estamos en el último escalón.
Pero la dirección es difícil de ignorar.
La idea de fondo
Durante la primera etapa de la IA generativa preguntábamos:
“¿Qué puede responder este modelo?”
Después pasamos a:
“¿Qué herramientas puede utilizar?”
La siguiente pregunta parece ser:
“¿Cuánto entiende de lo que estoy haciendo sin que tenga que explicárselo otra vez?”
Computer History es una pieza pequeña dentro de esa transición, pero toca una capa fundamental: la continuidad entre el humano, el modelo y el entorno de trabajo.
Si esa tendencia continúa, ChatGPT dejará de sentirse como una aplicación a la que vamos a hacer preguntas y empezará a parecerse cada vez más a una capa inteligente que acompaña el trabajo a través del sistema operativo.
Y ahí es donde la idea de un AI-native desktop deja de sonar como una interfaz futurista y empieza a parecer una arquitectura concreta.