 Capital de Tokens
Cuando una empresa empieza a experimentar con inteligencia artificial, una pregunta aparece casi de inmediato:
¿Cuánto cuesta un millón de tokens?
Es una pregunta útil. Permite comparar modelos, proveedores y configuraciones. Pero cuando la IA deja de ser un experimento y pasa a formar parte de procesos reales de negocio, esa pregunta empieza a quedarse pequeña.
Un artículo reciente de TechRadar Pro plantea precisamente ese cambio de perspectiva: detrás de cada token hay infraestructura física —cómputo, memoria, red, electricidad y refrigeración— y, a escala empresarial, esas decisiones terminan influyendo tanto en la economía del sistema como el precio publicado por el proveedor.
La idea puede resumirse así:
precio por token ≠ costo total de operar IAY con la llegada de los agentes de IA aparece una segunda complicación: una sola tarea humana puede disparar muchas inferencias, llamadas a herramientas, verificaciones y reintentos.
Por eso quizá la métrica más interesante no sea cuánto cuesta generar tokens, sino:
¿Cuánto cuesta completar correctamente una tarea de negocio?
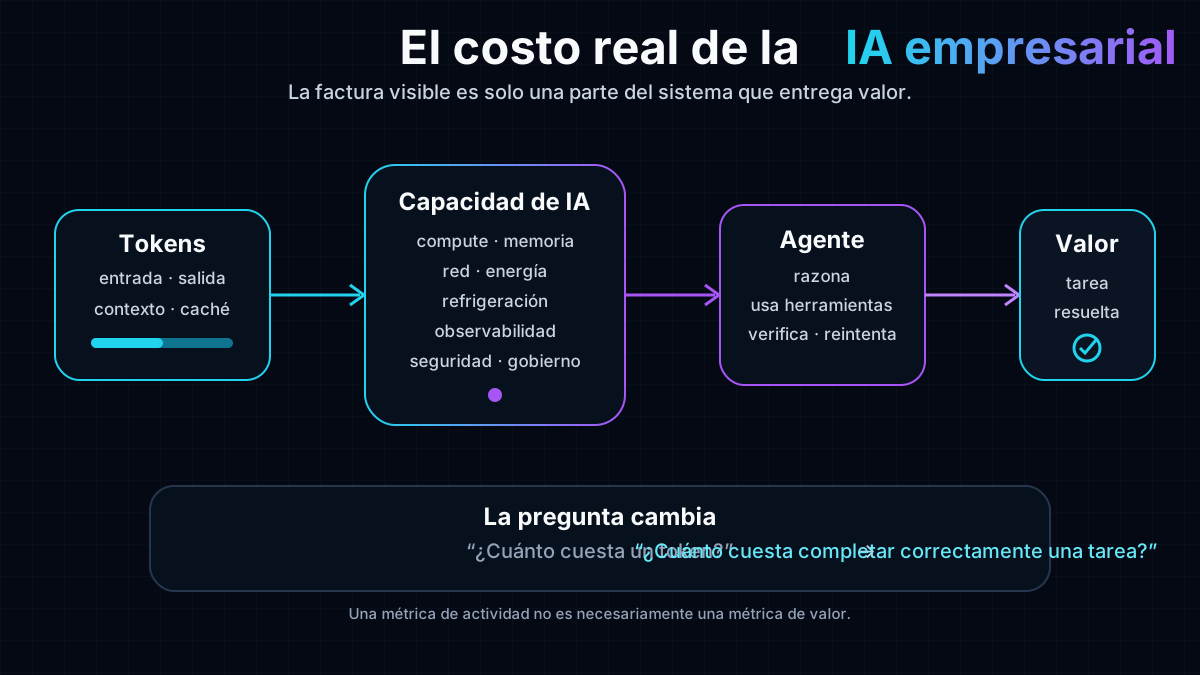
El token es una unidad de consumo, no una unidad de valor
Los modelos de lenguaje necesitan alguna forma de medir cuánto texto procesan y generan. Los tokens cumplen bien esa función.
Una factura de API puede aproximarse con algo como:
costo del modelo =
    tokens de entrada × tarifa de entrada
  + tokens de salida × tarifa de salida
Eso nos dice cuánto consumimos.
No nos dice cuánto valor obtuvimos.
Dos agentes pueden gastar exactamente la misma cantidad de tokens y producir resultados completamente diferentes:
Agente A
100 000 tokens
→ resuelve correctamente 95 tareas

Agente B
100 000 tokens
→ resuelve correctamente 45 tareas
Mirando únicamente tokens, ambos parecen equivalentes.
Mirando resultados, claramente no lo son.
Esta diferencia es importante porque las empresas no compran tokens por amor a los tokens. Los consumen para conseguir algo: responder clientes, analizar documentos, escribir software, investigar incidentes, procesar reclamaciones, detectar fraude o automatizar operaciones.
La unidad económica debería acercarse al resultado que realmente interesa.
La factura visible es solo la primera capa
Aunque una empresa utilice una API y nunca compre una GPU, cada interacción sigue dependiendo de infraestructura física en algún lugar.
Hay cómputo, memoria, red, almacenamiento, energía y refrigeración detrás de la respuesta.
Si además la empresa construye una plataforma de IA propia, aparecen otras capas operacionales:
modelo
+
infraestructura
+
plataforma
+
observabilidad
+
seguridad
+
gobierno
+
ingeniería
+
reintentos y fallos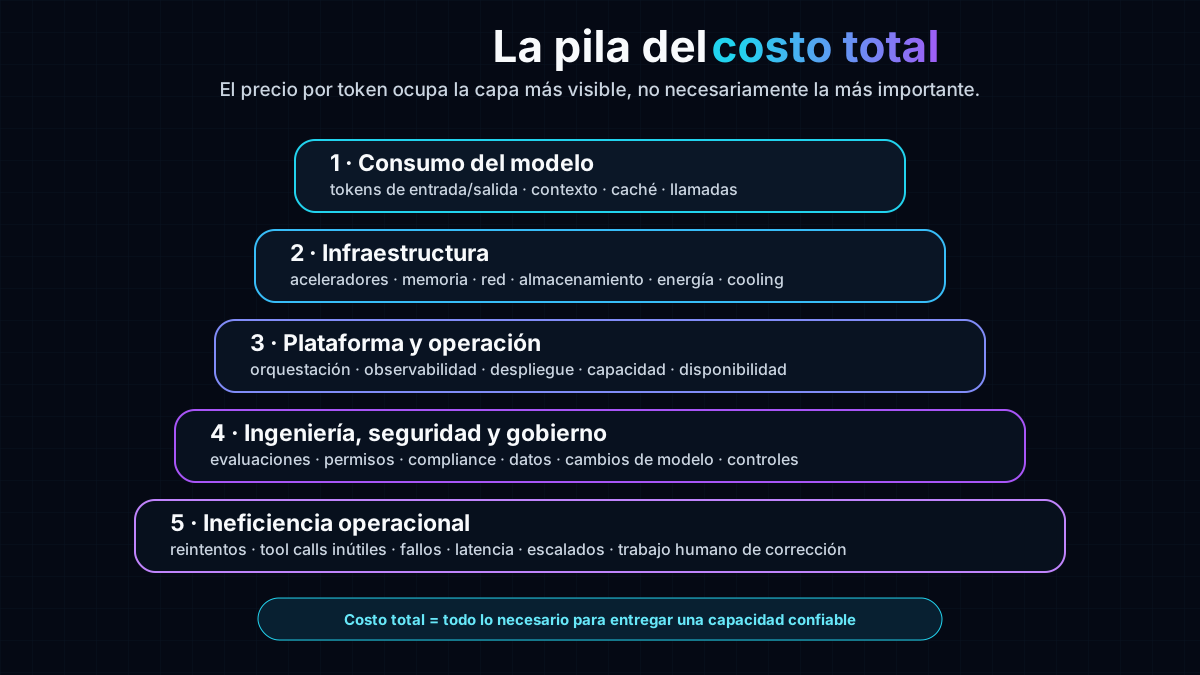
Podemos pensar el costo total de una capacidad de IA como una ecuación conceptual:
Costo total de IA =
    inferencia
  + infraestructura
  + energía y red
  + almacenamiento
  + plataforma
  + observabilidad
  + seguridad y gobierno
  + ingeniería
  + fallos, reintentos y correcciones
No todas las empresas pagan esas partidas directamente. En una API muchas están incorporadas dentro del precio del proveedor.
Pero económicamente siguen existiendo.
Esta distinción importa cuando el consumo crece hasta millones de solicitudes y cuando la IA se convierte en una dependencia crítica del negocio.
API por consumo: excelente cuando necesitamos elasticidad
El modelo de API tiene ventajas enormes.
Una empresa puede empezar sin comprar hardware, sin operar un clúster de aceleradores y sin dimensionar capacidad con meses de anticipación.
Para cargas experimentales o variables es especialmente atractivo:
poca demanda      → pagas poco
mucha demanda     → pagas más
cero demanda      → casi cero costo de inferencia
La infraestructura se convierte en un servicio.
Eso reduce la inversión inicial y permite cambiar de modelo rápidamente.
Por eso sería un error interpretar el debate como “API mala, infraestructura propia buena”.
La pregunta correcta es qué modelo económico encaja mejor con la carga real.
¿Cuándo empieza a ser interesante la capacidad dedicada?
Cuando una carga se vuelve muy grande, constante y predecible, la ecuación puede cambiar.
En vez de pagar una tarifa incremental por cada interacción, una organización puede estudiar si le conviene comprar o reservar capacidad de inferencia y mantenerla suficientemente utilizada.
Conceptualmente aparecen dos curvas diferentes:
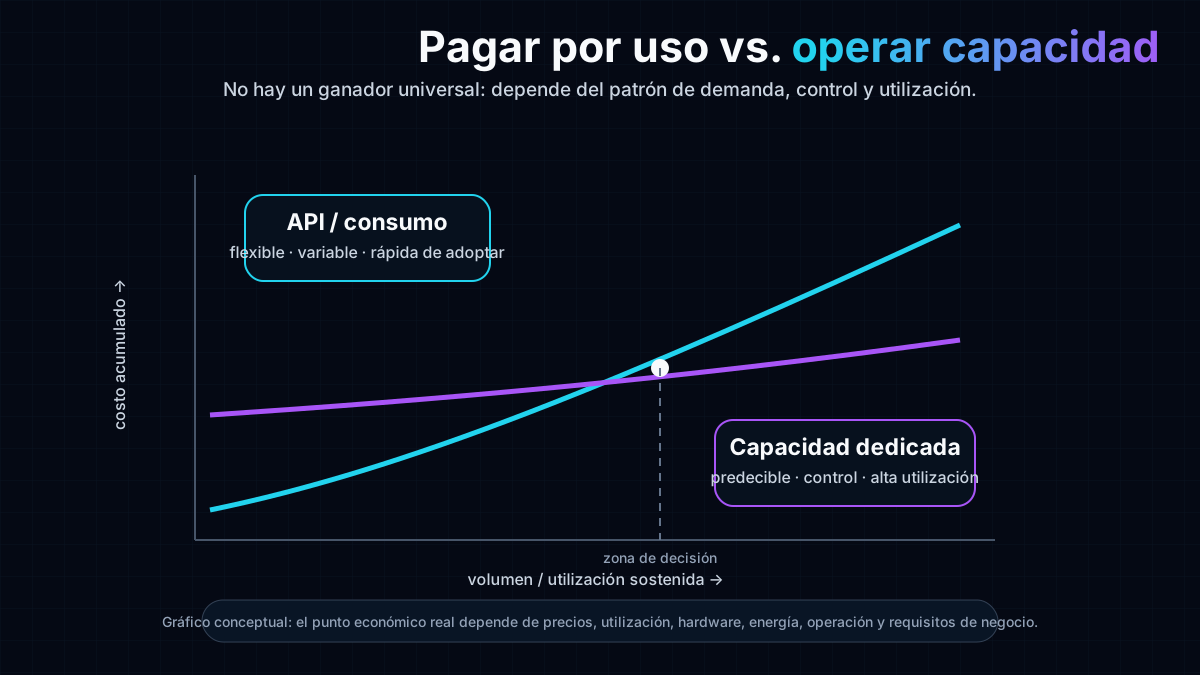
La API tiende a favorecer:
- experimentación;
- demanda irregular;
- crecimiento incierto;
- equipos que quieren minimizar operación de infraestructura;
- acceso rápido a modelos de frontera.
La capacidad dedicada puede resultar atractiva cuando existen:
- cargas sostenidas y previsibles;
- alta utilización del hardware;
- requisitos fuertes de residencia de datos;
- necesidades particulares de latencia;
- necesidad de controlar versiones y comportamiento;
- suficiente escala para amortizar infraestructura y operación.
El punto de equilibrio no es una cifra universal.
Depende del precio del modelo, hardware, utilización real, energía, refrigeración, salarios de operación, almacenamiento, red, disponibilidad requerida y muchos otros factores.
Por eso cualquier gráfico de “API vs. self-hosted” debe interpretarse como un modelo, no como una ley.
Los agentes cambian la economía todavía más
Un chatbot simple puede parecerse a esto:
pregunta
   ↓
modelo
   ↓
respuesta
Un agente puede parecerse más a esto:
objetivo
   ↓
razonamiento
   ↓
búsqueda
   ↓
resultado
   ↓
razonamiento
   ↓
tool call
   ↓
resultado
   ↓
verificación
   ↓
¿terminó?
  ↙   ↘
no     sí
↓       ↓
repite  respuesta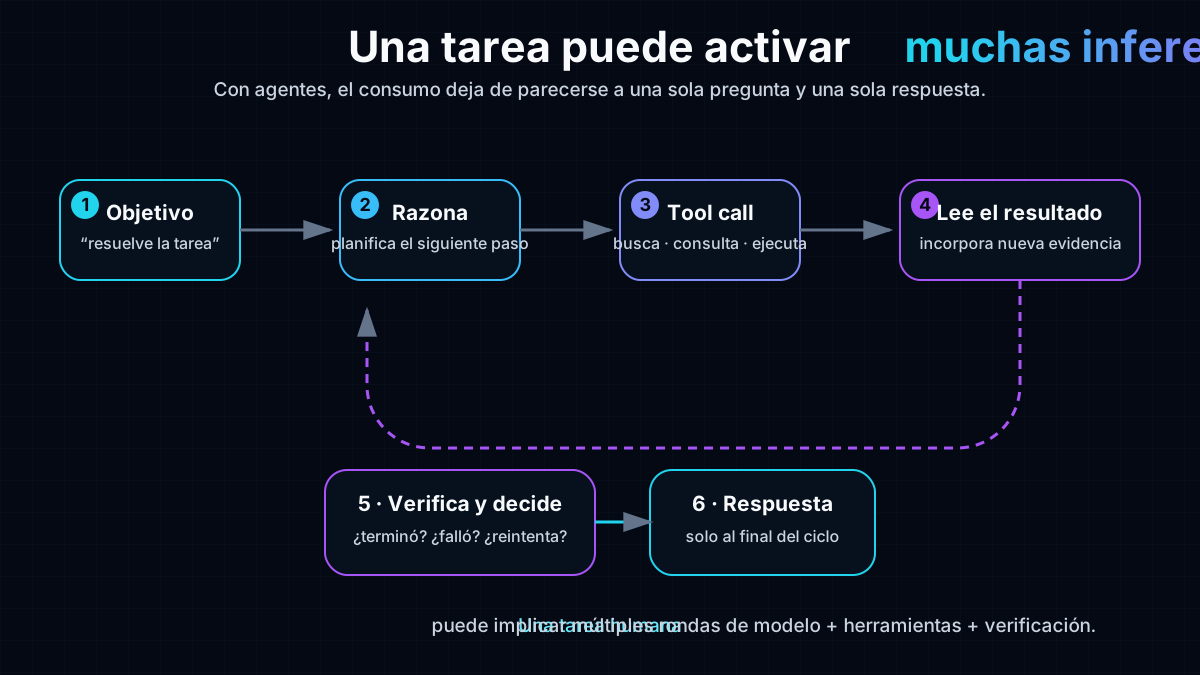
Cada vuelta puede incorporar más contexto y generar nuevos tokens.
Además pueden existir llamadas a servicios externos, navegadores, bases de datos, sandboxes, buscadores, almacenamiento o herramientas de ejecución.
De repente la economía de una tarea ya no depende únicamente de una inferencia.
Podemos modelarla de manera simplificada:
Costo de una tarea de agente =
    Σ inferencias
  + Σ tool calls
  + cómputo auxiliar
  + almacenamiento
  + tiempo de ejecución
  + reintentos
  + supervisión humana necesaria
Esto explica por qué un modelo con tokens más baratos no necesariamente produce el agente más barato.
Un modelo ligeramente más caro que necesite menos intentos puede terminar costando menos por tarea terminada.
Ejemplo: barato por token, caro por resultado
Imaginemos dos configuraciones ficticias para procesar 10 000 tareas.
Configuración A
Costo medio por intento:      $0.012
Intentos medios por tarea:    2.8
Tasa de éxito final:          90 %
Costo aproximado:
10 000 × 2.8 × $0.012 = $336Tareas exitosas:
10 000 × 90 % = 9 000Costo por tarea exitosa:
$336 / 9 000 ≈ $0.037Configuración B
Costo medio por intento:      $0.020
Intentos medios por tarea:    1.3
Tasa de éxito final:          97 %
Costo aproximado:
10 000 × 1.3 × $0.020 = $260Tareas exitosas:
10 000 × 97 % = 9 700Costo por tarea exitosa:
$260 / 9 700 ≈ $0.027La configuración B usa un intento más caro, pero termina siendo más barata por resultado útil.
Este ejemplo es deliberadamente hipotético. Su función no es recomendar un modelo concreto, sino mostrar por qué optimizar una sola tarifa puede llevarnos a la decisión equivocada.
Una métrica más útil: costo por tarea exitosa
Para un sistema de agentes podemos definir:
Costo por tarea exitosa =
    costo total del sistema
    ───────────────────────
    tareas completadas correctamente
El numerador debería incluir todo lo que sea material para esa operación.
Por ejemplo:
modelo
+ herramientas
+ infraestructura
+ ejecución
+ reintentos
+ almacenamiento
+ observabilidad
+ trabajo humano de corrección
El denominador tampoco debería ser simplemente “respuestas producidas”.
Tiene que medir resultados válidos.
En programación podría ser:
PR aceptados con CI verdeEn soporte:
casos resueltos sin reaperturaEn procesamiento documental:
documentos procesados que pasan validaciónEn un workflow financiero:
transacciones procesadas correctamente y sin intervención manualAsí conectamos economía con calidad.
Y todavía falta el valor del resultado
El costo por tarea exitosa mejora mucho la medición, pero sigue mirando solamente el lado del costo.
La siguiente capa es comparar ese costo con el valor económico producido.
Una versión simplificada sería:
ROI de IA =
    valor económico generado
    ────────────────────────
    costo total de la capacidad
Una automatización que cuesta $5 por tarea podría ser extraordinariamente rentable si reemplaza una operación de $100.
Otra que cuesta cinco centavos podría ser inútil si produce resultados que nadie necesita.
Por eso más consumo de IA no significa automáticamente más productividad.
El volumen de tokens puede crecer mientras el valor permanece plano.
Gobernar también cuesta
Hay además una dimensión que no aparece fácilmente en una tabla de precios: los modelos cambian.
Los proveedores actualizan infraestructura, políticas, versiones y, en algunos casos, el comportamiento observable de sus modelos.
Para una aplicación informal esto puede no representar un problema serio.
Para una empresa regulada o para un proceso crítico sí puede hacerlo.
La organización puede necesitar:
- evaluaciones regresivas;
- modelos o snapshots versionados;
- auditoría de prompts y tool calls;
- controles de acceso;
- políticas de datos;
- monitoreo de comportamiento;
- mecanismos de rollback;
- revisión humana en determinadas acciones.
Todo eso forma parte de operar IA de manera confiable.
Y todo eso tiene costo.
El verdadero cambio: de comprar tokens a operar capacidad
Durante la primera etapa de adopción era lógico hablar casi exclusivamente de modelos y tarifas.
La pregunta era:
¿Qué modelo es mejor y cuánto cuesta?A medida que la IA se integra en procesos reales, la pregunta madura:
¿Qué arquitectura entrega el resultado
con suficiente calidad, control y resiliencia
al menor costo total sostenible?
Eso obliga a mirar simultáneamente:
modelo
+
infraestructura
+
agentes
+
operación
+
gobierno
+
valor de negocio
El token sigue siendo importante.
Simplemente deja de ser el centro de la economía.
Qué debería medir un equipo de IA
En lugar de un dashboard limitado a tokens, una operación madura podría seguir métricas como:
| Métrica | Qué nos dice |
|---|---|
| Tokens por tarea | Intensidad de uso del modelo |
| Costo por intento | Precio de ejecutar una ronda |
| Intentos por tarea | Eficiencia del agente |
| Tool calls por tarea | Complejidad operacional |
| Tasa de éxito | Calidad real del sistema |
| Costo por tarea exitosa | Economía del resultado |
| Latencia por tarea | Experiencia y capacidad |
| Intervenciones humanas | Cuánta autonomía funciona de verdad |
| Valor estimado por tarea | Impacto económico |
| ROI | Si la capacidad genera más valor del que cuesta |
La conclusión es sencilla:
Los tokens miden actividad. Los resultados miden utilidad.
Y cuando la IA se convierte en infraestructura empresarial, conviene optimizar la segunda.
Fuente e inspiración
Este artículo parte de la tesis presentada en “We’re asking the wrong question about the cost of enterprise AI”, publicada en TechRadar Pro el 18 de agosto de 2026. La explicación, los ejemplos, las fórmulas conceptuales y la propuesta de medir costo por tarea exitosa son una elaboración didáctica propia a partir de ese tema.
Fuente original: TechRadar Pro — We’re asking the wrong question about the cost of enterprise AI