 Capital de Tokens
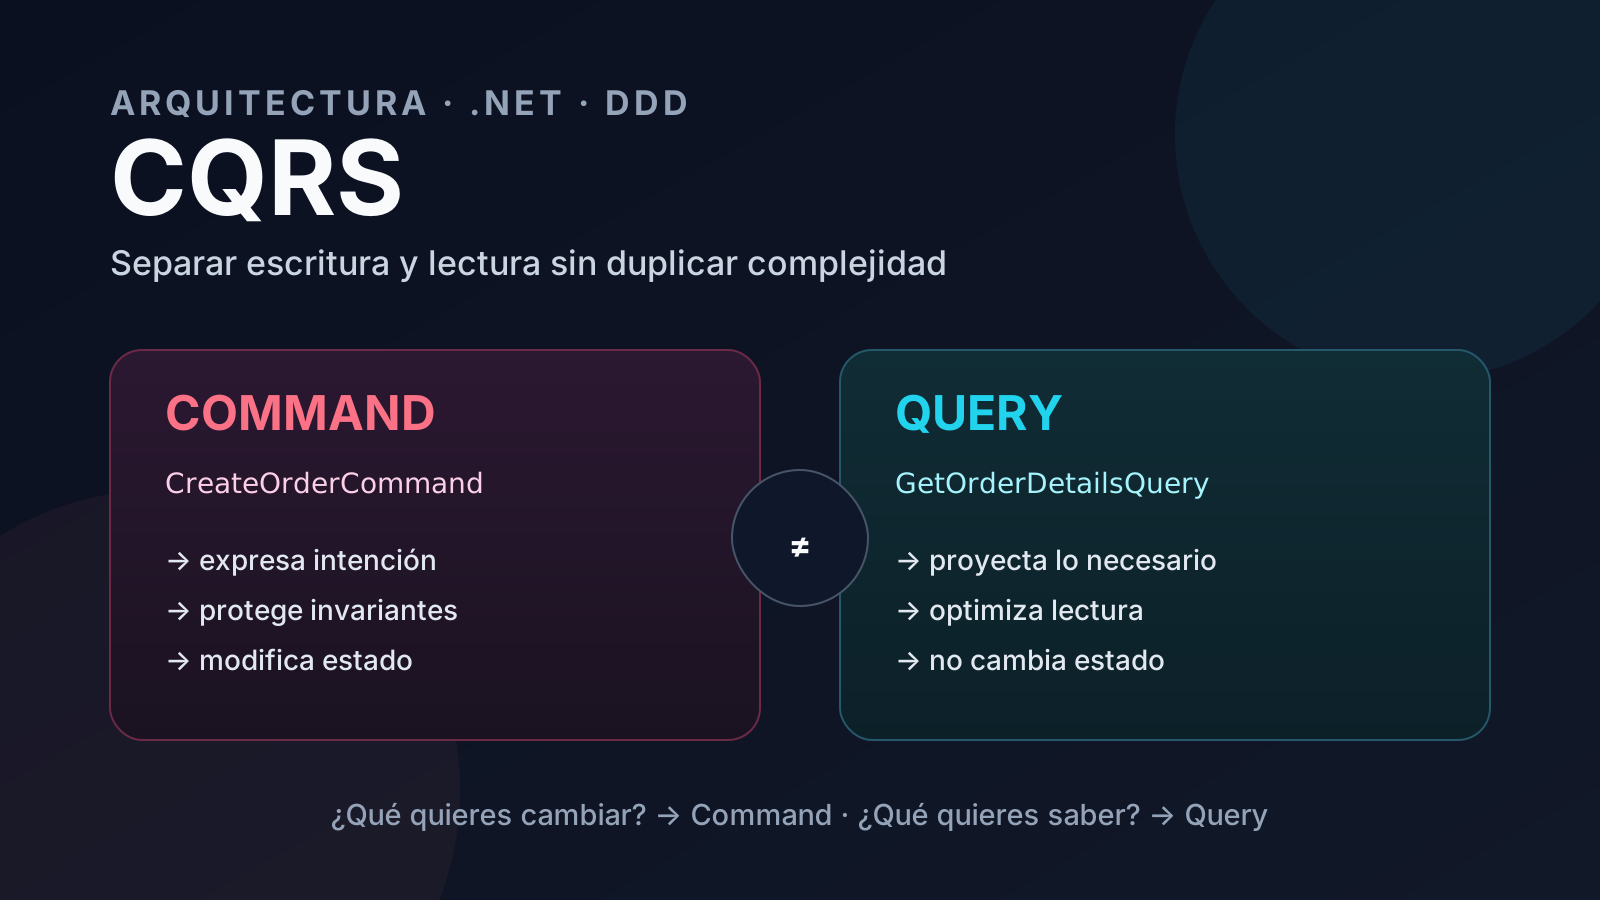
Una diapositiva típica de CQRS suele dibujar dos columnas:
- Command: modifica el estado, aplica reglas, valida y puede ser costoso.
- Query: no modifica el estado, devuelve datos rápido y evita la lógica de negocio del lado de escritura.
La idea general es correcta, pero tomada literalmente puede producir varios malentendidos.
Un command no tiene que ser pesado. Una query no significa “sin reglas”. CQRS no obliga a usar dos bases de datos. Tampoco implica Event Sourcing, microservicios ni un bus de mensajes.
La separación importante es mucho más simple:
un command expresa una intención de cambiar el sistema; una query describe información que queremos obtener sin cambiarlo.
Ese principio permite diseñar cada lado para un objetivo diferente.
El problema que CQRS intenta resolver
En una aplicación CRUD pequeña, usar el mismo modelo para leer y escribir suele ser perfectamente razonable.
Por ejemplo, una entidad Order podría servir para:
- crear una orden;
- cambiar su estado;
- agregar productos;
- calcular el total;
- mostrar una tabla de órdenes;
- construir un dashboard;
- exportar un reporte.
El problema aparece cuando esas necesidades empiezan a divergir.
El modelo de escritura necesita proteger invariantes y expresar comportamiento. El modelo de lectura quiere proyecciones simples, joins eficientes, filtros, agregaciones y DTOs preparados exactamente para cada pantalla.
Entonces una única abstracción empieza a recibir fuerzas opuestas.
CQRS propone separar esas responsabilidades.
Command: una intención de cambiar algo
Un command debería describir una acción del negocio:
public sealed record CreateOrderCommand(
    Guid CustomerId,
    IReadOnlyList<CreateOrderItem> Items);
No dice “actualiza estas columnas”. Dice “crea una orden”.
El handler puede entonces coordinar el caso de uso:
public sealed class CreateOrderHandler
{
    private readonly AppDbContext _db;

    public CreateOrderHandler(AppDbContext db)
    {
        _db = db;
    }

    public async Task<Guid> Handle(
        CreateOrderCommand command,
        CancellationToken cancellationToken)
    {
        var customerExists = await _db.Customers
            .AnyAsync(x => x.Id == command.CustomerId, cancellationToken);

        if (!customerExists)
            throw new InvalidOperationException("Customer does not exist.");

        var order = Order.Create(
            command.CustomerId,
            command.Items.Select(x => new OrderItemInput(
                x.ProductId,
                x.Quantity)));

        _db.Orders.Add(order);
        await _db.SaveChangesAsync(cancellationToken);

        return order.Id;
    }
}
Aquí sí tiene sentido encontrar:
- validación de entrada;
- autorización para modificar;
- reglas de negocio;
- invariantes del agregado;
- control transaccional;
- idempotencia;
- publicación de eventos;
- persistencia.
La parte importante no es que el command sea “heavy”. La parte importante es que el camino de escritura protege la validez del estado.
Un command trivial también puede ser perfectamente válido.
public sealed record RenameTagCommand(
    Guid TagId,
    string Name);
CQRS no exige complejidad: la separa cuando existe.
Query: obtener información sin cambiar el sistema
Una query modela una pregunta:
public sealed record GetOrderDetailsQuery(Guid OrderId);Su handler puede optimizarse directamente para devolver lo que necesita el consumidor:
public sealed class GetOrderDetailsHandler
{
    private readonly AppDbContext _db;

    public GetOrderDetailsHandler(AppDbContext db)
    {
        _db = db;
    }

    public Task<OrderDetailsDto?> Handle(
        GetOrderDetailsQuery query,
        CancellationToken cancellationToken)
    {
        return _db.Orders
            .AsNoTracking()
            .Where(x => x.Id == query.OrderId)
            .Select(x => new OrderDetailsDto(
                x.Id,
                x.Customer.Name,
                x.CreatedAt,
                x.Status,
                x.Items.Sum(i => i.Quantity * i.UnitPrice)))
            .SingleOrDefaultAsync(cancellationToken);
    }
}
Observa lo que no necesitamos hacer:
- cargar el agregado completo;
- ejecutar métodos de dominio;
- reconstruir objetos que después convertiremos a DTO;
- validar invariantes relacionadas con una modificación que no ocurrirá.
La query puede proyectar directamente desde la base de datos.
Eso suele simplificar muchísimo el read path.
“No rule checking” es una simplificación peligrosa
Algunas explicaciones de CQRS dicen que las queries no ejecutan reglas.
Eso necesita contexto.
Una query normalmente no necesita las invariantes de escritura, pero todavía puede necesitar:
- autenticación;
- autorización;
- aislamiento por tenant;
- filtros de seguridad;
- reglas de visibilidad;
- masking de datos;
- límites de paginación;
- controles de privacidad.
Por ejemplo:
if (!authorization.CanReadOrder(user, query.OrderId))
    throw new ForbiddenException();
Eso sigue siendo completamente compatible con CQRS.
La regla práctica es:
la query no debería cambiar estado ni ejecutar lógica destinada a decidir si un cambio de dominio es válido.
Seguridad y políticas de lectura siguen siendo necesarias.
Dos modelos no significa dos bases de datos
Ésta es probablemente la confusión más común.
Puedes empezar con CQRS usando exactamente la misma base de datos:
                 Application
                     |
          +----------+----------+
          |                     |
       Commands                Queries
          |                     |
     Write model             Read model
          |                     |
          +----------+----------+
                     |
                 PostgreSQL
La separación inicialmente puede existir solo en código:
- handlers diferentes;
- modelos diferentes;
- DTOs diferentes;
- rutas diferentes.
Eso ya proporciona buena parte del beneficio conceptual.
Si la carga de lectura crece muchísimo, más adelante puedes evolucionar hacia:
Commands -> Write DB
               |
             events
               |
               v
           Read model -> Read DB
Pero ésa es una decisión de infraestructura, no la definición de CQRS.
Microsoft describe precisamente CQRS como la separación de operaciones de lectura y escritura en modelos distintos, y señala que algunas implementaciones también separan físicamente los almacenes de datos.
CQRS tampoco significa Event Sourcing
CQRS y Event Sourcing se combinan con frecuencia porque encajan bien, pero resuelven problemas distintos.
CQRS pregunta:
¿debemos modelar lectura y escritura por separado?
Event Sourcing pregunta:
¿debemos persistir los cambios como una secuencia de eventos en lugar de guardar solamente el estado actual?
Puedes tener:
CQRS + base de datos relacional normal
CQRS + Event Sourcing
CRUD + base de datos relacional
No hay obligación de adoptar ambos patrones juntos.
De hecho, introducir Event Sourcing solo porque ya estás usando commands y queries puede aumentar mucho la complejidad operacional sin aportar valor.
El beneficio más importante: modelos optimizados para objetivos distintos
Supongamos que el modelo de dominio de una orden es:
Order
 ├─ Customer
 ├─ Items
 │   └─ Product
 ├─ Payments
 └─ ShippingAddress
Para modificarla, esa estructura puede ser útil porque representa relaciones, comportamiento e invariantes.
Pero una tabla administrativa quizás solo necesita:
public sealed record OrderRow(
    Guid Id,
    string Customer,
    decimal Total,
    string Status,
    DateTime CreatedAt);
La query puede producir exactamente ese objeto.
No necesitas convertir el read model en una copia del modelo de escritura.
Ésta es una de las ideas más potentes de CQRS:
el modelo óptimo para cambiar el sistema no tiene por qué ser el modelo óptimo para observarlo.
Una arquitectura CQRS mínima en .NET
Una aplicación puede empezar con algo tan pequeño como:
Application/
  Orders/
    Commands/
      CreateOrder/
        CreateOrderCommand.cs
        CreateOrderHandler.cs

    Queries/
      GetOrderDetails/
        GetOrderDetailsQuery.cs
        GetOrderDetailsHandler.cs
No hace falta instalar una biblioteca para “tener CQRS”.
MediatR u otras herramientas pueden ayudar con dispatching, pipelines y cross-cutting concerns, pero el patrón no depende de ellas.
Incluso puedes llamar directamente a los handlers desde el endpoint.
CQRS es una decisión de diseño, no una dependencia NuGet.
¿Debe un command devolver datos?
La regla estricta “commands nunca devuelven nada” tampoco es especialmente útil.
Es razonable que un command devuelva información necesaria para continuar el flujo, por ejemplo:
Guid orderId = await handler.Handle(command, ct);o incluso:
CreateOrderResult result = await handler.Handle(command, ct);Lo importante es no convertir el command handler en una segunda query compleja que reconstruye una enorme vista de lectura después de modificar el estado.
Un patrón común es:
POST /orders
     |
     v
CreateOrderCommand
     |
     v
returns OrderId
     |
     v
GET /orders/{id}
Eso mantiene clara la separación.
Consistencia eventual: solo cuando separas físicamente los modelos
Si command y query usan la misma base de datos dentro de la misma transacción, una lectura posterior puede observar el cambio inmediatamente.
Si introduces un read model separado actualizado mediante eventos:
Write DB
   |
 OrderCreated
   |
   v
Projection handler
   |
   v
Read DB
aparece una ventana donde el write model ya cambió pero el read model todavía no.
Eso es consistencia eventual.
No es un defecto accidental: es una propiedad que la aplicación debe diseñar explícitamente.
Puede requerir:
- indicadores de procesamiento;
- reintentos;
- idempotencia;
- versionado;
- monitoreo de proyecciones;
- estrategias de reparación.
Por eso pasar de CQRS lógico a CQRS distribuido no debería hacerse automáticamente.
Cuándo CQRS suele aportar valor
CQRS empieza a tener sentido cuando observas una diferencia real entre lectura y escritura:
- dominio con reglas e invariantes significativas;
- pantallas con consultas muy distintas al modelo de dominio;
- muchas más lecturas que escrituras;
- necesidades de escalado diferentes;
- dashboards o reportes con agregaciones complejas;
- múltiples representaciones de los mismos datos;
- workflows orientados a tareas en lugar de CRUD genérico.
En esos casos la separación puede reducir acoplamiento y permitir optimizar cada lado de forma independiente.
Cuándo probablemente no lo necesitas
Para un sistema CRUD pequeño:
Create
Read
Update
Delete
con reglas simples y consultas sencillas, añadir:
- command classes;
- query classes;
- handlers;
- buses;
- eventos;
- proyecciones;
- dos almacenes;
- consistencia eventual;
puede producir más arquitectura que dominio.
CQRS no debería usarse como una lista de carpetas que hay que copiar.
Debe responder a una asimetría real del sistema.
Una progresión razonable
En lugar de saltar directamente a la versión más compleja, puedes evolucionar por etapas.
Nivel 1: separar operaciones
Commands
Queries
Same DbContext
Same database
Nivel 2: separar modelos
Domain model para escritura
DTO/projections para lectura
Same database
Nivel 3: optimizar lectura
Read replicas
cache
materialized views
specialized indexes
Nivel 4: separar almacenamiento
Write DB
Read DB
events/projections
eventual consistency
Cada nivel debería aparecer porque existe una necesidad concreta.
La regla mental que vale la pena conservar
Si una operación responde a:
¿qué quieres que cambie?
probablemente es un command.
Si responde a:
¿qué quieres saber?
probablemente es una query.
Y si una query empieza a modificar estado o un command se convierte en una enorme consulta de presentación, probablemente las responsabilidades están empezando a mezclarse otra vez.
CQRS no consiste en duplicar arquitectura.
Consiste en permitir que escrituras y lecturas evolucionen según problemas diferentes.
Referencias
- Microsoft Azure Architecture Center — CQRS pattern: https://learn.microsoft.com/en-us/azure/architecture/patterns/cqrs
- Microsoft Azure Architecture Center — Event Sourcing pattern: https://learn.microsoft.com/en-us/azure/architecture/patterns/event-sourcing
- Martin Fowler — CQRS: https://martinfowler.com/bliki/CQRS.html