 Capital de Tokens
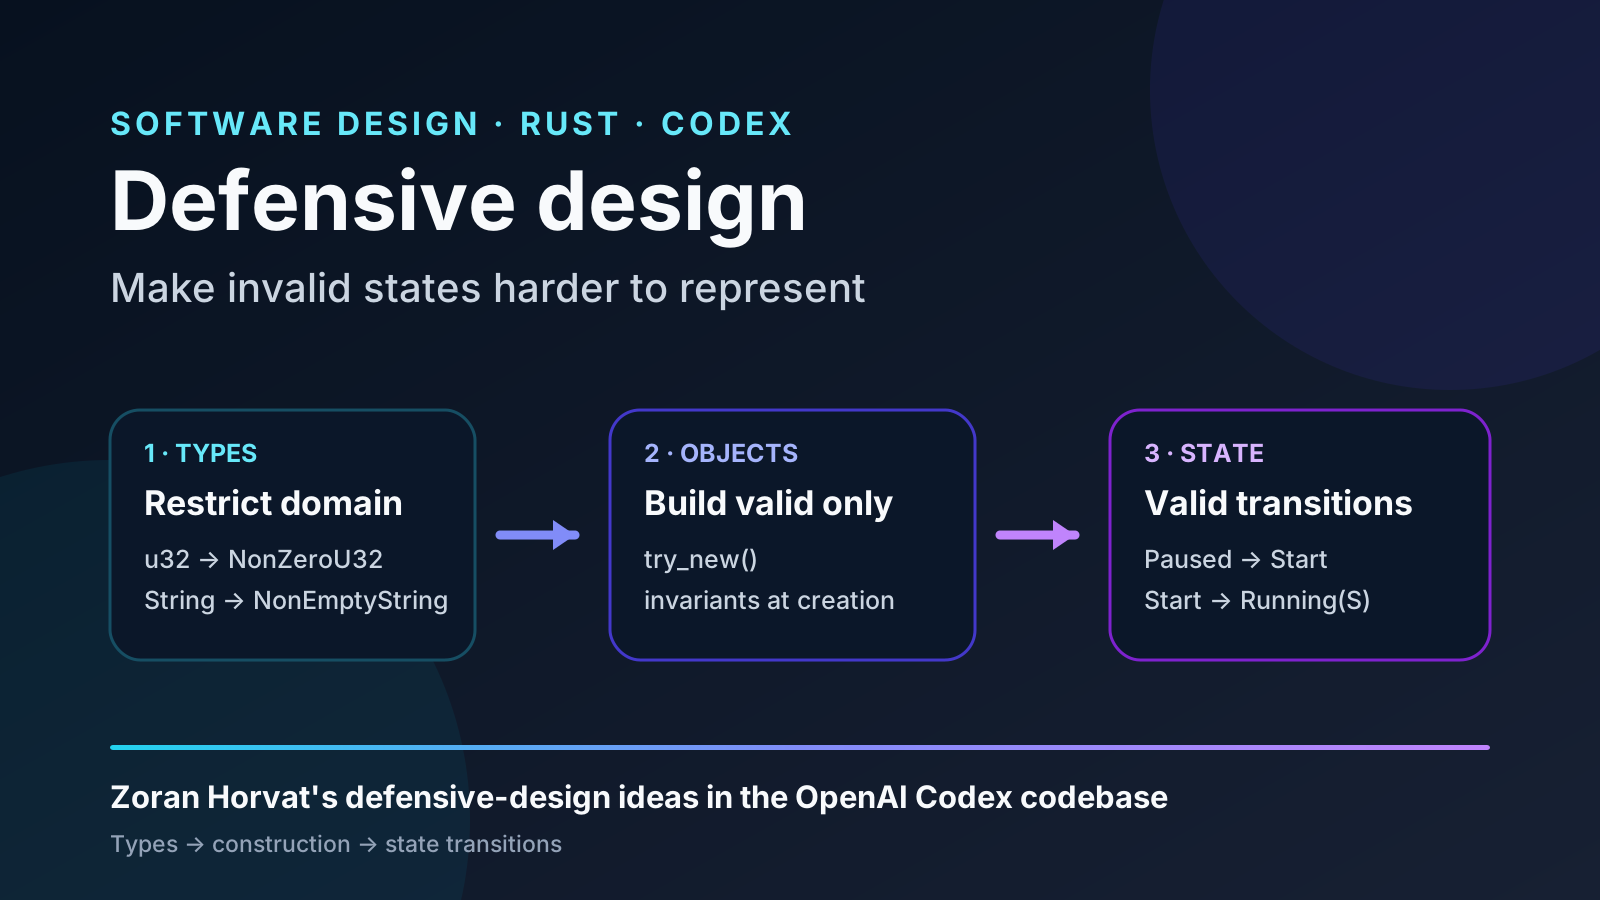
En Advanced Defensive Programming Techniques, Zoran Horvat propone una idea incómoda pero muy útil: el mejor código defensivo es el que puedes eliminar porque el diseño ya impide que el estado inválido llegue hasta allí.
La frase que abre el razonamiento del curso es contundente: “When you have to defend, you have already lost.” No significa que validar entrada externa sea innecesario. Significa que, dentro del sistema, repetir guard clauses para las mismas invariantes suele ser una señal de que esas invariantes no están representadas en el modelo.
El repositorio público de OpenAI Codex ofrece ejemplos muy buenos de esa filosofía aplicada en Rust. No hay evidencia de que el equipo de Codex estuviera siguiendo explícitamente el curso de Horvat; la comparación es conceptual. Pero los patrones encajan de forma sorprendentemente limpia con los módulos 2, 3 y 4.
Pluralsight describe el curso como un recorrido para sustituir defensive coding explícito por defensive design, y esos tres módulos avanzan precisamente así:
- entender los límites del defensive code tradicional;
- crear únicamente objetos consistentes;
- permitir únicamente transiciones de estado válidas.
Veamos cómo aparecen esas ideas en un codebase real.
1. Módulo 2: restringir el dominio antes de ejecutar la función
Una forma tradicional de escribir código defensivo es aceptar un tipo demasiado amplio y luego rechazar valores dentro de cada función.
Por ejemplo:
fn connect(protocol_version: u32) {
    if protocol_version == 0 {
        // error
    }

    // ...
}
El problema no es el if. El problema es que la función acepta un u32, aunque el dominio real sea “entero positivo distinto de cero”.
Codex modela ese dominio directamente:
pub struct ProtocolVersion(NonZeroU32);

impl ProtocolVersion {
    pub const V1: Self = Self(NonZeroU32::MIN);

    pub const fn new(value: u32) -> Option<Self> {
        match NonZeroU32::new(value) {
            Some(value) => Some(Self(value)),
            None => None,
        }
    }

    pub const fn get(self) -> u32 {
        self.0.get()
    }
}
Fuente: codex-rs/code-mode-protocol/src/host/types.rs.
Una función que recibe ProtocolVersion ya no necesita preguntarse si el valor es cero. Cero no se puede representar dentro de ese tipo.
Podemos verlo como una reducción explícita del dominio:
u32
┌─────────────────────────┐
│ 0  1  2  3  4 ...       │
└─────────────────────────┘
            │
            │ ProtocolVersion::new
            ▼
ProtocolVersion
┌─────────────────────────┐
│    1  2  3  4 ...       │
└─────────────────────────┘
Eso cambia la responsabilidad. La validación ocurre una vez, en la frontera donde el dato se convierte al tipo del dominio. El resto del sistema trabaja con una garantía más fuerte.
NonEmptyString: otra frontera explícita
En el mismo archivo, Codex define:
struct NonEmptyString(String);

impl NonEmptyString {
    fn new(value: impl Into<String>) -> Result<Self, InvalidIdentifier> {
        let value = value.into();

        if value.trim().is_empty() {
            Err(InvalidIdentifier)
        } else {
            Ok(Self(value))
        }
    }
}
Y después lo reutiliza:
pub struct Capability(NonEmptyString);
pub struct SessionId(NonEmptyString);
A partir de ahí, una función que recibe un SessionId no tiene que repetir:
if id.is_empty() { ... }
if id.trim().is_empty() { ... }
La invariante forma parte del tipo.
Este es uno de los puntos más importantes de Horvat: el dominio de una función debería expresar qué valores son realmente aceptables, no simplemente qué representación primitiva resulta cómoda.
2. Módulo 3: construir únicamente objetos consistentes
Reducir el dominio de valores individuales ayuda, pero un objeto puede seguir siendo inválido por la combinación de varios valores.
Aquí entra el siguiente paso: si una instancia existe, debería satisfacer sus invariantes.
Codex tiene un ejemplo especialmente claro:
pub struct CapabilitySet(BTreeSet<Capability>);

impl CapabilitySet {
    pub fn try_new(
        capabilities: impl IntoIterator<Item = Capability>,
    ) -> Result<Self, DuplicateCapability> {
        let mut unique = BTreeSet::new();

        for capability in capabilities {
            if !unique.insert(capability.clone()) {
                return Err(DuplicateCapability { capability });
            }
        }

        Ok(Self(unique))
    }
}
El detalle decisivo es que el BTreeSet interno está encapsulado. El consumidor no recibe una bolsa arbitraria y después tiene que recordar comprobar duplicados. Tiene que pasar por la operación de construcción.
El flujo es:
datos potencialmente inconsistentes
              │
              ▼
           try_new
          /       \
         /         \
      error      objeto válido
                    │
                    ▼
             CapabilitySet
Después de construirlo, el resto del programa puede operar sobre una garantía.
Varias invariantes en un solo tipo
SupportedProtocolVersions hace algo todavía más interesante:
pub struct SupportedProtocolVersions(BTreeSet<ProtocolVersion>);

impl SupportedProtocolVersions {
    pub fn try_new(
        versions: impl IntoIterator<Item = ProtocolVersion>,
    ) -> Result<Self, InvalidSupportedProtocolVersions> {
        let mut unique = BTreeSet::new();

        for version in versions {
            if !unique.insert(version) {
                return Err(
                    InvalidSupportedProtocolVersions::Duplicate(version)
                );
            }
        }

        if unique.is_empty() {
            return Err(InvalidSupportedProtocolVersions::Empty);
        }

        Ok(Self(unique))
    }
}
Ese constructor establece al menos dos invariantes:
- no hay versiones duplicadas;
- el conjunto no está vacío.
Por tanto:
[]       → inválido
[1, 1]   → inválido
[1, 2]   → válido
Una vez existe un SupportedProtocolVersions, un consumidor no debería necesitar un if versions.is_empty() para protegerse de un objeto que nunca debió existir.
PluginStore: consistencia basada en paths
El patrón aparece también en PluginStore:
pub struct PluginStore {
    codex_home: AbsolutePathBuf,
    root: AbsolutePathBuf,
    data_root: AbsolutePathBuf,
}
Su try_new convierte y valida los paths antes de construir el objeto:
pub fn try_new(codex_home: PathBuf) -> Result<Self, PluginStoreError> {
    let root =
        AbsolutePathBuf::from_absolute_path_checked(
            codex_home.join(PLUGINS_CACHE_DIR)
        )
        .map_err(|err| {
            PluginStoreError::io("failed to resolve plugin cache root", err)
        })?;

    let data_root =
        AbsolutePathBuf::from_absolute_path_checked(
            codex_home.join(PLUGINS_DATA_DIR)
        )
        .map_err(|err| {
            PluginStoreError::io("failed to resolve plugin data root", err)
        })?;

    let codex_home =
        AbsolutePathBuf::from_absolute_path_checked(codex_home)
            .map_err(|err| {
                PluginStoreError::io("failed to resolve Codex home", err)
            })?;

    Ok(Self {
        codex_home,
        root,
        data_root,
    })
}
Fuente: codex-rs/core-plugins/src/store.rs.
Si tienes un PluginStore, sus roots ya son AbsolutePathBuf. El diseño evita que cada método vuelva a preguntar si el path es absoluto.
3. Módulo 4: modelar estados válidos, no combinaciones de flags
El tercer salto ocurre cuando el objeto cambia con el tiempo.
Supongamos que un event broker pudiera modelarse así:
struct EventBroker {
    paused: bool,
    needs_start: bool,
    source: Option<EventSource>,
}
Ahora tenemos combinaciones ambiguas:
paused = true
needs_start = true
source = Some(...)

¿qué estado representa esto?
También podríamos tener:
paused = false
needs_start = false
source = None
La representación permite estados que el dominio quizá no quiere admitir.
Codex evita ese problema con un enum:
enum EventBrokerState<S: EventSource> {
    Paused,
    Start,
    Running(S),
}
Fuente: codex-rs/tui/src/tui/event_stream.rs.
Ahora el estado solo puede ser una de tres cosas:
Paused
  │
  │ resume
  ▼
Start
  │
  │ first poll
  ▼
Running(S)
  │
  │ pause
  └──────────────→ Paused
Y Running lleva consigo exactamente el dato que solo tiene sentido en ese estado: S, el event source.
La transición Start → Running está centralizada:
fn active_event_source_mut(&mut self) -> Option<&mut S> {
    match self {
        EventBrokerState::Paused => None,

        EventBrokerState::Start => {
            *self = EventBrokerState::Running(S::default());

            match self {
                EventBrokerState::Running(events) => Some(events),
                EventBrokerState::Paused | EventBrokerState::Start =>
                    unreachable!(),
            }
        }

        EventBrokerState::Running(events) => Some(events),
    }
}
Y las operaciones públicas realizan transiciones explícitas:
pub fn pause_events(&self) {
    // ...
    *state = EventBrokerState::Paused;
}

pub fn resume_events(&self) {
    // ...
    *state = EventBrokerState::Start;
}
Esta técnica elimina una clase completa de defensive code: el destinado a reconciliar flags y campos opcionales que se contradicen entre sí.
La progresión completa: de if a diseño
Los tres módulos pueden entenderse como una progresión:
1. VALORES
   restringe el dominio
        ↓
   ProtocolVersion(NonZeroU32)
   NonEmptyString

2. OBJETOS
   construye solo instancias consistentes
        ↓
   CapabilitySet::try_new()
   SupportedProtocolVersions::try_new()
   PluginStore::try_new()

3. ESTADO EN EL TIEMPO
   representa únicamente estados válidos
        ↓
   EventBrokerState
      ├── Paused
      ├── Start
      └── Running(S)
El patrón subyacente es el mismo:
menos:
if invalid { ... }
if invalid { ... }
if impossible { ... }

más:
tipos → construcción → estados → transiciones
No desaparece toda validación. Se mueve hacia fronteras mejor definidas.
Los datos externos siguen necesitando parsing y validación. Pero una vez convertidos en tipos internos fuertes, no deberíamos obligar a todas las capas del sistema a volver a descubrir las mismas invariantes.
Por qué Rust hace esta idea especialmente visible
Estas técnicas no pertenecen a Rust. Pueden aplicarse en C#, Java, Kotlin, TypeScript, F#, Swift y muchos otros lenguajes.
Pero Rust las hace particularmente visibles porque ofrece herramientas muy naturales para expresar el modelo:
- newtypes como
ProtocolVersion(NonZeroU32); Option<T>para ausencia explícita;Result<T, E>para construcción fallible;- enums con datos asociados;
- pattern matching exhaustivo;
- privacidad de campos para preservar invariantes.
El objetivo no es “usar más tipos” por estética. Es conseguir que el compilador y la estructura del programa carguen con parte del trabajo que, de otro modo, recaería en comprobaciones repetidas durante runtime.
Cómo aplicar el mismo criterio en C#
Aunque Horvat enseña buena parte de estas ideas desde el ecosistema .NET, hoy C# tiene herramientas cada vez mejores para expresarlas.
Por ejemplo, en lugar de:
void Connect(int protocolVersion)
{
    if (protocolVersion <= 0)
        throw new ArgumentOutOfRangeException();
}
podemos introducir un value object:
public sealed record ProtocolVersion
{
    public int Value { get; }

    private ProtocolVersion(int value) => Value = value;

    public static ProtocolVersion? TryCreate(int value) =>
        value > 0 ? new ProtocolVersion(value) : null;
}
La creación inválida queda representada como null en la frontera. El consumidor debe resolver esa posibilidad antes de entrar al código de dominio:
var version = ProtocolVersion.TryCreate(rawVersion);

if (version is null)
    return;

Connect(version);
Después de esa comprobación, las funciones que reciben un ProtocolVersion no necesitan defenderse de cero o negativos. El estado por defecto del tipo de referencia sigue siendo null, pero ya no existe una instancia ProtocolVersion con Value == 0.
Y para estados mutuamente exclusivos, discriminated unions —nativas o simuladas mediante jerarquías cerradas— permiten reemplazar combinaciones de booleanos y nullables por alternativas explícitas.
Una regla práctica para code review
Una pregunta muy útil durante revisión de código es:
¿Este guard clause protege una frontera real o está compensando un modelo demasiado permisivo?
Si valida JSON, input de usuario, configuración o una respuesta remota, probablemente está en una frontera legítima.
Pero si diez métodos internos comprueban una y otra vez que el mismo identificador no está vacío, que el mismo path es absoluto o que dos flags no se contradicen, quizá la solución no sea añadir el undécimo if.
Quizá el sistema necesita un tipo mejor.
Conclusión
El valor del enfoque de Horvat no está en prohibir el defensive programming. Está en cambiar dónde ocurre.
El código de Codex muestra muy bien tres niveles de esa idea:
ProtocolVersionyNonEmptyStringreducen el dominio de valores;CapabilitySet,SupportedProtocolVersionsyPluginStorehacen que la construcción establezca invariantes;EventBrokerStateconvierte combinaciones implícitas de estado en alternativas explícitas.
La consecuencia es importante: muchas comprobaciones dejan de ser necesarias no porque ignoremos los errores, sino porque el diseño hace que esos errores sean más difíciles —o directamente imposibles— de representar.
Ese es el salto de defensive coding a defensive design.
Referencias
- Zoran Horvat, Advanced Defensive Programming Techniques — Pluralsight.
- OpenAI, Codex — repositorio público.
- OpenAI Codex, protocol host types.
- OpenAI Codex, PluginStore.
- OpenAI Codex, TUI event state.