 Capital de Tokens
La expresión recursive self-improvement suele evocar una imagen extrema: un modelo que modifica sus propios pesos, se vuelve más inteligente y repite el proceso una y otra vez.
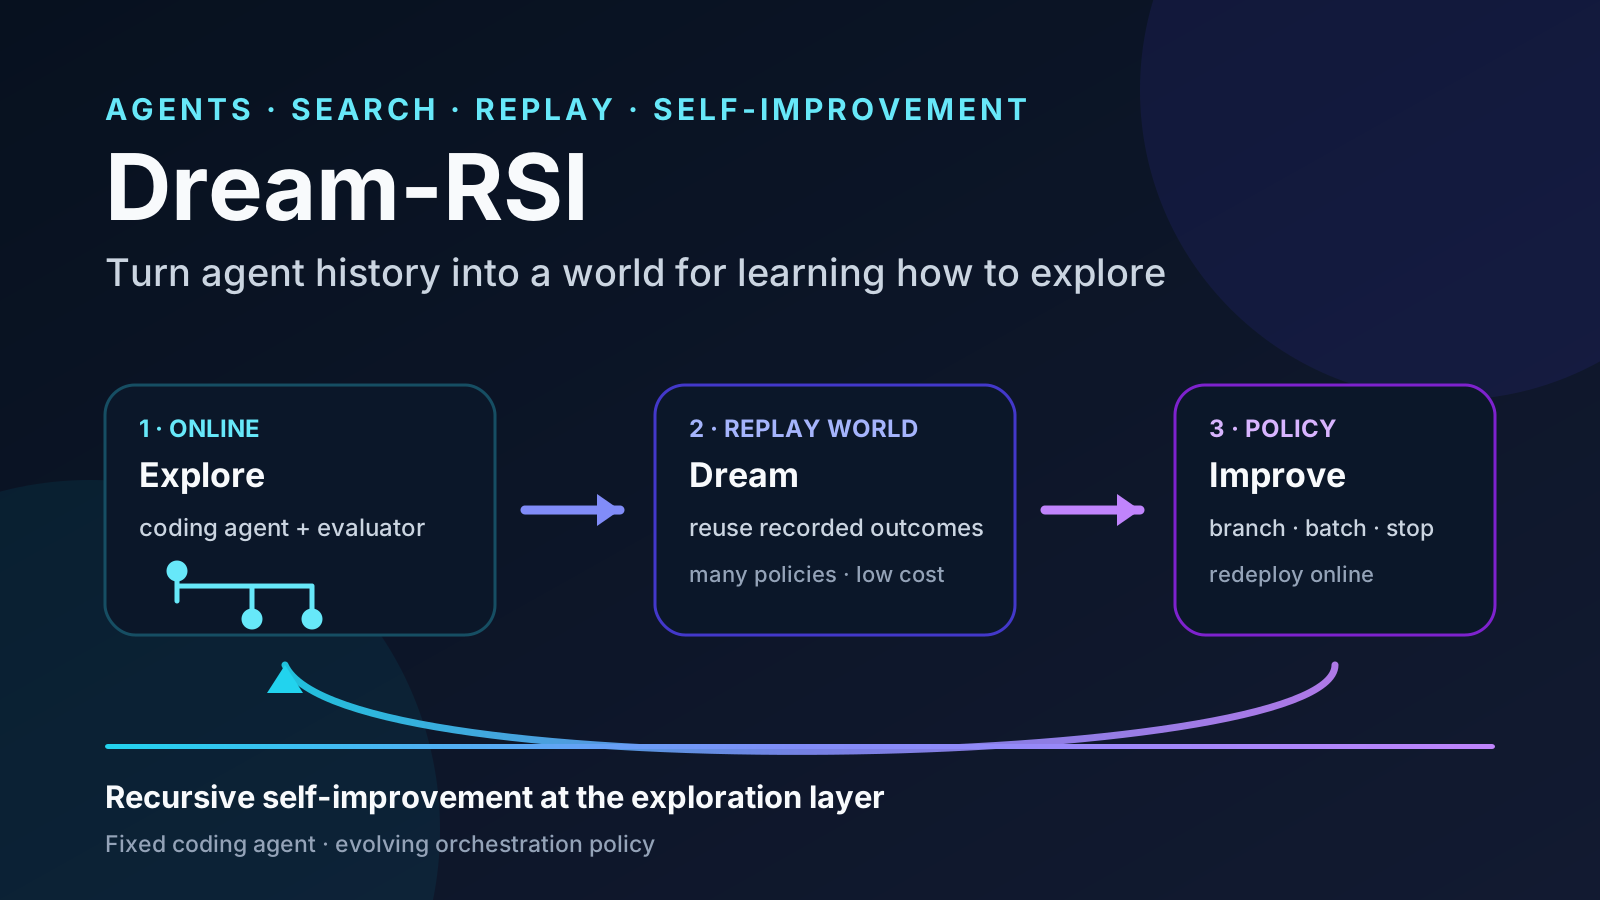
Dream-RSI propone algo bastante más concreto —y probablemente más útil para los sistemas de agentes que ya podemos construir hoy—: dejar fijo el coding agent y mejorar recursivamente la política que decide cómo explorar.
El paper, Dream-RSI: Recursive Self-Improvement through Evolving Worlds, parte de una observación sencilla. Cuando un agente lleva cientos o miles de intentos resolviendo un problema, deja detrás un historial muy rico: ramas exploradas, implementaciones fallidas, soluciones prometedoras, evaluaciones, costes y decisiones de cuándo seguir o abandonar una dirección.
Normalmente ese historial se usa como memoria o contexto.
Dream-RSI hace algo diferente:
convierte el historial de descubrimiento en un simulador de replay donde es posible probar estrategias de exploración nuevas sin volver a ejecutar el costoso agente subyacente.
La consecuencia es importante. El sistema puede gastar mucho menos cómputo real probando políticas de búsqueda y reservar las ejecuciones caras para las estrategias que parecen mejores.
El problema no es solo generar buenas soluciones
Muchos sistemas de descubrimiento con LLM siguen un ciclo parecido a este:
proponer
   ↓
ejecutar
   ↓
evaluar
   ↓
refinar
   ↓
repetir
A medida que el horizonte crece, aparece otro problema: ¿dónde gastar el siguiente intento?
Un sistema puede tener varias ramas abiertas al mismo tiempo:
root
├── enfoque A
│   ├── A1
│   └── A2
├── enfoque B
│   ├── B1
│   └── B2
└── enfoque C
    └── C1
La siguiente llamada al agente podría refinar A2, reparar B1, abrir una rama nueva, explorar C1, lanzar varias opciones en paralelo o detenerse.
Ese problema es distinto al de generar código. Es un problema de orquestación de búsqueda.
Dream-RSI hace explícita esa capa y la convierte en una política programable.
Qué componente se auto-mejora
Una de las partes más importantes del paper es lo que no cambia.
Durante el proceso permanecen fijos:
- el coding agent;
- el evaluador;
- las interfaces de ejecución;
- el mecanismo que ejecuta y puntúa cada intento.
Lo que se modifica es el código de la exploration policy.
Conceptualmente:
def exploration_policy(tree):
    return nodes_to_continue
La política observa el árbol descubierto hasta el momento y decide qué ramas continuar, si abrir ramas nuevas, cuántos intentos lanzar en paralelo y cuándo detener la búsqueda.
Eso coloca la mejora recursiva en el harness, no en los pesos del modelo.
De historial a “mundo”
Supongamos que una ejecución real produjo este árbol:
root
├── A → score 0.61
│   ├── A1 → 0.74
│   │   └── A2 → 0.78
│   └── A3 → error de compilación
├── B → 0.55
│   └── B1 → 0.49
└── C → 0.69
    └── C1 → 0.82
Cada nodo conserva más que un score. Puede incluir el workspace, el artefacto generado, errores, diagnósticos y observaciones del evaluador.
Después de completar esa exploración, Dream-RSI congela el árbol y lo trata como un mundo reutilizable.
Una política alternativa puede “jugar” sobre ese árbol:
Política 1:
root → A → A1 → A2

Política 2:
root → C → C1

Política 3:
root → A + C en paralelo
Como los resultados ya existen, la simulación no necesita volver a llamar al coding agent ni ejecutar de nuevo el evaluator. Simplemente revela los resultados históricos que corresponderían a la trayectoria seleccionada.
El paper llama a esto dreaming.
La analogía con los world models es directa: en lugar de interactuar siempre con el mundo caro, el agente practica decisiones dentro de una representación del entorno.
Aquí el “world model” no intenta predecir resultados nuevos. Es más conservador: reproduce únicamente regiones del espacio que ya fueron exploradas.
El bucle completo
Dream-RSI organiza el proceso en tres fases:
1. ONLINE EXPLORATION
   política actual
        ↓
   coding agent + evaluator
        ↓
   discovery tree

2. REPLAY WORLD
   discovery tree
        ↓
   simulador histórico

3. DREAMING
   muchas políticas candidatas
        ↓
   replay barato
        ↓
   seleccionar política mejor
        ↓
   volver a producción
La política mejorada se usa en la siguiente ejecución real. Esa ejecución produce un nuevo árbol, que se añade al conjunto de simuladores disponibles.
Por eso el proceso es recursivo: cada ronda real genera experiencia que permite mejorar la estrategia que gobernará la ronda siguiente.
Qué optimiza la política
El objetivo no premia simplemente encontrar el score más alto.
La función de evaluación combina tres elementos:
valor =
    mejor calidad encontrada
    - coste de exploración
    + bonificación por paralelismo útil
El paper penaliza el número de generaciones representadas por la trayectoria y recompensa políticas capaces de agrupar buenos intentos en lotes paralelos.
Esto evita una solución trivial como “explora absolutamente todo”.
Una buena política debe descubrir soluciones fuertes gastando menos llamadas y aprovechando correctamente los workers disponibles.
El resultado más claro: Lasso
En una tarea de ingeniería algorítmica, los autores usan agentes para descubrir implementaciones eficientes del Lasso regularization path.
Con Gemini 3.1 Pro:
| Método | Agent calls | Runtime medio |
|---|---|---|
| Recursive Fixed Exploration | 550 | 3587.1 ms |
| Dream-RSI | 317 | 2931.0 ms |
Dream-RSI usa aproximadamente 1.7× menos llamadas que la política fija y al mismo tiempo produce un solver más rápido.
Con Gemini 3.7 Flash:
| Método | Agent calls | Runtime medio |
|---|---|---|
| Recursive Fixed Exploration | 3200 | 2516.7 ms |
| Dream-RSI | 1879 | 2350.6 ms |
La comparación con SimpleTES es todavía más llamativa: SimpleTES reporta 51,200 generaciones, mientras Dream-RSI logra resultados competitivos con órdenes de magnitud menos llamadas.
También funciona fuera del código tradicional
Los autores prueban la misma idea en ocho tareas repartidas entre tres dominios.
Optimización matemática
En Sum–Difference, Dream-RSI obtiene 1.145427, por encima de los métodos comparados en esa tabla.
En Circle Packing alcanza 2.635983, igualando el mejor resultado reportado entre los métodos comparados.
En Autocorrelation queda competitivo, aunque no consigue el mejor score. Esta distinción importa: el paper no demuestra superioridad universal.
Kernels GPU
Sobre tareas de KernelBench:
- VGG16 alcanza rendimiento comparable usando 2.43× menos generaciones;
- LayerNorm usa 1.79× menos generaciones;
- ConvDiv logra hasta 2.09× más rendimiento con presupuesto comparable;
- ConvMax mejora 1.44× bajo un presupuesto parecido.
Aquí la mejora no viene de hacer más inteligente al modelo base, sino de asignar mejor el presupuesto de exploración.
Una observación contraintuitiva: meter la memoria en el prompt puede empeorar la búsqueda
Una alternativa natural sería resumir el historial:
“Estas estrategias funcionaron antes. Sigue por aquí.”
Los autores prueban una variante de ese enfoque, inyectando direcciones históricas como guidance semántico en el prompt.
El resultado es peor que usar el historial como simulador interactivo bajo presupuestos equivalentes.
La explicación propuesta es interesante: en búsqueda de largo horizonte, una guía demasiado explícita puede imponer un sesgo prematuro y hacer que muchas ramas converjan hacia las mismas ideas.
La diferencia puede resumirse así:
MEMORIA COMO PROMPT

historial
   ↓
"esto funcionó antes"
   ↓
agent
   ↓
nueva generación


HISTORIAL COMO SIMULADOR

historial
   ↓
replay world
   ↓
muchas políticas hipotéticas
   ↓
seleccionar estrategia
   ↓
agent
No se trata solo de recordar mejor. Se trata de aprender cómo usar el presupuesto de búsqueda.
Un fallo de implementación no significa que la idea sea mala
El prompt de desarrollo de políticas incluido por los autores contiene una regla especialmente útil para coding agents: un fallo local de implementación no demuestra por sí solo que la dirección padre sea mala.
La política debe reconstruir la trayectoria completa de una rama antes de cerrarla.
Por ejemplo:
idea prometedora
   ↓
implementación 1
   ↓
shape mismatch
   ↓
¿abandonar?
Dream-RSI intenta distinguir entre:
dirección algorítmica mala
        vs.
implementación reparable
El paper trata como normalmente reparables errores de output/correctness mismatch, límites de shared memory o recursos, variables o código, máscaras, layout y shapes.
Esto importa porque un orchestrator demasiado ingenuo puede matar buenas ideas simplemente porque su primer intento no compiló.
Cómo se vería en un sistema de coding agents
Imaginemos un agente autónomo trabajando en un issue real.
Hoy el harness podría usar reglas estáticas:
if tests_failed:
    retry()

if ci_green:
    open_pr()
Con una capa inspirada en Dream-RSI, el sistema guardaría cada trayectoria:
Issue #431
├── branch A
│   ├── tests fail: import
│   ├── fix import
│   └── 98% tests pass
├── branch B
│   ├── architectural rewrite
│   └── performance regression
└── branch C
    ├── minimal patch
    └── all tests pass
Después podría evaluar offline distintas políticas de decisión:
- cuándo reparar una rama;
- cuándo abrir otra;
- cuántos workers dedicar;
- cuánto insistir antes de abandonar;
- cuándo explotar una solución buena;
- cuándo volver a explorar.
El sistema no necesita reejecutar cada PR histórico para contestar esas preguntas. El historial ya contiene gran parte de las consecuencias observadas.
Eso convierte logs, tests y árboles de ejecución en algo más poderoso que memoria: datos de entrenamiento para el orchestrator.
Las limitaciones que conviene no perder de vista
Dream-RSI es prometedor, pero hay fronteras importantes.
1. El replay solo conoce el mundo observado
El simulador puede revelar resultados que ya existen en el árbol. No puede responder con fidelidad qué habría pasado con una idea completamente nueva que nunca apareció.
Por tanto, no es un simulador generativo completo del espacio de búsqueda.
2. Mejor replay score no garantiza mejor ejecución futura
El paper selecciona políticas según su rendimiento promedio sobre mundos históricos.
Eso garantiza que la política elegida no sea peor en ese conjunto de replay, según el objetivo definido. No equivale a garantizar que generalizará perfectamente a una tarea nueva o a una región nunca observada.
3. La calidad depende del historial disponible
Si las primeras rondas exploran mal y producen árboles pobres, el simulador también tendrá cobertura pobre.
El loop necesita seguir regresando al mundo real para expandir su experiencia.
4. Los resultados son de dominios estructurados
Las evaluaciones se realizan en ingeniería algorítmica, optimización matemática y kernels GPU, donde existe un evaluator relativamente claro y automático.
Aplicarlo a tareas abiertas —arquitectura, producto, debugging ambiguo o decisiones humanas— exige diseñar señales de evaluación mucho más cuidadosas.
Por qué importa para la ingeniería de agentes
En muchos sistemas actuales, el LLM recibe toda la atención y el harness se trata como infraestructura secundaria.
Dream-RSI invierte esa intuición.
Un agente puede mejorar significativamente sin cambiar el modelo base si aprende mejor:
- dónde explorar;
- cuándo insistir;
- cuándo reparar;
- cuándo abandonar;
- cuándo paralelizar;
- cuándo detenerse.
Eso sugiere una dirección práctica:
modelo fijo
   +
harness observable
   +
historial estructurado
   +
evaluadores reproducibles
   +
política de búsqueda evolutiva
   =
agente que aprende a gastar mejor su cómputo
La idea más valiosa de Dream-RSI quizá no sea el término recursive self-improvement.
Es esta:
el historial de tus agentes no tiene por qué ser solo memoria; puede convertirse en el entorno donde aprenden a orquestarse mejor.
Para equipos que ya ejecutan agentes de código, CI, benchmarks y múltiples workers, esa idea es inmediatamente accionable.