 Capital de Tokens
Los agentes de voz tradicionales suelen construirse como una cadena de componentes separados:
micrófono
   ↓
speech-to-text
   ↓
LLM
   ↓
text-to-speech
   ↓
altavoz
Ese diseño funciona, pero obliga al desarrollador a coordinar buffers, detección de turnos, cancelaciones, latencia, sincronización de contexto y el caso especialmente incómodo en el que el usuario empieza a hablar mientras el sistema todavía está respondiendo.
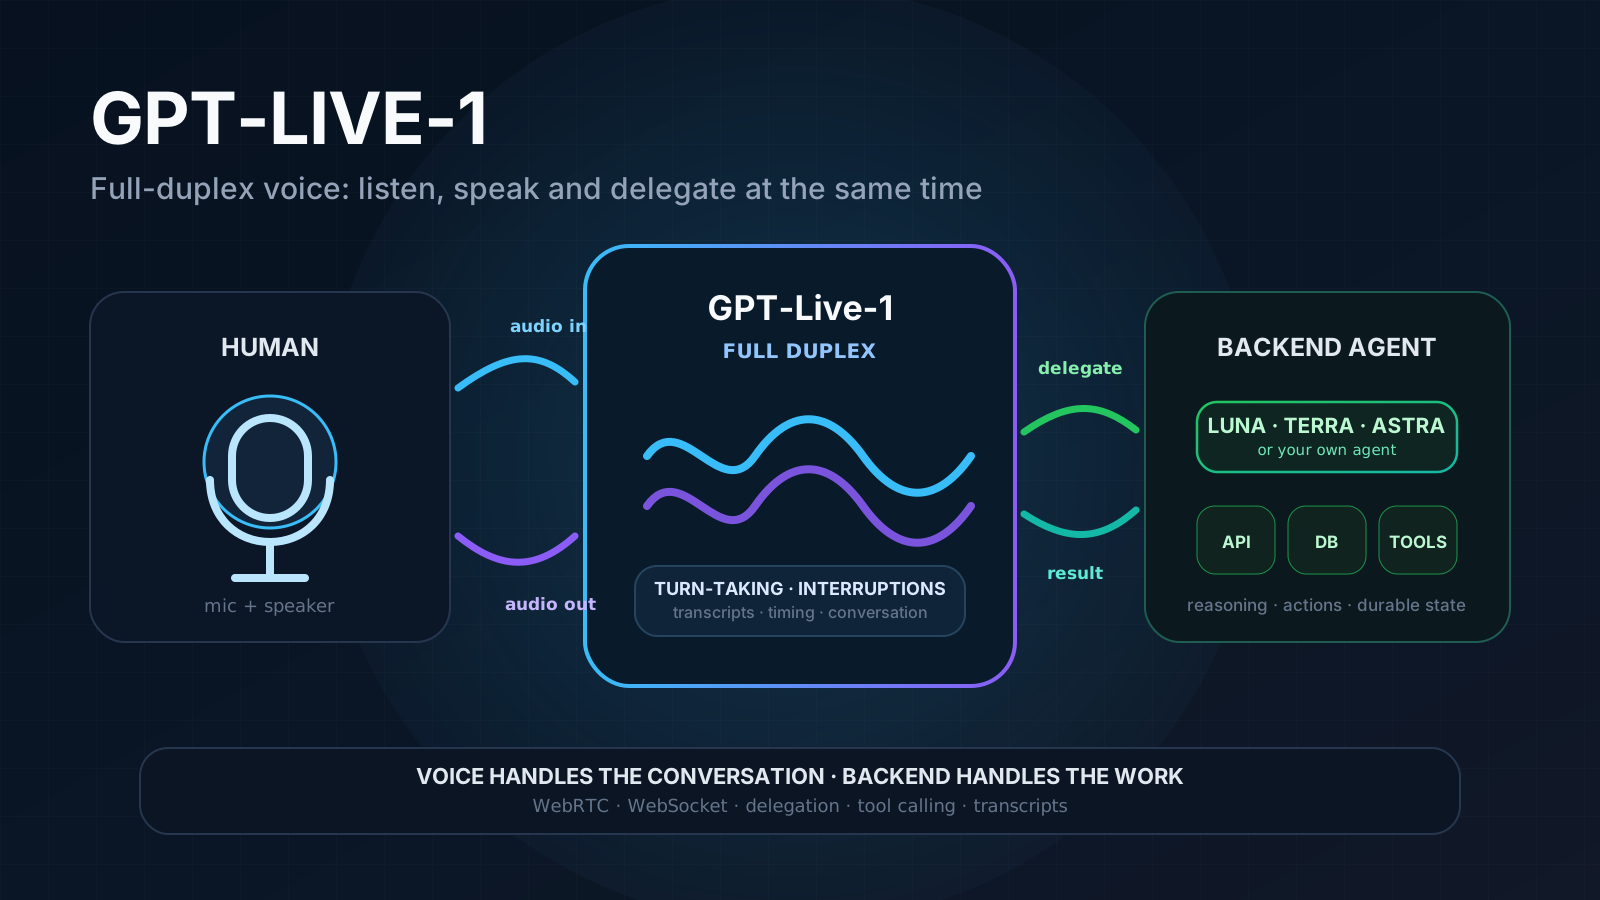
Con GPT-Live-1, OpenAI lleva a la API un modelo de voz full-duplex: puede procesar audio de entrada mientras genera audio de salida. El cambio importante no es solamente una voz más natural. Es una arquitectura distinta para aplicaciones conversacionales.
OpenAI lanzó GPT-Live-1 en la API el 10 de septiembre de 2026 y lo separó conceptualmente en dos capas:
usuario
  ⇅ audio
GPT-Live-1
  │
  ├─ conversación, ritmo, interrupciones y turn-taking
  │
  └─ delegación
       ↓
backend de razonamiento / agente / herramientas
La voz deja de tener que ser también todo el “cerebro” del agente.
Full-duplex: escuchar mientras se habla
En un pipeline cascada, una respuesta normalmente se produce después de varios pasos secuenciales. Cada transición añade latencia y cada componente necesita saber cuándo empieza y termina un turno.
GPT-Live-1 procesa continuamente la interacción. Eso permite manejar mejor:
- interrupciones;
- pausas largas;
- correcciones a mitad de frase;
- pequeños acknowledgements como “sí” o “mmm”;
- ruido de fondo;
- cambios de intención mientras el sistema está hablando.
Según OpenAI, el modelo mejora en 30 puntos porcentuales frente a GPT-Realtime-2.1 en Full Duplex Bench. En sus mediciones también reporta una latencia de respuesta de alrededor de 0,798 segundos frente a 1,41 segundos del modelo anterior.
La diferencia práctica es que parte de la lógica que antes teníamos que implementar en la aplicación pasa a estar dentro del propio modelo de interacción.
La arquitectura recomendada: voz delante, razonamiento detrás
GPT-Live-1 puede delegar trabajo complejo a otro modelo o agente mientras mantiene la conversación.
Una arquitectura típica puede verse así:
                   ┌──────────────────┐
micrófono ────────▶│                  │──────▶ altavoz
                   │    GPT-Live-1    │
                   │                  │
                   └────────┬─────────┘
                            │ delegation
                            ▼
                   ┌──────────────────┐
                   │ backend agent    │
                   │ Luna / Terra /   │
                   │ Astra / externo  │
                   └────────┬─────────┘
                            │
                     tools / APIs / DB
Esto permite usar un backend barato y rápido para tareas rutinarias y escalar a un modelo más potente cuando la petición requiere razonamiento complejo.
Por ejemplo:
"¿Dónde está mi pedido?"
        ↓
GPT-Live-1 mantiene la conversación
        ↓
backend consulta la API de pedidos
        ↓
resultado verificado
        ↓
GPT-Live-1 lo comunica por voz
Si el usuario añade “ah, y cámbialo para recogerlo en tienda” mientras el backend todavía trabaja, la conversación no tiene que congelarse.
Dos formas de delegar
La API ofrece dos patrones principales.
1. Responses delegation
Es la opción más gestionada. GPT-Live-1 prepara la solicitud al backend, suministra contexto de conversación y recibe el resultado.
Una configuración simplificada puede verse así:
const session = {
  model: "gpt-live-1",
  delegation: {
    type: "responses",
    responses: {
      model: "gpt-5.6-terra",
      instructions: "Resuelve la tarea y devuelve solo información verificada."
    }
  }
};
El modelo de voz y el modelo de razonamiento se eligen de forma independiente.
Para cargas de alto volumen puede tener sentido usar Luna; para tareas más complejas, Terra o Astra, dependiendo de calidad, coste y latencia.
2. Client delegation
Aquí la aplicación controla completamente el backend.
const session = {
  model: "gpt-live-1",
  delegation: {
    type: "client"
  }
};
Cuando GPT-Live-1 necesita ayuda, emite un evento session.delegation.created. La aplicación conserva el identificador de delegación, ejecuta su agente y devuelve el resultado después.
Conceptualmente:
async function onDelegation(event) {
  const id = event.delegation.id;

  const context = buildContextFromTranscripts();
  const result = await runMyAgent(context);

  live.send({
    type: "session.commentary.append",
    delegation_id: id,
    content: result
  });
}
Esta opción es especialmente interesante si ya tienes un agente propio, un workflow multi-modelo, un sistema RAG, microservicios internos o incluso un proveedor de modelos distinto.
Un detalle crítico: el evento de delegación no contiene toda la tarea
Con client delegation, no conviene asumir que session.delegation.created incluye el texto exacto de lo que dijo el usuario.
La aplicación debe mantener su propio contexto usando los transcripts y su estado interno.
GPT-Live expone eventos como:
session.input_transcript.delta
session.output_transcript.delta
session.delegation.created
Los eventos de transcript incluyen fragmentos y timestamps. Eso permite reconstruir contexto como:
usuario: "resérvame para el jueves"
usuario: "no, espera, mejor el viernes"
El backend necesita recibir la intención final, no ejecutar ciegamente el primer fragmento.
WebRTC para navegador
Para una aplicación web, OpenAI recomienda WebRTC.
La separación es útil:
browser
 ├─ media track → audio
 └─ data channel → eventos JSON
El navegador captura el micrófono y reproduce audio directamente mediante el canal multimedia. Los eventos de control viajan por un data channel.
El secreto de API no debe vivir en el navegador. El patrón correcto es:
browser
   ↓ solicita sesión
backend confiable
   ↓ usa OPENAI_API_KEY
OpenAI
Tu servidor crea o negocia la sesión y el cliente recibe únicamente lo necesario para establecer la conexión.
Eso reduce el riesgo de exponer credenciales en JavaScript distribuido al usuario.
WebSocket para integraciones server-side
Cuando el audio llega desde otro servicio —por ejemplo telefonía, un gateway, un bot o una aplicación backend— WebSocket suele ser más natural.
PBX / Twilio / backend
        ↓
     WebSocket
        ↓
    GPT-Live-1
En este modo el socket principal puede transportar tanto audio como eventos de control.
OpenAI también soporta conexiones sideband para que un backend observe y controle una sesión sin tener que mover el audio por esa misma conexión.
Telefonía
GPT-Live-1 incluye soporte orientado a llamadas telefónicas y OpenAI documenta caminos de integración con proveedores como Twilio, Telnyx, LiveKit y Daily/Pipecat.
Eso abre casos bastante directos:
- reservas;
- soporte al cliente;
- seguimiento de pedidos;
- recepción virtual;
- help desks;
- asistentes que escalan a un humano.
La ventaja del full-duplex es especialmente visible por teléfono, donde el patrón rígido “habla → espera → escucha” se siente artificial muy rápido.
Tool calling: el backend sigue siendo el lugar donde ejecutar acciones
GPT-Live-1 puede disparar trabajo delegado, pero las operaciones sensibles siguen perteneciendo a la aplicación.
Por ejemplo, un backend podría declarar una función:
change_reservation(date, party_size)Cuando el modelo solicita esa función, la aplicación debería:
1. validar argumentos
2. comprobar permisos
3. pedir confirmación si la acción es sensible
4. ejecutar la API real
5. devolver un resultado estructurado
6. continuar la respuesta
En Responses delegation, los resultados de funciones se envían como function_call_output y después se continúa explícitamente el trabajo con response.create.
Eso importa porque “el modelo pidió una herramienta” y “la acción fue autorizada” no son la misma cosa.
Interrumpir la voz no cancela automáticamente el backend
Este es uno de los detalles más fáciles de pasar por alto.
Supongamos:
usuario: "cancela mi vuelo"
        ↓
backend empieza a trabajar
        ↓
usuario: "¡no, espera!"
Interrumpir el audio no significa necesariamente que el workflow ya iniciado haya sido cancelado.
OpenAI deja explícitamente el estado durable y las políticas de ejecución en manos de la aplicación.
Por eso conviene implementar tareas con estados claros:
requested
  ↓
awaiting_confirmation
  ↓
approved
  ↓
executing
  ↓
completed
Y reservar una cancelación real del backend para una transición explícita del workflow.
thinking versus commentary
Con client delegation, el backend puede devolver información al modelo de dos maneras interesantes.
session.thinking.append añade contexto para el razonamiento del modelo sin implicar que ese contenido deba pronunciarse.
session.commentary.append añade un resultado pensado para incorporarse a la conversación hablada.
Esto permite separar:
estado interno / datos auxiliares
          ↓
       thinking

resultado que debe comunicar
          ↓
      commentary
Es una distinción muy útil para evitar que un agente verbalice logs, IDs internos o razonamientos operativos que el usuario no necesita escuchar.
Prompt corto delante, reglas complejas detrás
OpenAI recomienda mantener el prompt del modelo de voz relativamente enfocado en la interacción:
- tono
- ritmo
- cuándo delegar
- cuándo pedir aclaración
- cómo manejar silencios
Mientras que las reglas de negocio extensas deberían vivir en el backend:
- políticas de devolución
- autorización
- límites de compra
- acceso a bases de datos
- workflows de herramientas
- validaciones
Es una separación arquitectónica sana porque evita convertir el prompt conversacional en un manual de operaciones gigante.
Observabilidad: conserva transcript, delegación y resultado
Una implementación seria debería correlacionar al menos:
session_id
transcript timestamps
delegation_id
backend request
herramientas ejecutadas
resultado
respuesta hablada final
El punto importante es que “backend completado” no significa automáticamente “usuario escuchó el resultado”. El trabajo delegado y el audio siguen ciclos independientes.
Para auditoría, conviene observar ambos.
Coste
GPT-Live-1 cuesta 0,05 USD por minuto para la capa de voz, facturado por segundo.
Eso equivale aproximadamente a:
10 minutos   → $0.50
30 minutos   → $1.50
60 minutos   → $3.00
1.000 horas  → $3.000
A eso hay que sumar el modelo backend y las herramientas utilizadas.
Esa separación también crea una oportunidad de optimización: no todo turno necesita Astra. Un router puede usar Luna para operaciones simples y escalar únicamente las tareas difíciles.
Un patrón de producción razonable
Una arquitectura completa podría terminar así:
                        ┌───────────────┐
                        │   navegador   │
                        │ mic + speaker │
                        └───────┬───────┘
                                │ WebRTC
                                ▼
                        ┌───────────────┐
                        │  GPT-Live-1   │
                        │ full-duplex   │
                        └───────┬───────┘
                                │ delegation
               ┌────────────────┴────────────────┐
               ▼                                 ▼
        backend rápido                    backend complejo
         GPT-5.6 Luna                     Terra / Astra
               │                                 │
               └──────────────┬──────────────────┘
                              ▼
                       policy / auth layer
                              ▼
                     APIs · DB · MCP · tools
                              │
                              ▼
                      durable task state
La capa de políticas debería seguir siendo externa al modelo. El modelo puede proponer una acción; la aplicación decide si está permitida.
Qué desaparece y qué no
El titular de que GPT-Live-1 “mata” el pipeline cascada es útil, pero incompleto.
Sí reduce drásticamente la necesidad de coordinar manualmente:
STT → LLM → TTSPero no elimina:
- autorización;
- estado durable;
- manejo de errores;
- tool execution;
- observabilidad;
- persistencia;
- políticas de seguridad;
- routing entre modelos.
En realidad, simplifica la capa conversacional y deja más visible la verdadera arquitectura del agente.
La idea más importante
GPT-Live-1 convierte la voz en una interfaz continua delante de un sistema agentic.
El patrón deja de ser:
voz → texto → chatbot → texto → vozY pasa a parecerse más a:
humano ⇄ interfaz de voz inteligente ⇄ agente ⇄ herramientasEse cambio es más profundo que una mejora de TTS. Permite que el modelo que conversa sea distinto del modelo que razona, que el trabajo continúe mientras hablamos y que la aplicación mantenga el control real de permisos y acciones.
Para los desarrolladores, probablemente esa separación entre interacción en tiempo real y trabajo agentic sea la parte más importante de GPT-Live-1.
Fuentes
- OpenAI — Build more natural voice experiences with GPT-Live-1 in the API
- OpenAI API — Getting started with GPT-Live
- OpenAI API — Delegation and tools in GPT-Live