 Capital de Tokens
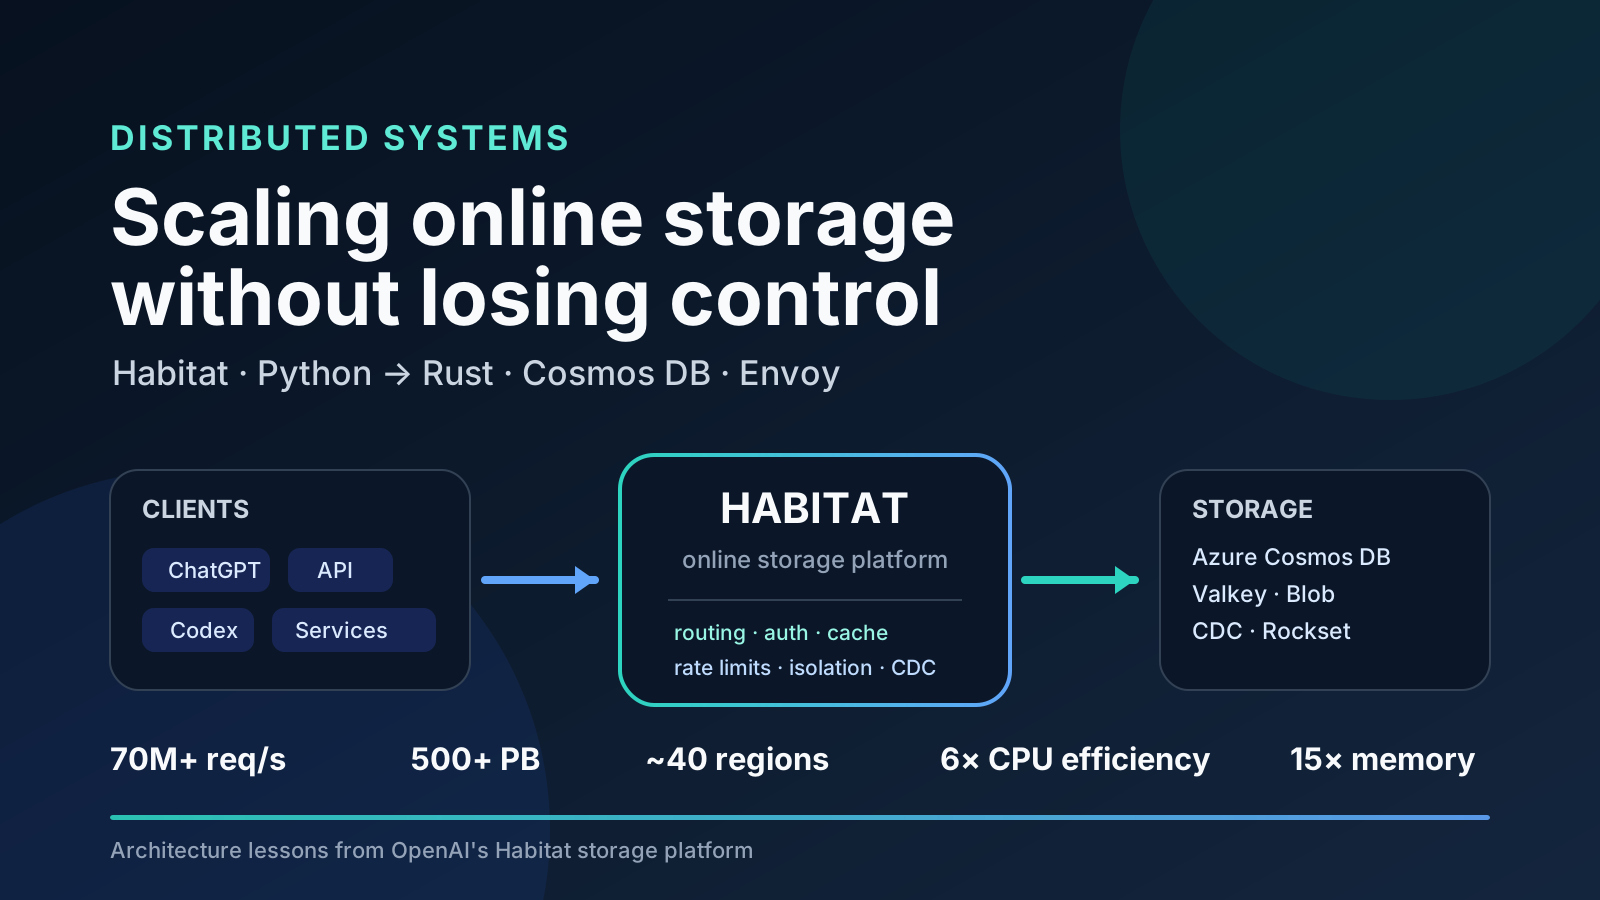
OpenAI publicó un caso de estudio especialmente útil para quienes construyen servicios de alto tráfico: cómo Habitat, su plataforma interna de almacenamiento online, pasó de ser una pequeña librería Python conectada a Azure Cosmos DB a convertirse en una capa distribuida que hoy maneja más de 70 millones de requests por segundo, más de 500 PB de datos y tráfico para productos usados por más de mil millones de personas por semana en casi 40 regiones.
La escala llama la atención, pero las mejores lecciones no están en los números. Están en las decisiones intermedias: cuándo centralizar una librería, cómo detectar que asyncio está introduciendo tail latency, por qué un connection pool LIFO puede generar un fallo metastable, cuándo limitar deliberadamente una API y por qué aceptar deuda técnica puede ser una decisión correcta si estabiliza primero los contratos.
Fuente principal: Rapidly scaling online storage to serve over 1 billion ChatGPT users — OpenAI.
1. De librería cliente a servicio central
Habitat nació en 2023 como una librería Python. La idea era sencilla: los equipos de producto no debían preocuparse por routing, autorización, cifrado, serialización, connection pooling o por decidir si una lectura debía venir de Cosmos DB, una caché u otro backend.
Ese enfoque funciona muy bien mientras el sistema es relativamente pequeño. El problema aparece cuando la lógica de infraestructura vive dentro de docenas de clientes desplegados independientemente.
OpenAI describe un ejemplo revelador. Para reducir el blast radius de fallos regionales necesitaban introducir routing hacia varias cuentas regionales de Cosmos DB. La lógica debía distribuirse detrás de un feature flag, desplegarse en muchos servicios, validarse con shadow traffic y después activarse. Un rollback independiente en uno de los consumidores terminó reintroduciendo una versión vieja y defectuosa del cliente.
La conclusión fue arquitectónica: si una política debe evolucionar de forma coherente para muchos consumidores, mantenerla embebida en cada proceso aumenta el fan-out operacional.
antes

servicio A ─┐
servicio B ─┼─ librería Habitat ─→ storage
servicio C ─┤
servicio D ─┘

cada cambio requiere actualizar muchos clientes
después
servicio A ─┐
servicio B ─┤
servicio C ─┼─→ Habitat service ─→ storage
servicio D ─┘
routing, políticas y observabilidad evolucionan una vezAl convertir Habitat en servicio, OpenAI obtuvo un único punto para despliegues, observabilidad, autorización, auditoría, request shaping y acceso a backends.
La lección general es útil más allá de almacenamiento:
Cuando una librería compartida empieza a contener política operacional global, quizá ya no sea solo una librería.
2. asyncio da concurrencia, no paralelismo de CPU
Una de las partes más interesantes del artículo es el análisis de Python.
Habitat era muy intensivo en I/O, así que asyncio parecía una elección razonable. Sin embargo, el servicio también ejecutaba trabajo de CPU:
- routing;
- compresión;
- cifrado;
- checksums;
- health checks;
- request shadowing;
- hedging;
- parsing de configuración.
El problema es que una coroutine puede haber recibido ya la respuesta de la base de datos y aun así quedarse esperando porque el event loop está ocupado con otra tarea de CPU.
Eso significa que una traza puede mostrar algo engañoso:
Cosmos DB responde rápido
        ↓
respuesta disponible
        ↓
[event loop ocupado]
        ↓
coroutine vuelve a ejecutarse
        ↓
respuesta entregada al cliente
La base de datos no fue lenta. El scheduler local introdujo la latencia.
Para medirlo, OpenAI programó tareas periódicas y comparó el instante esperado de ejecución con el instante real. Esa diferencia funciona como una medida directa del event-loop scheduling delay.
Bajo alta utilización encontraron jitter de cientos de milisegundos y, en casos extremos, segundos.
3. La métrica que falta en muchos servicios async
Muchos dashboards observan CPU, memoria, disco, red, throughput y latencia HTTP. En un servicio async eso puede no ser suficiente.
También conviene observar algo parecido a:
event_loop_delay = actual_wakeup_time - expected_wakeup_timeSi ese valor crece, el servicio puede tener respuestas de downstream listas y aun así no poder procesarlas a tiempo.
Un detector mínimo conceptual sería:
async def monitor_loop(interval=0.1):
    loop = asyncio.get_running_loop()
    expected = loop.time() + interval

    while True:
        await asyncio.sleep(interval)
        now = loop.time()
        delay = now - expected
        observe(delay)
        expected = now + interval
No pretende replicar la implementación de OpenAI, pero ilustra la señal que importa: cuánto tarda el loop en volver a darte CPU cuando debería hacerlo.
La respuesta de Habitat fue contraintuitiva: poca concurrencia por proceso y muchos procesos Python. Según el artículo, mantuvieron cada proceso atendiendo un número pequeño de requests concurrentes y escalaron horizontalmente la cantidad de workers.
4. Un job periódico puede destruir tu p99
Otra causa de tail latency apareció en la configuración de feature flags.
Los workers refrescaban periódicamente un gran archivo JSON. El polling ocurría cada minuto sin jitter y varios procesos vivían en el mismo pod.
El resultado era que, aproximadamente al mismo tiempo, muchos workers dejaban de atender requests para parsear configuración.
El patrón es clásico:
00:59  tráfico normal
01:00  worker 1 parsea JSON
01:00  worker 2 parsea JSON
01:00  worker 3 parsea JSON
...
01:00  p99 sube
La corrección fue sencilla una vez detectada:
- configuración más pequeña;
- refresh menos frecuente;
- jitter en las tareas periódicas.
El principio general es importante:
Los background jobs también forman parte del presupuesto de latencia del request path.
No basta con que una tarea sea “asíncrona” o “de fondo”. Si consume CPU en el mismo runtime, compite con las requests.
5. El bug LIFO que alimentaba al servidor lento
Probablemente la historia más elegante del artículo es la del connection pool.
OpenAI observó que algunos procesos quedaban sobrecargados después de un burst y, en lugar de recuperarse, empezaban a recibir todavía más tráfico.
La causa estaba relacionada con el comportamiento LIFO del TCPConnector de aiohttp.
Supongamos tres servidores:
A rápido
B rápido
C lento
Durante un burst, las conexiones a C terminan más tarde. En un pool LIFO, la conexión que se devuelve más recientemente es precisamente una de las primeras candidatas para reutilización.
A termina ─→ pool
B termina ─→ pool
C termina ─→ pool   # última

siguiente request
      ↓
LIFO elige C
C, que ya estaba lento, recibe más trabajo. Ese trabajo tarda más, la conexión vuelve tarde otra vez y vuelve a colocarse cerca de la parte superior del pool.
Se crea un feedback loop:
servidor lento
   ↓
termina último
   ↓
LIFO lo reutiliza primero
   ↓
recibe más tráfico
   ↓
se vuelve todavía más lento
   ↺
OpenAI lo describe como una forma de metastable failure: aun después de desaparecer el evento inicial que produjo la sobrecarga, el propio sistema mantiene el estado degradado.
Cambiar la reutilización de conexiones a FIFO rompió el ciclo y redujo la varianza de carga.
6. La infraestructura de red termina siendo parte del diseño de la aplicación
Actualmente Habitat depende en gran medida de Istio y Envoy para connection pooling y balanceo consciente de carga.
Esto resolvió otro problema creado por la estrategia de “muchísimos workers”: demasiadas conexiones hacia dependencias downstream.
Miles de procesos pueden provocar:
- thundering herd durante deployments;
- churn masivo de conexiones;
- agotamiento de NAT;
- demasiadas conexiones a la base de datos;
- cascadas de retries.
Envoy actúa como una capa de fan-in:
muchos workers Python
        ↓
      Envoy
        ↓
menos conexiones persistentes HTTP/2
        ↓
     downstream
El proxy puede multiplexar tráfico HTTP/2, mantener pools de conexiones más estables e implementar rate limits y circuit breakers de forma centralizada.
Un circuit breaker distribuido individualmente en miles de workers puede reaccionar demasiado tarde o de manera descoordinada. En una capa común, el sistema obtiene una visión más consistente del downstream.
7. La decisión más interesante: Habitat hace menos
Habitat no intenta ser una base de datos universal.
Su API NoSQL está deliberadamente restringida. OpenAI evita permitir queries arbitrarias con joins, scans o fan-out impredecible.
La razón es operacional: es demasiado fácil escribir una operación barata para el desarrollador pero carísima para la infraestructura.
-- una sola línea para el programador
SELECT ... JOIN ... JOIN ...

-- potencialmente millones de operaciones para producción
Habitat busca operaciones cuyo coste sea pequeño y aproximadamente predecible.
Para consultas complejas, los cambios del sistema OLTP se envían mediante CDC hacia vistas secundarias en Rockset. Así, búsqueda y analítica no compiten directamente con el hot path de almacenamiento online.
El patrón es muy reutilizable:
                 ┌→ OLTP / hot path
writes → Habitat ┤
                 └→ CDC → sistema analítico / búsquedas complejas
En otras palabras: no todo lo que puede consultar tus datos debería consultar la base que mantiene vivo el producto.
8. La deuda técnica también puede ser estratégica
OpenAI sabía que convertir Habitat en un servicio Python aumentaría CPU, memoria y latencia. También esperaba que una reescritura terminara siendo necesaria.
Aun así decidió no migrar inmediatamente.
¿Por qué?
Porque el problema prioritario no era optimizar coste por request. Era estabilizar la plataforma, definir APIs correctas y eliminar el fan-out operacional de la librería.
Eso permitió separar dos decisiones:
- ¿Cuál debe ser el contrato del sistema?
- ¿Cuál debe ser la implementación más eficiente de ese contrato?
Resolver ambas simultáneamente habría aumentado el riesgo.
Esta es una distinción muy valiosa en arquitectura. Una implementación temporal no siempre es deuda accidental; a veces es una forma de comprar información.
9. Python llegó a 20M+ req/s antes de Rust
Antes de migrar, el servicio Python llegó a atender más de 20 millones de requests por segundo.
Eso también evita una lectura simplista del artículo. La conclusión no es “Python no escala”. Python escaló muchísimo. El coste fue la cantidad de procesos, infraestructura, CPU, memoria y trabajo específico para controlar tail latency.
Cuando la plataforma y sus contratos estuvieron maduros, llegó el momento de cambiar el runtime.
10. Dos ingenieros, Codex y una reescritura completa en Rust
En el segundo trimestre de 2026, OpenAI afirma que dos ingenieros, apoyados por Codex y GPT-5.5, reescribieron el servicio completo en Rust.
Según las métricas publicadas:
- Rust usa aproximadamente 6× menos CPU para la misma carga;
- usa alrededor de 15× menos memoria;
- reduce latencia media y tail latency;
- ya atiende aproximadamente 95% del tráfico de producción.
Hay aquí otra lección importante sobre coding agents.
OpenAI tomó una decisión años antes asumiendo que las herramientas de programación asistida mejorarían lo suficiente como para abaratar una migración futura. No significa que “la IA reescribió el sistema sola”; el propio artículo atribuye el trabajo a dos ingenieros con ayuda de Codex y GPT.
Pero sí cambia la economía de una reescritura.
Una vez que los contratos, invariantes, tests, observabilidad y comportamiento esperado están claros, los agentes pueden reducir el coste mecánico de portar implementaciones.
11. Primero contratos e invariantes; después el runtime
La secuencia de Habitat puede resumirse así:
1. librería simple
       ↓
2. adopción masiva
       ↓
3. dolor operacional
       ↓
4. servicio central en Python
       ↓
5. estabilizar API + invariantes + observabilidad
       ↓
6. exprimir Python y entender los cuellos de botella
       ↓
7. migrar a Rust
Lo importante es el orden.
Una reescritura temprana habría intentado congelar demasiado pronto una arquitectura todavía cambiante. La implementación Python permitió descubrir el contrato real del sistema.
12. Qué llevarse a sistemas mucho más pequeños
No hace falta manejar 70 millones de requests por segundo para aplicar estas ideas.
Mide event-loop lag
Si usas Python async, Node.js o cualquier runtime cooperativo, añade una señal que detecte cuándo el scheduler deja de cumplir sus tiempos.
Pon jitter en tareas periódicas
Miles de instancias ejecutando un refresh exactamente a :00 convierten un trabajo inocente en un pequeño ataque DDoS coordinado por tu propio sistema.
Vigila la política de connection reuse
Los detalles del pool pueden cambiar cómo se reparte la carga bajo degradación. LIFO, FIFO, lifetime de conexiones y load balancing no son micro-optimizaciones si afectan feedback loops.
Separa OLTP de consultas impredecibles
El hot path debe tener costes acotados. Search, reporting y analítica pueden usar proyecciones secundarias alimentadas por CDC.
Centraliza backpressure
Rate limits, connection fan-in y circuit breakers deben existir antes de que una dependencia empiece a fallar.
Diseña una API que sea difícil de abusar
Una API menos poderosa puede producir un sistema mucho más escalable si evita operaciones de coste no acotado.
No reescribas antes de saber qué estás preservando
El mejor momento para migrar de lenguaje suele ser cuando puedes expresar claramente los contratos, invariantes y tests que la nueva implementación debe mantener.
Conclusión
La historia de Habitat no es simplemente “OpenAI pasó Python a Rust”. Es una historia de secuenciación arquitectónica.
Primero convirtieron una librería en servicio para recuperar control operacional. Después entendieron el comportamiento real de Python bajo carga: event-loop delay, background work, connection pooling y thundering herds. Limitaron el poder de la API para mantener predecible el coste de cada operación y aislaron consultas complejas mediante CDC.
Solo cuando la plataforma estuvo suficientemente estable migraron el runtime.
Ese orden deja una regla especialmente útil para sistemas que evolucionan rápido:
Estabiliza primero los contratos y los invariantes. Optimiza después la implementación.
OpenAI anunció que una segunda parte profundizará en multi-tenancy, optimización de lecturas y en cómo escalaron la capa de Azure Cosmos DB detrás de los 500+ PB y 70M+ req/s.
Referencia
- OpenAI Engineering, 11 de septiembre de 2026: Rapidly scaling online storage to serve over 1 billion ChatGPT users