 Capital de Tokens
Cuando pensamos en un agente de programación solemos imaginar un modelo conectado a una terminal. Le pedimos corregir un bug, el agente lee archivos, ejecuta tests, modifica código y devuelve un resultado.
Pero esa imagen esconde dos preguntas más profundas:
- ¿Dónde vive realmente la computadora sobre la que trabaja el agente?
- ¿Qué ocurre con todo lo que el agente hizo durante la ejecución cuando termina la sesión?
Hermes Agent, de Nous Research, resulta interesante porque trata ambas preguntas como problemas de infraestructura. Por un lado, desacopla al agente de la máquina donde ejecuta comandos. Por otro, puede registrar el recorrido completo de sus sesiones como trajectories: datos estructurados que sirven para depurar, evaluar e incluso entrenar modelos capaces de usar herramientas.
Estas dos ideas —entornos de ejecución portátiles y trayectorias reutilizables— apuntan a una evolución importante: pasar de usar agentes como asistentes individuales a operarlos como sistemas de cómputo medibles y entrenables.
El agente no es su computadora
Un agente moderno puede dividirse conceptualmente en tres piezas:
Modelo
  +
Runtime del agente
  +
Entorno de ejecución
El modelo decide qué hacer. El runtime mantiene la conversación, ofrece herramientas, coordina llamadas y administra estado. El entorno de ejecución es la computadora real donde ocurren acciones como git status, pytest, npm install o la edición de archivos.
En una herramienta tradicional esas capas parecen estar pegadas a nuestra laptop. Hermes introduce una abstracción en el medio: su herramienta de terminal puede apuntar a distintos backends sin cambiar la lógica de alto nivel del agente.
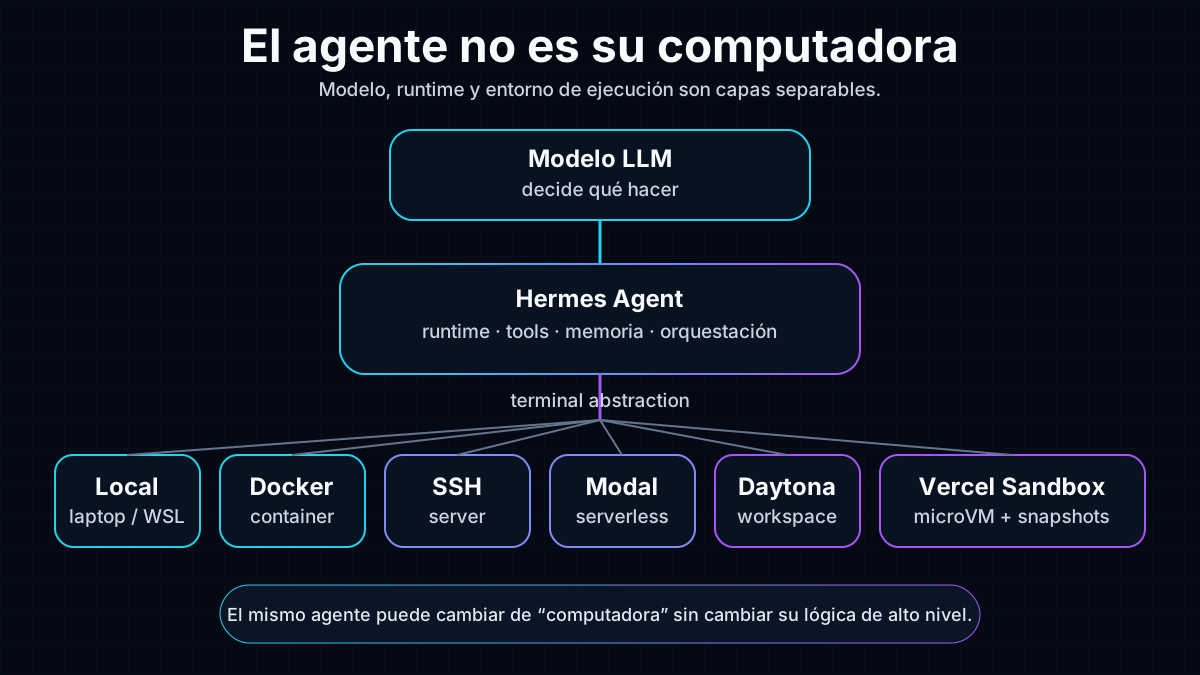
La implementación actual documenta siete backends: local, docker, ssh, singularity, modal, daytona y vercel_sandbox.
Para el modelo, sin embargo, la experiencia puede seguir siendo casi idéntica:
terminal("git status")
terminal("pytest")
read_file(...)
patch(...)
El modelo no necesita preocuparse continuamente por si el comando se ejecutó en la laptop del usuario, en un contenedor o en una máquina remota.
Runtime y sandbox: una separación fundamental
Esta separación permite una arquitectura más parecida a la del cloud:
Usuario / Telegram / API
          │
          ▼
      Hermes Agent
          │
          │ tools
          ▼
   sandbox remoto
          │
    ┌─────┴─────┐
    git       pytest
    python     build
Hermes puede actuar como el runtime del agente, mientras Daytona, Modal, Docker o Vercel Sandbox funcionan como su computadora de trabajo.
Eso significa que el agente puede estar accesible desde un chat y, al mismo tiempo, trabajar sobre una máquina que no es el dispositivo desde el que hablamos con él. Cerrar el portátil deja de implicar necesariamente apagar el lugar donde el agente ejecuta su trabajo.
Esta distinción también mejora la seguridad. El agente puede vivir en un runtime relativamente estable y enviar las operaciones de terminal a un entorno separado, con límites explícitos de CPU, memoria, disco, procesos y permisos.
El problema de los entornos efímeros
Un sandbox completamente efímero tiene una ventaja clara: cada ejecución empieza limpia. Pero también tiene costo.
Cada vez que iniciamos una tarea podemos terminar repitiendo:
crear entorno
    ↓
clonar repositorio
    ↓
instalar dependencias
    ↓
crear caches
    ↓
ejecutar trabajo
    ↓
destruir entorno
Para tareas pequeñas puede ser aceptable. Para agentes que trabajan repetidamente sobre el mismo proyecto resulta ineficiente.
Por eso aparece la idea de persistencia.
Un entorno persistente puede conservar, entre sesiones, elementos como:
workspace/
├── repo/
├── .venv/
├── node_modules/
├── build/
└── caches/
El agente puede dejar de trabajar, el entorno quedar inactivo y, más tarde, recuperar ese estado en vez de reconstruirlo desde cero.
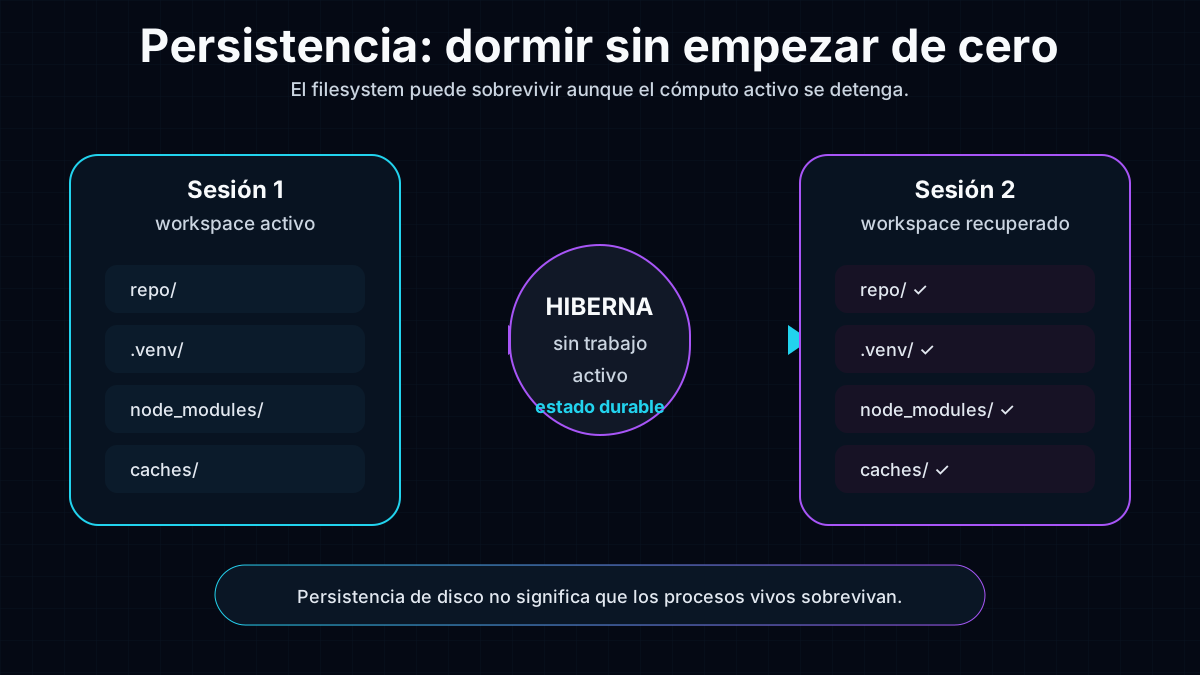
En los backends de contenedores Hermes expone configuración común para CPU, memoria, disco y persistencia. En Docker, por ejemplo, puede mantener un contenedor de larga duración durante el proceso y reutilizar el mismo workspace entre múltiples llamadas de herramientas.
Persistencia de disco no significa proceso inmortal
Hay una distinción importante que suele perderse cuando hablamos de sandboxes persistentes:
persistencia del filesystem ≠ persistencia del procesoUn proveedor puede conservar los archivos aunque destruya la máquina o microVM que los estaba ejecutando.
Vercel Sandbox, por ejemplo, puede apoyarse en snapshots del filesystem para reconstruir el estado de una tarea. Eso permite recuperar archivos y configuración, pero no implica que un proceso con un PID determinado siga vivo después de recrear el sandbox.
Para diseñar agentes de larga duración conviene saber exactamente qué persiste: archivos, variables, procesos, puertos, identidad de máquina o simplemente un volumen reutilizable.
¿Por qué esto importa para agentes autónomos?
Un agente que trabaja durante horas o días necesita algo más parecido a una estación de trabajo que a una función aislada.
Puede requerir repositorios clonados, dependencias instaladas, caches de compilación, artefactos intermedios, credenciales controladas, branches de Git, resultados de tests y herramientas especializadas.
La posibilidad de mover esa estación de trabajo entre local, Docker, SSH o cloud permite escoger la infraestructura según el riesgo y la carga.
Un entorno local puede ser ideal para desarrollo. Docker aporta aislamiento y reproducibilidad. SSH permite mantener al agente lejos de su propio runtime. Singularity encaja en HPC. Modal y Daytona apuntan a ejecución cloud. Vercel Sandbox ofrece microVMs con snapshots.
La abstracción del terminal convierte esos detalles en una decisión de infraestructura, no en una reescritura completa del agente.
De ejecutar agentes a estudiar agentes
La segunda idea es todavía más interesante desde el punto de vista de investigación.
Cuando un agente resuelve una tarea, no produce solamente una respuesta final. Produce una secuencia de decisiones y acciones.
Por ejemplo:
Usuario: "corrige el bug"
        ↓
Modelo decide inspeccionar el repo
        ↓
git status
        ↓
lee resultados
        ↓
read_file(...)
        ↓
modifica código
        ↓
pytest
        ↓
interpreta el resultado
        ↓
respuesta final
Ese recorrido completo es una trajectory.
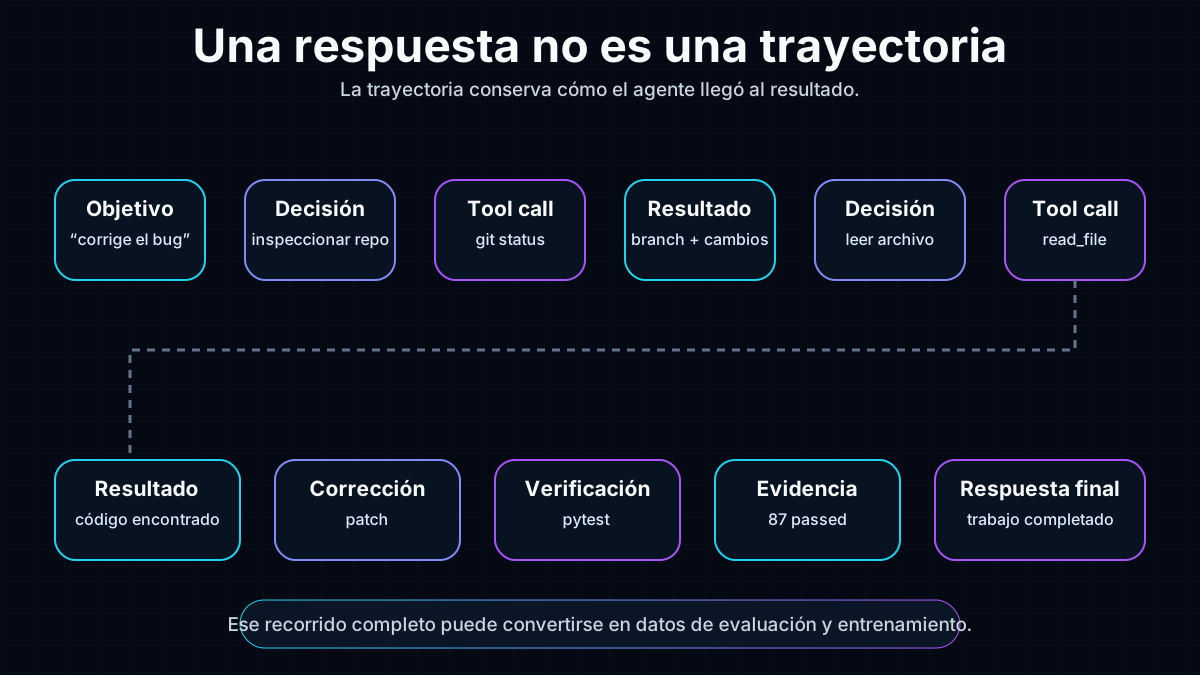
Una trajectory es más valiosa que una respuesta final
Si almacenamos solamente:
prompt → respuestaperdemos casi toda la información operacional.
Para entrenar o evaluar agentes con herramientas nos interesa algo mucho más rico:
objetivo
  +
decisiones
  +
llamadas de herramientas
  +
argumentos
  +
resultados
  +
errores
  +
correcciones
  +
resultado final
Hermes puede guardar estas trayectorias en JSONL compatible con formatos tipo ShareGPT. Además del historial de conversación, el formato puede incluir estadísticas de herramientas, cantidad de llamadas, estado de completitud y errores.
Una entrada simplificada podría parecerse a esto:
{
  "prompt_index": 42,
  "completed": true,
  "model": "modelo-teacher",
  "conversations": [
    "... mensajes, tool calls y tool results ..."
  ],
  "tool_stats": {
    "terminal": {"count": 8, "success": 8, "failure": 0},
    "read_file": {"count": 4, "success": 4, "failure": 0}
  }
}
Ahora el trabajo del agente deja de desaparecer al terminar la sesión. Se convierte en un artefacto de datos.
Generar trayectorias en batch
Hermes incluye un batch_runner.py orientado precisamente a este escenario.
En lugar de darle una sola tarea al agente, podemos preparar un dataset:
{"prompt": "Corrige este bug de Python"}
{"prompt": "Implementa este endpoint REST"}
{"prompt": "Diagnostica este fallo de tests"}
Y ejecutar muchas sesiones de agente en paralelo:
                dataset de tareas
                       │
                       ▼
                Hermes batch runner
                       │
          ┌────────────┼────────────┐
          ▼            ▼            ▼
       worker 1     worker 2     worker 3
          │            │            │
        agente       agente       agente
          │            │            │
       sandbox      sandbox      sandbox
          │            │            │
          └────────────┴────────────┘
                       │
                       ▼
                 trajectories
Cada prompt puede tener su propio entorno aislado. El runner soporta paralelismo, checkpoints y reanudación de ejecuciones interrumpidas.
El resultado termina organizado como un pequeño pipeline de datos:
data/mi_experimento/
├── trajectories.jsonl
├── batch_0.jsonl
├── batch_1.jsonl
├── checkpoint.json
└── statistics.json
Esto transforma al runtime del agente en una factoría de experimentos reproducibles.
Teacher y student: aprender a usar herramientas
Supongamos que utilizamos un modelo potente como teacher para resolver miles de tareas.
modelo potente
     │
     ▼
Hermes Agent
     │
     ▼
10 000 tareas
     │
     ▼
10 000 trajectories
El dataset resultante contiene ejemplos de cómo el modelo selecciona una herramienta, construye sus argumentos, interpreta el resultado, detecta un error, cambia de estrategia, verifica el resultado y decide cuándo terminar.
Esos ejemplos pueden utilizarse posteriormente para fine-tuning o investigación sobre modelos más pequeños.
La meta no es enseñar únicamente que una respuesta correcta es X. Queremos enseñar el patrón de tool use que conduce a una respuesta correcta.
Por ejemplo:
si necesitas conocer el estado del repo
→ llama a git status

si modificaste código
→ ejecuta tests

si los tests fallan
→ interpreta el error
→ inspecciona el archivo relevante
→ corrige
→ vuelve a probar
Ese tipo de comportamiento es central para la siguiente generación de modelos orientados a herramientas.
El problema: las trayectorias pueden ser enormes
Una sesión real puede acumular decenas o cientos de miles de tokens porque los resultados de herramientas suelen ser grandes:
system prompt       8K
respuesta            4K
resultado terminal  20K
archivo leído       35K
logs                 30K
más razonamiento     20K
...
Guardar todo sin procesar puede resultar caro e impráctico para entrenamiento.
Aquí entra la trajectory compression.
Hermes incluye un compresor que intenta reducir una trayectoria a un presupuesto de tokens sin limitarse a cortar el final. El ejemplo de configuración del proyecto usa un objetivo de 29 000 tokens.
La estrategia protege partes importantes como el mensaje de sistema, la solicitud original, las primeras interacciones y los turnos finales. La sección intermedia puede resumirse semánticamente cuando es necesario.
Conceptualmente:
inicio                    KEEP
  ↓
primeras decisiones       KEEP
  ↓
trabajo intermedio      COMPRESS
  ↓
trabajo intermedio      COMPRESS
  ↓
últimas acciones          KEEP
  ↓
resultado final           KEEP
No es compresión ZIP ni cuantización del modelo. Es compresión semántica del episodio del agente para convertir una sesión larga en un ejemplo de entrenamiento manejable.
Cuando unimos ambos mundos
La ejecución portable y las trayectorias no son features aislados. Combinados forman una arquitectura mucho más interesante.
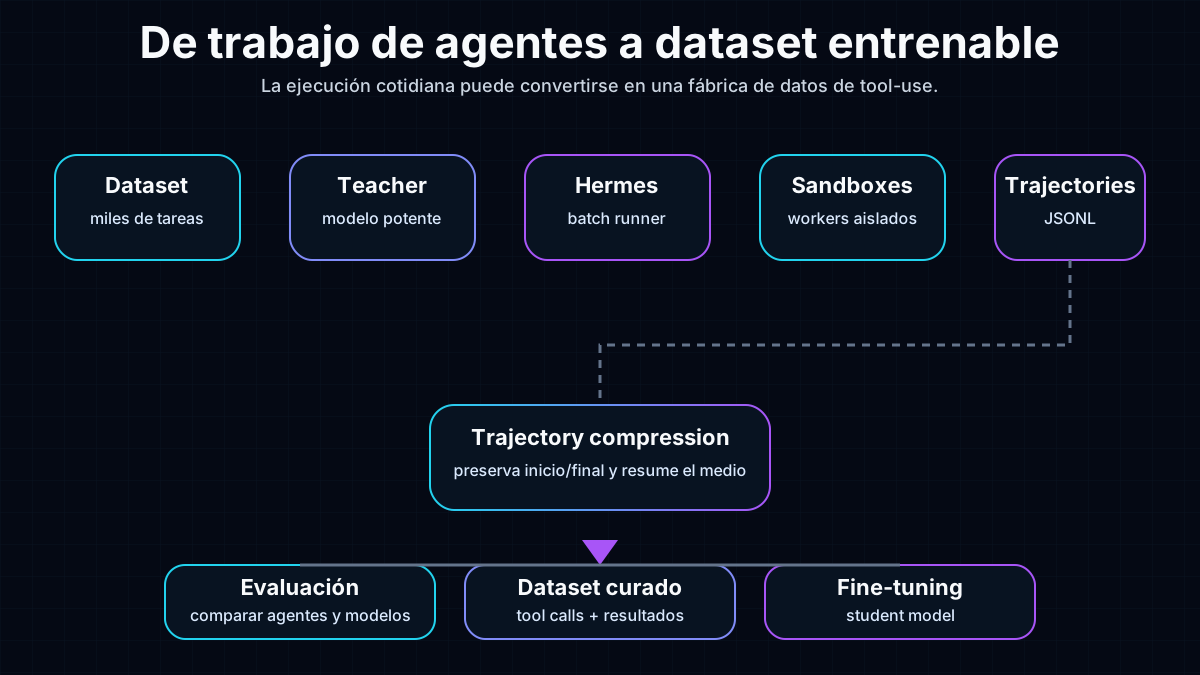
Podemos imaginar el sistema así:
TASK DATASET
    │
    ▼
Hermes
    │
    ├── sandbox 1 → agente
    ├── sandbox 2 → agente
    ├── sandbox 3 → agente
    └── sandbox N → agente
             │
             ▼
        trajectories
             │
             ▼
 trajectory compression
             │
             ▼
       dataset curado
          /       \
         ▼         ▼
   evaluación   fine-tuning
Ahora Hermes ya no es simplemente una alternativa a un coding agent de terminal. Empieza a parecerse a un runtime experimental para sistemas agénticos.
La idea más importante: el trabajo deja de desaparecer
Hoy gran parte del trabajo realizado por agentes se pierde después de cada sesión. Sabemos cuál fue la respuesta final, pero no necesariamente conservamos de manera estructurada qué intentó el agente, qué herramientas usó, dónde falló y cómo se recuperó.
Las trayectorias cambian eso.
Cada ejecución puede convertirse en evidencia para responder preguntas como:
- ¿qué modelos usan mejor las herramientas?;
- ¿qué secuencias de acciones preceden a un resultado correcto?;
- ¿qué errores se repiten?;
- ¿cuánto cuesta resolver una determinada clase de tareas?;
- ¿qué toolsets ayudan o perjudican?;
- ¿podemos entrenar un modelo más pequeño a partir de ejecuciones de uno más capaz?;
- ¿qué políticas reducen reintentos y llamadas innecesarias?
En otras palabras, el agente deja de ser únicamente un worker. También se convierte en un generador de datos sobre su propia forma de trabajar.
Conclusión
Los dos features más interesantes de Hermes Agent apuntan a una misma dirección.
El primero desacopla el cerebro del agente de su computadora. El runtime puede trabajar sobre local, Docker, SSH o sandboxes cloud persistentes sin cambiar la forma fundamental en que el modelo utiliza herramientas.
El segundo desacopla el resultado del proceso que lo produjo. Una sesión deja de ser una conversación efímera y se convierte en una trayectoria estructurada que puede analizarse, comprimirse, compararse y utilizarse como dataset.
Juntos producen una idea poderosa:
los agentes pueden ejecutarse como infraestructura y su experiencia puede acumularse como datos.
Cuando eso ocurre, ya no estamos hablando solamente de automatizar tareas con un LLM. Estamos construyendo sistemas que pueden operar agentes a escala, medir cómo trabajan y utilizar esa evidencia para mejorar la siguiente generación de agentes.