 Capital de Tokens
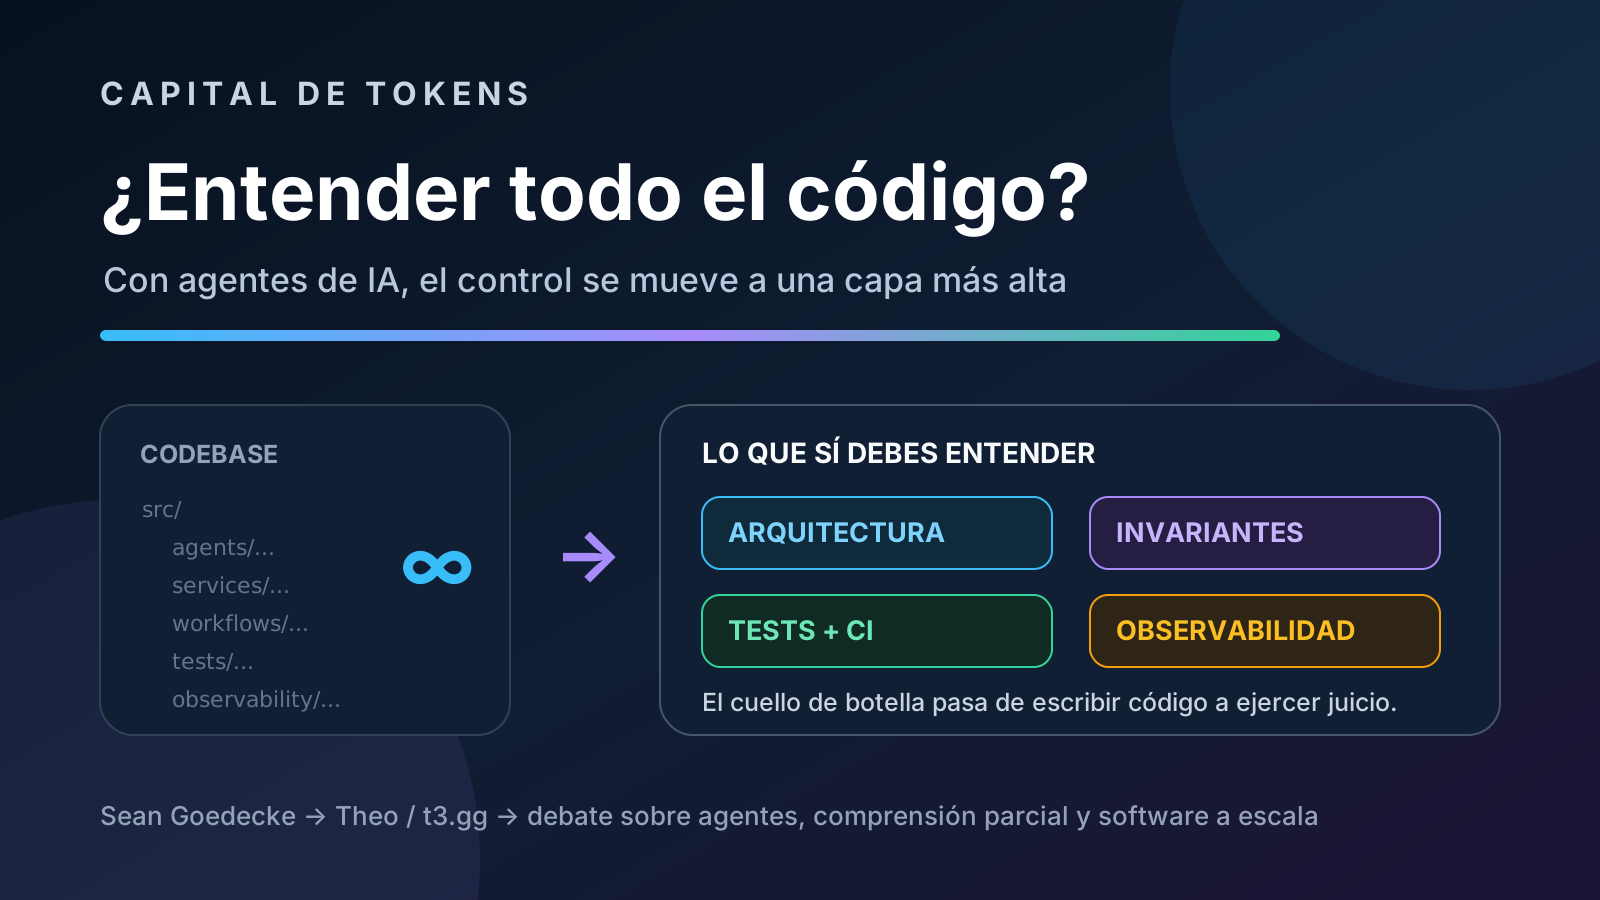
Hay una idea incómoda circulando entre programadores: quizá ya no sea necesario entender cada línea del código que producimos.
Dicha así, suena casi como una provocación. Durante décadas hemos asociado la calidad de un ingeniero con la profundidad de su conocimiento del programa. El buen programador parecía ser quien podía recorrer mentalmente el sistema, explicar sus piezas y saber exactamente dónde tocar cuando algo fallaba.
Dos videos recientes ponen esa intuición bajo presión. En el video en español “Esto no va a parar nunca…” se reacciona al argumento de Theo Browne en “Stop Pretending You Understand Your Codebase”. Theo, a su vez, parte del ensayo de Sean Goedecke “In defense of not understanding your codebase”.
La cadena es interesante porque la discusión empieza como una defensa de la comprensión parcial en grandes sistemas y termina chocando directamente con la programación asistida por IA.
La tesis que emerge no es que podamos dejar de entender lo que hacemos.
Es algo más preciso:
No entender todo el código no significa no entender el sistema.
Y con agentes capaces de producir código mucho más rápido que nosotros, esa distinción puede convertirse en una de las ideas centrales de la ingeniería de software de los próximos años.
El mito del programador que lo sabe todo
Pensemos en un sistema operativo, PostgreSQL, el backend de una plataforma con cientos de millones de líneas o una infraestructura desarrollada durante más de una década.
¿Existe realmente una persona que entienda cada función, dependencia, caso límite, proceso de despliegue y comportamiento histórico?
Probablemente no.
Lo que muchas veces interpretamos como conocimiento total en un ingeniero senior es otra cosa: una intuición muy desarrollada sobre cómo está organizado el sistema.
Esa persona quizá no sepa de memoria dónde vive una función determinada, pero suele poder predecir:
- qué subsistema debería contenerla;
- qué componentes probablemente interactúan con ella;
- qué invariantes no deberían romperse;
- dónde buscar evidencia;
- qué pruebas ejecutar;
- qué observabilidad consultar si algo sale mal.
Es una diferencia enorme.
Un codebase sano no es necesariamente aquel donde todos conocen cada archivo. Es aquel donde alguien que no conoce un detalle puede encontrarlo, comprender el contexto suficiente y modificarlo con seguridad.
En sistemas grandes, la navegación importa más que la memorización.
Peter Naur y la “teoría del programa”
La discusión tiene una raíz mucho más antigua que los LLM.
En 1985, Peter Naur publicó “Programming as Theory Building”, uno de los ensayos clásicos sobre la naturaleza de programar.
Naur proponía que el producto más importante del desarrollo no era simplemente el código. Los programadores construían una teoría del programa: un modelo mental sobre qué problema resuelve, por qué está construido de cierta manera y cómo reaccionará ante cambios.
El código y la documentación sólo capturan una parte de esa teoría.
La idea sigue siendo extraordinariamente útil. Cualquiera que haya heredado un proyecto antiguo conoce la diferencia entre leer los archivos y entender realmente por qué existen determinadas decisiones.
Pero Sean Goedecke señala un problema: llevada al extremo, esa visión encaja mal con los sistemas modernos de gran escala.
Si la teoría sólo vive en las cabezas del equipo original, ¿qué ocurre cuando el equipo desaparece?
Los grandes sistemas no se tiran a la basura automáticamente. Los equipos cambian, las empresas reorganizan departamentos, las personas renuncian y proyectos aparentemente abandonados vuelven a recibir mantenimiento.
La teoría se puede reconstruir parcialmente.
Normalmente se hace siguiendo un flujo real de principio a fin, entendiendo una zona del sistema, haciendo cambios pequeños y expandiendo el mapa poco a poco.
No necesitamos una teoría perfecta para empezar a trabajar.
Necesitamos una teoría suficientemente buena para la decisión que tenemos delante.
Todos trabajamos con un modelo incompleto
Ésta es probablemente la observación más importante de Goedecke y Theo.
En un sistema suficientemente grande, todos operamos con una teoría incompleta e incluso parcialmente equivocada del programa.
Eso no es necesariamente incompetencia. Es una consecuencia de la escala.
Un ingeniero puede conocer perfectamente el servicio donde trabaja y tener una idea superficial de cómo funcionan otros veinte servicios. Otro puede dominar la infraestructura pero no conocer todos los detalles del frontend. Un tercero entiende profundamente el dominio de negocio pero sólo de forma aproximada la capa de almacenamiento.
El sistema continúa funcionando porque combinamos varias cosas:
modelo mental parcial
        +
arquitectura y convenciones
        +
herramientas de navegación
        +
tipos y análisis estático
        +
pruebas
        +
observabilidad
        +
revisión y experiencia
La certeza absoluta se sustituye por evidencia acumulada.
La ingeniería profesional ya funcionaba así mucho antes de ChatGPT, Claude, Codex o Cursor.
Ya delegábamos comprensión antes de los LLM
Cuando usamos un lenguaje con tipos estáticos, no inspeccionamos manualmente cada valor para comprobar si tiene la forma correcta.
Delegamos parte de esa responsabilidad al compilador o al type checker.
Cuando añadimos un linter, delegamos otra colección de comprobaciones.
Cuando usamos una base de datos, no memorizamos el algoritmo exacto de cada estructura interna de almacenamiento.
Cuando importamos una librería, aceptamos una abstracción que contiene código que probablemente nunca leeremos completo.
Cuando consumimos una API externa, trabajamos sobre un contrato sin conocer necesariamente su implementación.
La ingeniería de software está construida sobre la idea de no tener que comprender todos los niveles simultáneamente.
Las abstracciones son precisamente mecanismos para liberar capacidad cognitiva.
Lo que cambia con los LLM no es la existencia de esa delegación.
Lo que cambia es la magnitud.
Los agentes son “100 % turnover” una y otra vez
Theo introduce una analogía especialmente útil para pensar en coding agents.
Cada conversación nueva con un agente se parece a incorporar un desarrollador nuevo al proyecto.
El modelo puede ser extremadamente competente. Puede saber Python, Rust, TypeScript, Kubernetes o SQL mejor que muchos humanos. Pero al comenzar el hilo no posee la historia concreta de nuestro sistema.
No estuvo en aquella reunión donde decidimos una excepción extraña.
No recuerda el incidente de producción de hace seis meses.
No sabe que una función aparentemente absurda existe para mantener compatibilidad con un cliente antiguo.
Tiene que reconstruir la teoría desde lo que puede observar.
Y cuando empezamos una sesión nueva, gran parte de ese contexto debe reconstruirse otra vez.
Visto así, un codebase preparado para agentes tiene muchas de las mismas propiedades que un codebase excelente para humanos que acaban de incorporarse:
- límites arquitectónicos claros;
- nombres predecibles;
- documentación localizada y actualizada;
- contratos explícitos;
- pruebas confiables;
- comandos reproducibles;
- errores visibles;
- observabilidad accesible;
- una ruta rápida desde “no conozco esto” hasta “sé lo suficiente para cambiarlo”.
La IA no elimina la necesidad de diseñar software comprensible.
Puede hacer que esa necesidad sea todavía mayor.
El problema de las reescrituras mágicas
Otra consecuencia importante de esta discusión aparece con las reescrituras completas.
Desde fuera, un sistema viejo puede parecer absurdamente complicado. Un agente puede inspeccionarlo y proponernos una arquitectura mucho más limpia. En minutos puede generar incluso miles de líneas de una alternativa convincente.
Pero un producto maduro contiene algo que rara vez está completamente escrito en la documentación: historia.
Casos límite.
Compatibilidad con clientes extraños.
Decisiones tomadas por requisitos legales.
Workarounds provocados por bugs antiguos.
Expectativas de usuarios que nunca se formalizaron como especificaciones.
La aplicación en producción acaba convirtiéndose en una especie de registro de todos esos compromisos.
Por eso las reescrituras exitosas suelen avanzar por partes: aislar una frontera, reproducir el comportamiento, migrar, medir y continuar.
La velocidad de generación de un LLM no elimina esa realidad.
Podemos generar un sistema nuevo mucho más rápido que antes y aun así desconocer qué comportamientos del viejo sistema eran esenciales.
La dificultad deja de ser escribir el reemplazo.
La dificultad es saber qué significa que el reemplazo sea correcto.
El cambio radical: podremos producir más código del que podamos leer
Aquí la IA sí introduce algo cualitativamente distinto.
Hasta hace poco existía una relación bastante estrecha entre la velocidad humana para escribir código y la velocidad humana para revisarlo y entenderlo.
Los agentes rompen esa simetría.
Un humano puede describir una tarea durante unos minutos y recibir cientos o miles de líneas modificadas. Varios agentes pueden trabajar en paralelo. Un pipeline puede generar código, tests, migraciones, documentación y cambios de infraestructura sin que ninguna persona escriba manualmente cada línea.
OpenAI documentó un ejemplo extremo en “Harness engineering: leveraging Codex in an agent-first world”: un pequeño equipo construyó un producto interno donde el código, los tests, la configuración de CI, la documentación y otras piezas fueron producidas por Codex. La experiencia llevó al equipo a invertir menos atención en escribir código directamente y más en hacer el entorno legible para los agentes, construir feedback loops y convertir conocimiento del sistema en artefactos verificables dentro del repositorio.
Eso apunta a una transformación importante.
Si la producción de código aumenta 10x, 100x o más, insistir en que un humano lea y memorice toda la implementación generada devuelve el cuello de botella exactamente al mismo lugar.
La pregunta pasa de:
“¿He leído todo este código?”
A:
“¿Tengo suficiente evidencia para confiar en este cambio?”
No son la misma pregunta.
La nueva unidad de comprensión
En un workflow agentic, quizá la unidad principal de conocimiento humano deje de ser la función o incluso el archivo.
Podría convertirse en algo parecido a esto:
1. La intención
¿Qué problema estamos resolviendo?
¿Qué comportamiento observable queremos cambiar?
2. La arquitectura
¿En qué frontera debe vivir este comportamiento?
¿Qué componentes pueden depender de cuáles?
3. Los invariantes
¿Qué cosas deben permanecer verdaderas aunque la implementación cambie?
Por ejemplo:
un pago no puede procesarse dos veces
un usuario no puede leer datos de otro tenant
un episodio publicado no puede duplicarse
un deploy fallido debe ser detectable
4. Los contratos
¿Qué entra y qué sale?
¿Qué schemas, APIs, tipos o protocolos definen la frontera?
5. La evidencia
¿Qué tests demuestran que la modificación funciona?
¿Qué evaluaciones cubren los casos difíciles?
6. La producción
¿Qué logs, métricas, trazas y alertas nos dicen qué ocurrió realmente después del despliegue?
Ese conocimiento puede darnos mucho más control sobre el sistema que memorizar cómo están implementadas 200 funciones auxiliares.
No leer el código no puede significar abandonar el juicio
Aquí aparece el límite más importante.
Es posible llevar el argumento demasiado lejos y convertirlo en una justificación para aceptar cualquier cosa que produzca el modelo.
Eso sería un error.
Un agente puede generar código sintácticamente correcto, pasar una batería incompleta de tests y aun así violar una suposición del negocio.
Puede copiar un patrón existente que ya era malo.
Puede introducir complejidad innecesaria.
Puede resolver perfectamente el problema equivocado.
La comprensión parcial sólo funciona cuando está acompañada por mecanismos que reducen la incertidumbre.
Por eso la evolución razonable no es:
antes: humano entiende el código
ahora: nadie entiende nada
Es más bien:
antes:
humano escribe + humano inspecciona gran parte de la implementación

ahora:
humano especifica intención
        ↓
agente implementa
        ↓
contratos + tests + análisis + review
        ↓
CI valida
        ↓
observabilidad confirma el comportamiento real
        ↓
humano ejerce juicio donde la evidencia no basta
El control no desaparece.
Sube de nivel.
Del code review al system review
Eso también podría cambiar el significado de revisar software.
El code review tradicional pregunta con frecuencia:
- ¿está bien escrito este método?;
- ¿este nombre es adecuado?;
- ¿podemos reducir estas diez líneas a cinco?;
- ¿esta abstracción es elegante?
Esas preguntas seguirán siendo útiles, pero cuando el volumen de cambios crezca quizá las más importantes sean:
- ¿esta solución respeta la arquitectura?;
- ¿los contratos siguen siendo compatibles?;
- ¿qué comportamiento nuevo aparece?;
- ¿qué fallo no estamos probando?;
- ¿cómo sabremos en producción si algo salió mal?;
- ¿qué evidencia tenemos de que el agente entendió correctamente la tarea?;
En otras palabras, parte del review se desplaza desde la forma del código hacia el comportamiento del sistema.
El verdadero peligro: deuda epistemológica
La deuda técnica es familiar: hacemos una solución rápida hoy y pagamos complejidad mañana.
Los agentes introducen otra forma de deuda que podríamos llamar deuda epistemológica.
Aparece cuando el sistema cambia más rápido de lo que actualizamos nuestra capacidad para razonar sobre él.
Por ejemplo:
+50.000 líneas generadas
+20 nuevos módulos
+7 nuevos servicios
-0 nuevos mapas arquitectónicos
-0 invariantes documentados
-0 observabilidad adicional
El software puede funcionar hoy.
Pero la organización sabe cada vez menos sobre por qué funciona.
Ese sí es un problema serio.
La respuesta no tiene que ser obligar a una persona a leer las 50.000 líneas.
Puede ser exigir que el crecimiento del código venga acompañado por un crecimiento equivalente de legibilidad del sistema.
Arquitectura actualizada.
Tests que capturen comportamiento.
Interfaces explícitas.
Observabilidad.
Historial de decisiones.
Herramientas que permitan reconstruir contexto rápidamente.
Diseñar para humanos y agentes converge
Hay algo paradójico en todo esto.
Podría parecer que optimizar un repositorio para agentes significa hacerlo menos humano.
En muchos casos ocurre lo contrario.
Un agente necesita encontrar rápidamente dónde vive una responsabilidad.
Un nuevo empleado también.
Un agente necesita comandos reproducibles para ejecutar pruebas.
Un humano también.
Un agente funciona mejor cuando los contratos son explícitos.
Un equipo humano también.
Un agente necesita que las reglas importantes estén en lugares discoverables en vez de perdidas en una conversación antigua.
El próximo ingeniero que entre al proyecto también.
La presión de los agentes puede obligarnos a convertir conocimiento tribal en infraestructura de conocimiento.
Eso sería una mejora real de la ingeniería, independientemente de quién escriba las líneas.
Entonces, ¿qué debería entender el programador?
No existe una respuesta universal.
En un firmware pequeño o una librería crítica, comprender casi cada línea puede seguir siendo perfectamente posible y deseable.
En un sistema distribuido enorme, nunca lo fue.
Con agentes, esa frontera se moverá todavía más.
Pero hay un conjunto de cosas cuya importancia probablemente aumentará:
- el dominio del problema: qué necesita realmente el usuario;
- la arquitectura: cómo están separadas las responsabilidades;
- los flujos de datos: qué entra, qué se transforma y qué sale;
- los failure modes: cómo puede romperse el sistema;
- los invariantes: qué nunca debería ocurrir;
- las señales de calidad: tests, evaluaciones, análisis y métricas;
- los trade-offs: por qué aceptamos una solución y no otra;
- el comportamiento real en producción.
Es posible no conocer la implementación exacta de una función generada ayer y seguir teniendo un control profundo sobre todos esos elementos.
También es posible leer cada línea y no entender el producto que estamos construyendo.
La programación no desaparece; cambia el lugar donde ocurre el pensamiento
El debate provocado por estos videos no debería reducirse a “vibe coding sí” o “vibe coding no”.
La cuestión interesante es dónde queremos colocar nuestra limitada atención humana.
Durante décadas invertimos una parte enorme en traducir nuestras intenciones a sintaxis y en mantener detalles de implementación dentro de nuestra cabeza.
Compiladores, frameworks, tipos, linters y librerías ya fueron trasladando parte de ese trabajo a otras capas.
Los agentes aceleran brutalmente el proceso.
Si esa tendencia continúa, el ingeniero más valioso no será necesariamente quien pueda recitar más código de memoria.
Será quien pueda entrar en un sistema que nadie entiende por completo, construir rápidamente un modelo útil, formular buenas restricciones, dirigir a humanos y agentes, exigir evidencia y detectar cuándo el comportamiento real contradice nuestra teoría.
En ese mundo, “no entender todo el codebase” deja de ser una confesión vergonzosa.
Se convierte en el punto de partida.
La habilidad crítica será saber qué tenemos que entender profundamente, qué podemos delegar y qué mecanismos nos permiten confiar en lo que no mantenemos dentro de nuestra cabeza.
Y si los agentes siguen multiplicando la cantidad de software que podemos producir, esa habilidad sólo va a volverse más importante.
Fuentes
- “Esto no va a parar nunca…” — video en YouTube
- Theo / t3.gg — “Stop Pretending You Understand Your Codebase”
- Sean Goedecke — “In defense of not understanding your codebase”
- Peter Naur — “Programming as Theory Building”
- OpenAI — “Harness engineering: leveraging Codex in an agent-first world”
Recurso complementario
- Podcast compartido en Microsoft Copilot — en inglés.