 Capital de Tokens
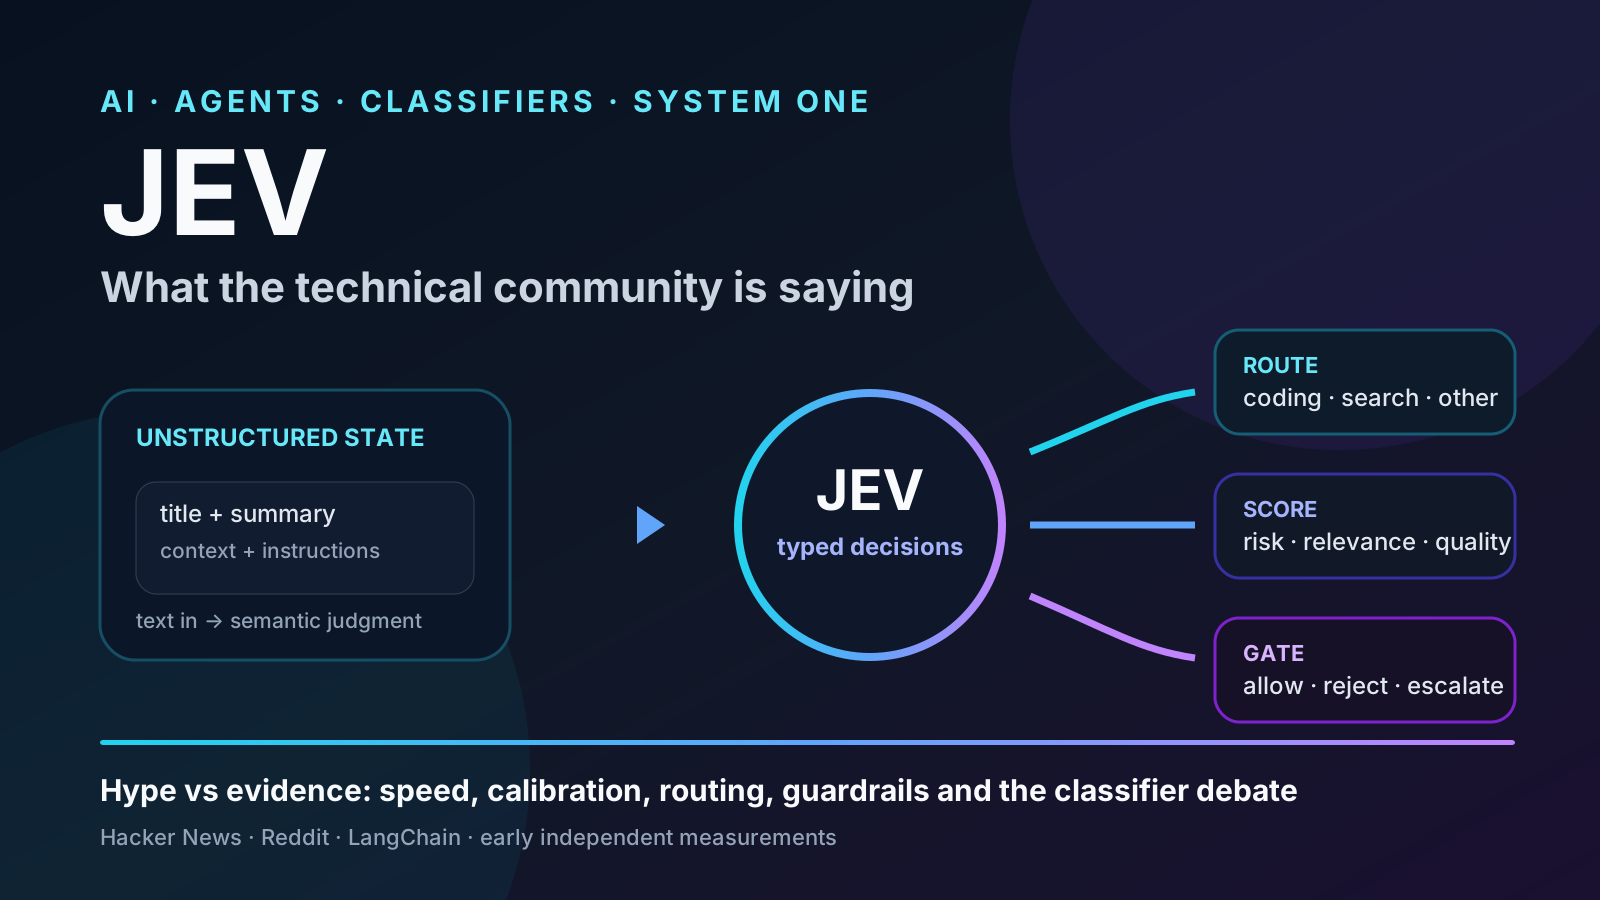
TypeSafe AI lanzó Jev con una propuesta poco habitual para 2026: un modelo de IA que no intenta conversar ni escribir texto.
En lugar de responder con párrafos, Jev recibe un estado y una serie de preguntas tipadas. Puede escoger entre opciones, devolver puntuaciones o estimar la probabilidad de una condición. La idea es que esas respuestas alimenten directamente ramas de código, routers, guardrails y workflows.
El anuncio llamó inmediatamente la atención. El hilo principal en Hacker News superó los 1.800 puntos y acumuló cerca de 500 comentarios en sus primeros días. En Reddit aparecieron experimentos con routing de agentes, seguridad de tool calls, Minecraft, automatización doméstica y evaluadores. LangChain publicó además una integración conceptual de Jev dentro de un agent harness.
Pero el entusiasmo vino acompañado de una pregunta muy razonable:
¿Jev representa realmente una nueva categoría de modelo o es, en esencia, un clasificador generalista extremadamente optimizado?
La respuesta más útil, por ahora, parece ser: las dos descripciones capturan una parte de la verdad.
Qué hace realmente Jev
La documentación de TypeSafe describe Jev como su primer “System One model”: un modelo orientado a decisiones rápidas, semánticas y estructuradas.
La API acepta un estado y varias preguntas. Por ejemplo:
from typesafe_sdk import Choice, Noul, TypeSafeClient

client = TypeSafeClient()

result = client.system_one(
    state={
        "title": "Microsoft launches a new AI coding agent",
        "summary": "The product can autonomously modify code and run tools.",
    },
    questions={
        "topic": Choice(
            instructions="Classify the main topic.",
            criteria={
                "ai": "Artificial intelligence is central.",
                "technology": "Technology is central, but AI is not.",
                "other": "Neither AI nor technology is central.",
            },
        ),
        "publishable": Noul(
            instructions="This story fits an AI and technology publication."
        ),
    },
)
En vez de generar una explicación, el modelo devuelve decisiones estructuradas y probabilidades.
La documentación actual lista Jev 1.13 como modelo estable, con un contexto de hasta 64k tokens por request y un precio publicado de $0.042 por millón de tokens de entrada. TypeSafe también indica que el estado se procesa una vez y que las preguntas pueden evaluarse en paralelo.
Eso explica por qué el modelo está despertando interés en sistemas que necesitan hacer muchas decisiones pequeñas.
Fuentes: Quick start y Models.
La reacción positiva: “semantic branching” barato y rápido
Uno de los comentarios más interesantes del hilo de Hacker News no se centra en el término “System One”, sino en una consecuencia práctica: Jev podría permitir ramas semánticas muy rápidas dentro del control flow.
Eso se parece a esto:
if risk_probability > 0.95:
    require_human_approval()

if route == "coding":
    send_to_coding_agent()

if should_escalate:
    use_expensive_model()
La diferencia es que las variables risk_probability, route o should_escalate pueden depender de comprensión del lenguaje natural en lugar de reglas rígidas.
Ese patrón es atractivo porque los agentes modernos hacen continuamente este tipo de microdecisiones:
- qué tool utilizar;
- si una tool call parece peligrosa;
- si un resultado satisface el objetivo;
- a qué subagente enviar una tarea;
- si merece la pena escalar a un modelo más caro;
- si una respuesta debe revisarse;
- si un documento pertenece a una categoría.
Hoy muchas de esas decisiones se resuelven llamando a un LLM generativo que tarda varios segundos, genera una explicación que nadie necesita y finalmente devuelve una etiqueta.
Jev elimina deliberadamente la parte generativa.
LangChain ve el mismo nicho
LangChain publicó Building a Harness with Jev apenas días después del lanzamiento.
Su planteamiento es importante porque no presenta Jev como sustituto del LLM principal.
Lo coloca dentro del loop del agente.
Un agente típico funciona así:
LLM
 │
 ▼
decide acción
 │
 ▼
tool
 │
 ▼
evalúa resultado
 │
 └──────────→ siguiente iteración
El problema es que cada vuelta puede requerir otra llamada a un modelo generativo.
La alternativa que explora LangChain es usar un modelo como Jev para algunas de las decisiones rápidas y reservar el LLM grande para los pasos donde realmente hace falta generación o razonamiento profundo.
La arquitectura resultante se parece más a:
modelo grande
planifica / escribe / razona
        │
        ▼
      Jev
routing / scoring / gates
        │
        ▼
      código
ejecuta invariantes y acciones
Este patrón probablemente explica buena parte del interés de la comunidad.
”La industria redescubrió los classifiers”
La crítica más repetida en Reddit es también la más divertida: después de años hablando de LLMs, la industria parece haber redescubierto los modelos de clasificación.
En un hilo de r/singularity, varios usuarios describen Jev precisamente como un clasificador generalista.
Pero ahí aparece la diferencia importante.
Un clasificador tradicional suele necesitar:
- un dominio concreto;
- etiquetas definidas previamente;
- un dataset;
- entrenamiento o fine-tuning;
- reentrenamiento cuando cambia el problema.
La promesa de Jev es conservar la velocidad y la estructura de un classifier, pero aceptar criterios definidos en lenguaje natural en tiempo de ejecución.
Si esa capacidad mantiene buena precisión en dominios muy distintos, entonces la comparación con un classifier clásico se queda corta.
No porque la clasificación sea nueva, sino porque cambia el costo de crear una clasificación nueva.
Primeras pruebas de usuarios: routing, juegos y guardrails
Reddit está lleno todavía de pruebas pequeñas, pero algunas son útiles para entender el espacio de diseño.
Un desarrollador en r/LLMDevs probó Jev como router entre varios agentes de una aplicación personal. Reportó latencias end-to-end de aproximadamente 145 a 271 ms en dos ejemplos de routing.
Otro experimento conectó Jev a Mineflayer para controlar Minecraft. El harness exponía un conjunto de acciones y el estado del entorno; Jev elegía repetidamente la acción con mayor probabilidad. El interés aquí no es que “Jev juegue Minecraft” por sí solo, sino que muestra cómo un modelo de decisión rápido puede vivir dentro de un loop interactivo.
También hay desarrolladores probándolo como:
- capa de seguridad sobre tool calls;
- router automático de modelos;
- evaluador de prompts y outputs;
- motor para home automation;
- clasificador de contenido.
Todavía son experiencias anecdóticas. No sustituyen un benchmark reproducible. Pero sí muestran que la comunidad encontró usos concretos casi inmediatamente.
El punto más polémico: “can’t hallucinate”
TypeSafe ha usado la idea de que Jev “no puede alucinar” como una de sus diferencias frente a un LLM generativo.
Aquí Hacker News fue especialmente crítico.
El problema es semántico.
Si defines estas opciones:
AI
Technology
Other
Jev no va a inventar una cuarta categoría como “Maybe robotics”.
En ese sentido, el output está restringido.
Pero el modelo todavía puede devolver:
AI: 99%cuando la respuesta correcta era “Other”.
Un comentario de Hacker News lo resumió con una analogía: puedes tener “Apple: 99%” y seguir estando mirando una naranja.
Por eso es más preciso decir que Jev elimina una clase de fallos de generación y de schema, pero no elimina el error del modelo.
De hecho, la propia documentación de TypeSafe reconoce varias limitaciones de Jev 1.13: lectura demasiado literal, dificultades con precisión numérica, comparaciones de fechas, indirection, estados demasiado grandes y contenido adversarial.
TypeSafe recomienda explícitamente mantener matemáticas, fechas e invariantes estructurales en código.
Fuente: Jev 1.13 jaggedness.
Los benchmarks: aquí está la mayor cautela
El lanzamiento promociona cifras de aproximadamente 193× más velocidad y 444× menos costo en determinados workflows frente a modelos generativos.
La comunidad no ha ignorado esas cifras, pero muchos desarrolladores señalan correctamente que el multiplicador depende muchísimo del baseline.
Comparar:
Jev → una clasificación estructuradacontra:
frontier LLM → reasoning + generación de texto + clasificaciónpuede ser una comparación válida si eso representa el workflow que realmente estás reemplazando.
Pero no significa automáticamente que Jev sea 193 veces más rápido que cualquier alternativa para cualquier clasificación.
Esa distinción importa.
El valor de Jev podría ser enorme aunque el multiplicador universal no exista.
Empiezan a aparecer mediciones independientes
Ya hay algunas evaluaciones externas, aunque todavía son demasiado recientes y pequeñas para hablar de consenso.
WotAI comparó Jev con otros modelos en 150 pasajes y varias tareas. Su conclusión no fue que Jev ganara en precisión absoluta contra todos los modelos: algunos modelos fueron más precisos. Lo interesante fue la combinación de latencia sub-segundo, calibración y capacidad de expresar incertidumbre dentro de la categoría de modelos rápidos.
Por otro lado, OpenChamber analizó miles de publicaciones y separó los claims del fabricante de las mediciones reportadas por practitioners. Su conclusión general es mucho más prudente que el marketing: las mejoras observadas en escenarios reales varían bastante según la comparación utilizada.
Estas pruebas no son papers revisados por pares y no deberían tratarse como una verdad definitiva.
Pero ya son una señal importante: la conversación está pasando de demos a mediciones.
La calibración puede ser más importante que acertar siempre
Hay una idea interesante en el hilo de Hacker News que merece más atención que el claim de “no hallucinations”.
Supongamos que tenemos un gate automático:
if probability >= 0.98:
    execute()
else:
    ask_human()
El modelo no necesita acertar el 100% de las veces.
Necesita que su probabilidad tenga suficiente significado como para permitir una política útil.
La pregunta correcta entonces deja de ser:
¿Cuál es la accuracy total?
Y pasa a ser:
¿Qué porcentaje de decisiones puedo automatizar manteniendo una precisión objetivo?
Eso es especialmente relevante en:
- fraude;
- moderación;
- seguridad;
- approval gates;
- operaciones financieras;
- selección de tools;
- publicación automática.
Un modelo bien calibrado puede ser útil incluso si otro modelo tiene ligeramente más accuracy total, porque permite saber cuándo no automatizar.
Esta probablemente sea una de las áreas donde Jev tendrá que demostrar más en los próximos meses.
Jev no reemplaza al modelo grande
La imagen que está emergiendo de la comunidad no es:
Jev reemplaza a GPT / Claude / GeminiEs más bien:
        LLM grande
     planificación
     generación
     razonamiento
          │
          ▼
         Jev
   decisiones rápidas
   routing
   scoring
   guardrails
          │
          ▼
        código
   invariantes
   ejecución
Eso explica por qué el producto resulta interesante incluso para desarrolladores que consideran exagerado el branding de “nueva clase de frontier model”.
No necesita sustituir al LLM.
Solo necesita hacer suficientemente bien millones de pequeñas decisiones para las que hoy estamos utilizando modelos demasiado grandes.
Qué falta demostrar
Después de los primeros días, hay cinco preguntas abiertas importantes.
1. Accuracy fuera de los demos
Necesitamos conjuntos de evaluación públicos y reproducibles en routing, seguridad, clasificación, ranking y agent control.
2. Calibración en producción
Las probabilidades son una parte central de la propuesta. Hay que comprobar que siguen siendo útiles bajo distribution shift.
3. Robustez adversarial
Un classifier integrado en un agent loop puede recibir texto controlado por usuarios, páginas web o herramientas externas. Eso convierte prompt injection y contenido adversarial en un problema real.
4. Comparación contra baselines correctos
El baseline no siempre debería ser un frontier LLM. También hay que compararlo con:
- modelos pequeños;
- embeddings + classifier;
- rerankers;
- fine-tuned classifiers;
- reglas deterministas.
5. Economía completa del sistema
El precio por token es muy bajo, pero la métrica final debería ser costo por decisión correcta o costo por workflow completado, no simplemente tokens.
Entonces, ¿hype o cambio real?
Todavía es demasiado pronto para llamarlo una revolución.
Pero también sería un error descartarlo como “solo otro classifier”.
La reacción de la comunidad revela algo más interesante: hay una demanda enorme por modelos que no escriban, sino que decidan rápidamente dentro del software.
Durante años optimizamos LLMs para conversar mejor.
Los agentes están exponiendo otra necesidad: cientos o miles de microdecisiones semánticas por workflow.
Si Jev consigue ocupar ese espacio con buena calibración, baja latencia y costos pequeños, su importancia no vendrá de reemplazar al chatbot.
Vendrá de convertirse en una pieza casi invisible del runtime.
Y quizá esa sea la parte más interesante del lanzamiento: la IA más útil de un sistema podría no ser la que habla con el usuario, sino la que ejecuta un “if” inteligente cientos de veces por segundo.
Referencias
- TypeSafe AI, Introducing System One Models and Jev.
- TypeSafe AI, Quick start.
- TypeSafe AI, Models.
- TypeSafe AI, Jev 1.13 jaggedness.
- Hacker News, Introducing System One Models and Jev.
- LangChain, Building a Harness with Jev.
- Reddit / r/LLMDevs, Jev as an agent router.
- Reddit / r/accelerate, Jev controlling Minecraft through Mineflayer.
- WotAI, Jev vs. 15 other models.
- OpenChamber, Jev: claims vs practitioner measurements.