 Capital de Tokens
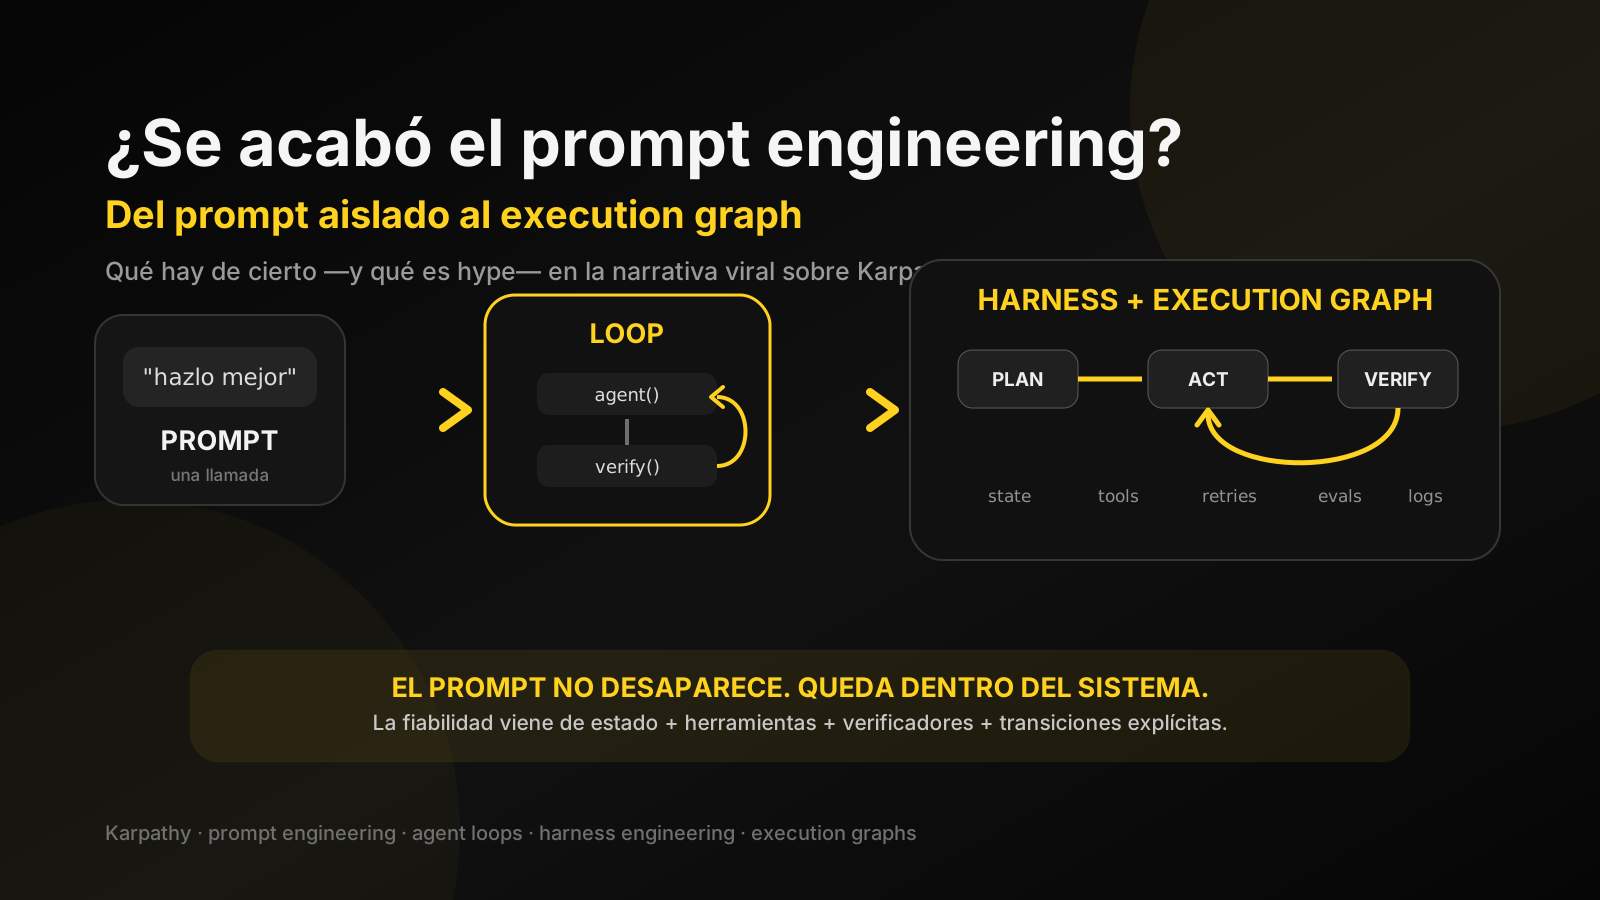
Un post reciente en X plantea una evolución seductora para la ingeniería con modelos de lenguaje:
Prompts → Agents → Loops → Graphs → Self-Improving SystemsEl mensaje atribuido a Andrej Karpathy es todavía más contundente: el prompting habría alcanzado un techo y la siguiente etapa sería dejar de perfeccionar el texto que enviamos al modelo para empezar a construir el grafo de ejecución que lo rodea.
La idea resulta atractiva porque encaja con algo que muchos equipos ya están descubriendo al construir agentes reales: un buen prompt ayuda, pero no resuelve por sí solo problemas como estado persistente, recuperación después de fallos, verificación, concurrencia, permisos, observabilidad o reintentos.
Sin embargo, conviene separar dos cosas:
- la tesis técnica, que tiene bastante sentido;
- la atribución viral a Karpathy, que parece mucho menos sólida.
El post que disparó esta discusión es este de @0xnicc0. Presenta una supuesta clase reciente de aproximadamente dos horas de Karpathy como una especie de curso completo de graph engineering y sistemas auto-mejorables.
Al contrastarlo con la fuente primaria más obvia, la historia cambia.
La clase de dos horas no es nueva
Karpathy publicó “How I use LLMs” el 27 de febrero de 2025. El video dura algo más de dos horas y es una excelente introducción práctica al ecosistema de los LLM.
Pero no es una clase publicada “la semana pasada”.
Tampoco está estructurada como:
Prompts
  ↓
Agents
  ↓
Loops
  ↓
Graphs
  ↓
Self-Improving Systems
Los capítulos oficiales del video recorren temas como interacción con ChatGPT, modelos de razonamiento, búsqueda web, deep research, archivos, Python, Cursor, voz, imágenes, video, memoria y GPTs personalizados.
Es decir: el video es real y muy recomendable, pero el relato viral que se ha construido alrededor de él es otra cosa.
Esta distinción importa. Cuando una idea técnica se vuelve popular, es frecuente que las redes sociales le añadan una frase memorable, una progresión perfecta y una autoridad reconocible. El resultado puede ser conceptualmente interesante aunque la cita original nunca haya existido de esa forma.
Entonces, ¿la idea de los execution graphs es incorrecta?
No. De hecho, aquí está la parte interesante.
Supongamos que queremos que un agente arregle un issue de software.
La versión más simple sería:
usuario
   ↓
prompt
   ↓
LLM
   ↓
respuesta
Esto funciona muy bien cuando una persona permanece delante de la pantalla, interpreta la respuesta y decide manualmente el siguiente paso.
En cuanto queremos autonomía, aparecen preguntas nuevas:
- ¿cómo sabe el agente qué issue está resolviendo?
- ¿cómo conserva el estado entre ejecuciones?
- ¿quién decide si el cambio realmente funciona?
- ¿qué ocurre si el proceso se cae?
- ¿qué pasa si los tests fallan?
- ¿cómo evitamos repetir una acción no idempotente?
- ¿qué herramientas puede usar?
- ¿cuándo debe detenerse?
Ninguna de esas preguntas se responde simplemente añadiendo adjetivos al prompt.
Del prompt al loop
El primer salto útil es convertir una llamada aislada en un loop de ejecución.
        ┌──────────────┐
        │    tarea     │
        └──────┬───────┘
               ↓
        ┌──────────────┐
        │    agente    │
        └──────┬───────┘
               ↓
        ┌──────────────┐
        │   ejecutar   │
        └──────┬───────┘
               ↓
        ┌──────────────┐
        │   verificar  │
        └──────┬───────┘
               │
        ┌──────┴───────┐
        │              │
      éxito          fallo
        │              │
        ↓              └────→ corregir ────┐
      terminar                         │
                                       └────→ agente
Aquí aparece una diferencia fundamental.
El modelo propone acciones, pero el sistema externo decide si el resultado es aceptable.
Un test unitario, un compilador, un linter, una consulta SQL, un checksum o una comparación contra un schema son verificadores deterministas. No importa que el modelo esté convencido de que su solución funciona: el gate puede rechazarla.
Ese patrón es mucho más poderoso que decirle al modelo “revisa cuidadosamente tu respuesta”.
El harness es el sistema alrededor del modelo
Cuando añadimos herramientas, logs, estado, límites y recuperación, empezamos a hablar de un agent harness.
Un harness típico puede encargarse de:
contexto
estado persistente
herramientas
permisos
sandbox
retries
checkpoints
logs
costes
timeouts
verificadores
política de parada
El LLM sigue siendo importante, pero deja de ser toda la aplicación.
Podemos pensarlo así:
              ┌──────────────────┐
              │      estado      │
              └────────┬─────────┘
                       │
                       ↓
┌───────────┐    ┌──────────────┐    ┌─────────────┐
│ contexto  │───→│     LLM      │───→│ herramientas│
└───────────┘    └──────┬───────┘    └─────────────┘
                        │
                        ↓
                 ┌──────────────┐
                 │ verificadores│
                 └──────┬───────┘
                        │
               aceptar / rechazar
Aquí empieza la verdadera ingeniería de agentes.
¿Por qué aparece la palabra “graph”?
Un loop lineal sirve para tareas simples. Los sistemas reales rara vez son completamente lineales.
Imaginemos un agente de desarrollo:
                    ┌───────────┐
                    │   issue   │
                    └─────┬─────┘
                          ↓
                    ┌───────────┐
                    │  planear  │
                    └─────┬─────┘
                          ↓
              ┌───────────┴───────────┐
              ↓                       ↓
        ┌───────────┐           ┌───────────┐
        │ cambiar A │           │ cambiar B │
        └─────┬─────┘           └─────┬─────┘
              └───────────┬───────────┘
                          ↓
                    ┌───────────┐
                    │   tests   │
                    └─────┬─────┘
                          ↓
              ┌───────────┴───────────┐
           fallo                    éxito
              ↓                       ↓
          corregir                  review
              │                       ↓
              └──────────────→      merge
Eso ya es un grafo.
Los nodos representan tareas o estados. Las aristas representan transiciones. Algunas ramas pueden ejecutarse en paralelo. Otras dependen de condiciones.
La utilidad del grafo no está en dibujarlo bonito. Está en hacer explícitas preguntas que un prompt suele dejar implícitas:
- qué puede ocurrir después de cada estado;
- qué condiciones permiten avanzar;
- dónde se puede volver atrás;
- qué tareas son paralelizables;
- qué información necesita cada nodo;
- qué efectos externos pueden repetirse con seguridad.
En muchos casos esto es simplemente una máquina de estados con LLMs dentro de algunos nodos.
Y esa descripción es menos glamorosa, pero más útil.
El prompt no desaparece
Aquí es donde la frase “prompting is dead” resulta engañosa.
Cada nodo que utiliza un modelo todavía necesita instrucciones, contexto y contratos claros.
Por ejemplo:
Graph
 ├── Planner node
 │    └── prompt + issue + repo state
 │
 ├── Developer node
 │    └── prompt + plan + code context
 │
 ├── Reviewer node
 │    └── prompt + diff + invariants
 │
 └── Fix node
      └── prompt + failed checks + review comments
El grafo no sustituye al prompt.
Lo coloca dentro de una arquitectura mayor.
Una formulación más precisa sería:
El prompt engineering deja de ser suficiente cuando el problema requiere un sistema autónomo y verificable.
Ese cambio de perspectiva es importante.
De “piensa mejor” a “demuéstrame que funciona”
Una de las mejores consecuencias de esta arquitectura es que desplaza parte del control desde lenguaje ambiguo hacia mecanismos ejecutables.
Compara estos dos enfoques.
Enfoque basado en instrucciones
Revisa cuidadosamente el código.
Asegúrate de que no introdujiste regresiones.
Comprueba que todo funciona antes de terminar.
Enfoque basado en arquitectura
pytest
ruff
pyright
build
integration tests
property tests
security checks
El primero pide disciplina al modelo.
El segundo construye disciplina dentro del sistema.
No significa que los prompts dejen de importar. Significa que algunas garantías deberían salir del terreno probabilístico del lenguaje y convertirse en invariantes ejecutables.
¿Y los sistemas que “mejoran solos”?
Esta es otra expresión que merece precisión.
Un agente no se vuelve automáticamente mejor simplemente porque tenga un loop.
Para que el sistema aprenda entre ejecuciones necesita algún mecanismo de persistencia y selección:
ejecución
   ↓
resultado
   ↓
evaluación
   ↓
¿funcionó?
   ↓
extraer aprendizaje
   ↓
actualizar memoria / reglas / skills / ejemplos
   ↓
siguiente ejecución
La palabra clave es selección.
Si cada experiencia se convierte automáticamente en una nueva regla, el sistema también puede aprender errores.
Por eso los sistemas auto-mejorables necesitan filtros, evaluaciones, versionado y posibilidad de rollback. En términos de ingeniería, se parecen más a un pipeline de aprendizaje controlado que a una inteligencia que mágicamente se perfecciona sola.
Un ejemplo práctico: agente autónomo de desarrollo
Una arquitectura sencilla podría ser:
objetivo
   ↓
reconstruir estado real
   ↓
seleccionar tarea desbloqueada
   ↓
plan
   ↓
implementar
   ↓
tests
   ↓
┌───────────────┐
│ tests verdes? │
└───────┬───────┘
        │
   no ──┴── sí
   ↓         ↓
fixes       PR
   ↑         ↓
   │       review
   │         ↓
   └──── comentarios
             ↓
           fixes
             ↓
           CI final
             ↓
           merge
             ↓
persistir estado y tomar siguiente tarea
Observa dónde está el valor.
No existe un único “mega-prompt” capaz de garantizar todo este comportamiento. La robustez emerge de combinar:
- modelo;
- prompts especializados;
- estado;
- herramientas;
- verificadores;
- transiciones explícitas;
- recuperación ante fallos.
Eso es mucho más cercano a construir un sistema distribuido que a conversar con un chatbot.
La lección correcta del post viral
El post de X exagera la fuente, pero apunta accidentalmente hacia una tendencia real.
Durante la primera etapa de adopción de LLMs, el arte consistía en conseguir una buena respuesta de una llamada individual.
La siguiente etapa consiste en construir sistemas que puedan ejecutar muchas llamadas y acciones sin perder el control.
Podríamos resumir la evolución de una manera menos espectacular, pero más rigurosa:
Prompt engineering
        ↓
Context engineering
        ↓
Tool use
        ↓
Agent loops
        ↓
Harness engineering
        ↓
State machines / execution graphs
        ↓
Evals + feedback + persistent learning
Ninguna capa elimina necesariamente la anterior.
Las encapsula.
El prompt continúa ahí. Solo deja de cargar con responsabilidades que nunca debieron pertenecerle.
Qué conviene aprender entonces
Si estás construyendo agentes, probablemente obtendrás más valor aprendiendo estos conceptos que buscando el prompt perfecto:
- máquinas de estados y grafos de ejecución;
- idempotencia y manejo de efectos secundarios;
- retries, timeouts y recuperación;
- checkpoints y estado persistente;
- sandboxing y permisos por capacidad;
- evals y verificadores deterministas;
- observabilidad y trazas;
- concurrencia y dependencias entre tareas;
- property-based testing e invariantes;
- memoria versionada con rollback.
Ese conjunto de habilidades explica mejor la transición actual que cualquier slogan sobre la muerte del prompt engineering.
Conclusión
La frase viral puede resumirse como:
Deja de escribir prompts. Construye graphs.La versión técnicamente útil sería:
No esperes que un prompt haga el trabajo de una arquitectura.Los mejores sistemas de agentes no abandonarán los prompts. Los combinarán con loops, estado, herramientas, verificadores y grafos de ejecución que conviertan una respuesta probabilística en un proceso controlable.
Esa diferencia —entre pedirle al modelo que sea fiable y diseñar un sistema que pueda comprobarlo— probablemente sea una de las ideas más importantes de la ingeniería de agentes.
Fuentes y material complementario
- Post de @0xnicc0 en X
- Andrej Karpathy — How I use LLMs, publicado el 27 de febrero de 2025