 Capital de Tokens
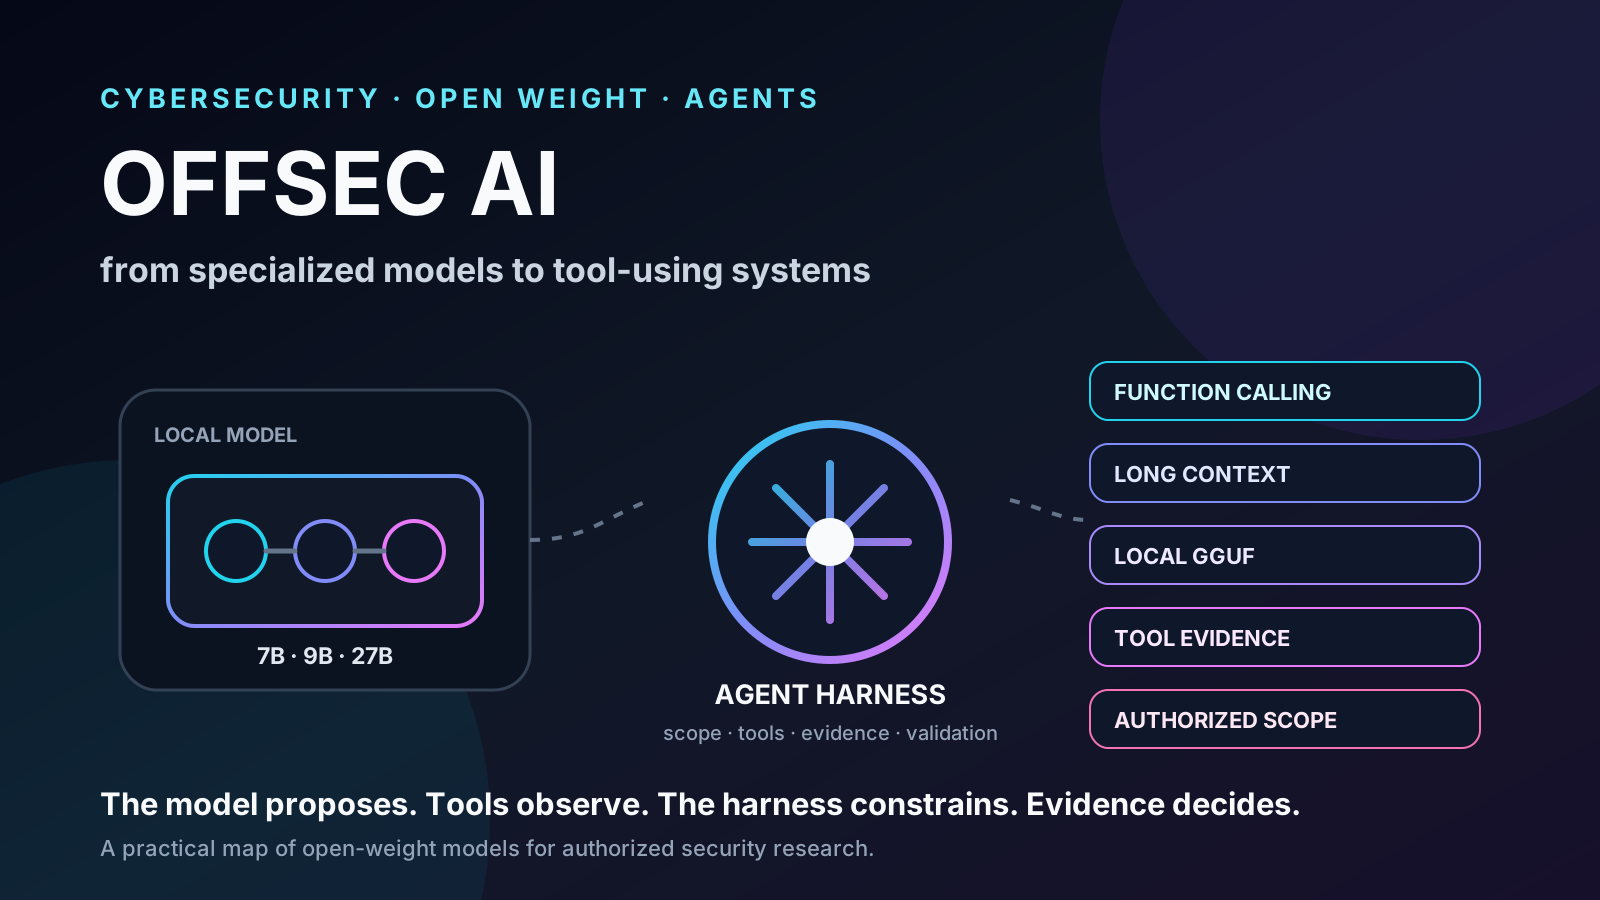
La conversación sobre modelos de IA para ciberseguridad suele caer en una simplificación:
“¿Cuál es el mejor modelo uncensored para hacking?”
La pregunta interesante ya no es esa.
Un repositorio mantenido por Joas A. Santos, Offensive-Security-AI-Models, reúne una fotografía del ecosistema en septiembre de 2026: 27 modelos y variantes open-weight clasificados entre modelos ajustados específicamente para seguridad, modelos generales “abliterated” y modelos clásicos.
Lo más útil de la colección no es la etiqueta uncensored.
Es lo que revela sobre la dirección del mercado:
los modelos de seguridad están dejando de ser simples chatbots especializados y empiezan a diseñarse como componentes para agentes que usan herramientas.
Repositorio analizado: JoasASantos/Offensive-Security-AI-Models.
Nota: las cifras de VRAM, benchmarks, contexto y entrenamiento citadas aquí proceden del snapshot del repositorio y de los model cards enlazados por este. Deben tratarse como especificaciones declaradas, no como una evaluación independiente uniforme entre modelos.
El cambio importante: del conocimiento al comportamiento
Durante años, un “modelo de ciberseguridad” significaba principalmente un LLM afinado con documentación técnica:
- CVE;
- OWASP;
- MITRE ATT&CK;
- writeups de CTF;
- informes de bug bounty;
- malware;
- incident response.
Eso sigue siendo útil, pero no basta para construir un agente.
Un agente necesita algo más parecido a esto:
objetivo
  ↓
razonamiento
  ↓
selección de herramienta
  ↓
llamada estructurada
  ↓
resultado real
  ↓
replanificación
  ↓
evidencia
Por eso, en la lista empiezan a destacar atributos que hace poco eran secundarios:
- tool/function calling;
- contextos de 128K, 262K o incluso más;
- datasets de conversaciones agentic;
- formatos GGUF para ejecución local;
- variantes MoE con pocos parámetros activos por token;
- visión en algunos modelos;
- entrenamiento explícito para CLI, terminal y automatización.
La pregunta deja de ser “¿sabe de pentesting?” y se convierte en:
¿puede participar de forma fiable en un loop agentic?
Tres familias que conviene separar
El repositorio mezcla modelos relacionados, pero técnicamente son familias distintas.
1. Modelos fine-tuned para seguridad
Estos modelos se entrenan o ajustan con datasets de ciberseguridad.
Ejemplos de la lista:
- DeepHat V2 sobre Qwen2.5-Coder;
- BugTraceAI con datos de bug bounty y CVE;
- CyberPal 2.0 para CTI, SOC, IR y AppSec;
- pentest-v2 con GTFOBins, HackTricks y writeups;
- Lily-Cybersecurity;
- VEXT Pentest;
- Imperum CybersecurityLLM.
Su ventaja potencial es la especialización.
No basta con “quitar refusals”: el modelo puede aprender terminología, patrones, workflows y tipos de artefactos propios del dominio.
2. Modelos abliterated u “obliterated”
La abliteration intenta reducir o eliminar mecanismos de rechazo modificando direcciones internas asociadas a refusals.
Eso no convierte mágicamente un modelo en especialista en ciberseguridad.
Un Qwen general abliterated puede ser más permisivo, pero sigue dependiendo de sus capacidades base.
La distinción es importante:
uncensored / abliterated
        ≠
entrenado para seguridad
        ≠
buen agente
El repositorio incluye variantes de Qwen, GLM, DeepSeek y otros modelos en esta categoría.
3. Modelos agentic
Aquí está la parte más interesante.
Algunos modelos no solo prometen conocimiento de seguridad; también anuncian entrenamiento para:
- function calling;
- tool use;
- razonamiento multi-step;
- terminal;
- workflows automatizados.
Eso acerca el modelo al tipo de componente que necesita un harness moderno.
Siete modelos que muestran bien el rango
No tiene sentido ordenar los 27 en un ranking universal: cambian demasiado en tamaño, tarea, cuantización, dataset y objetivo.
Pero algunos ilustran muy bien el espectro.
| Modelo | Tamaño | Contexto | VRAM aprox. | Tools | Lo interesante |
|---|---|---|---|---|---|
| DeepHat V2 | 7B | 131K | ~6 GB Q4 | Sí | Seguridad + base Coder + tool calling |
| Cyber-Ornith-1.5-9B | 9B | 128K | ~7 GB Q4 | Sí | Orientado explícitamente a CLI, terminal y workflows agentic |
| pentest-v2 | 8B | 32K | ~6 GB Q4 | No | Fine-tune pequeño con material de pentesting |
| Qwythos-9B | 9B | hasta 1M | ~7 GB Q4 | Sí | Tool calling + visión + contexto enorme |
| RavenX-CyberAgent | 36B / ~3B activos | 262K | ~24 GB Q4 | Sí | MoE, entrenamiento agentic y salida estructurada |
| security-slm-unsloth | 1.5B | 32K | ~2 GB Q4 | No | Modelo muy ligero para tareas estrechas |
| Qwen3.8-27B Uncensored | 27B | 262K | ~18 GB Q4 | Sí | Modelo general grande, visión y tools |
DeepHat V2: el punto de entrada razonable
DeepHat V2 usa Qwen2.5-Coder-7B como base y el repositorio lo sitúa alrededor de 6 GB de VRAM en Q4_K_M, con 131K de contexto y tool calling.
Ese perfil es importante porque cabe en hardware de consumo razonable.
Un modelo de 7B no tiene que resolver una auditoría entera por sí solo para ser útil.
Puede funcionar como:
recon parser
   ↓
clasificador
   ↓
generador de hipótesis
   ↓
tool call
   ↓
resumen de evidencia
En un sistema agentic, la utilidad total no depende únicamente de la inteligencia aislada del modelo.
Cyber-Ornith-1.5-9B: diseñado para el loop
Cyber-Ornith destaca porque su especialización declarada es explícitamente:
- function calling;
- tool use;
- reasoning;
- automatización CLI/terminal.
Con unos 9B parámetros, 128K de contexto y aproximadamente 7 GB en Q4, entra en una zona muy atractiva para experimentación local.
Si el objetivo es construir un agente, este tipo de entrenamiento puede importar más que unos puntos adicionales en un benchmark general.
pentest-v2: especialización estrecha y barata
pentest-v2 parte de Qwen3-8B y utiliza un LoRA pequeño con 2.804 muestras curadas provenientes de GTFOBins, HackTricks y writeups de HackTheBox.
El repositorio reproduce una cifra llamativa del model card: 100 % de accuracy en una prueba de GTFOBins frente a 25 % del modelo base zero-shot.
Eso no debe interpretarse como “cuatro veces mejor para pentesting”.
Es una medición estrecha y probablemente muy cercana al dominio del fine-tune.
Pero sí ilustra algo útil:
un fine-tune pequeño puede cambiar mucho el comportamiento en una tarea específica.
Qwythos-9B: contexto y multimodalidad en tamaño pequeño
Qwythos-9B aparece con:
- 9B parámetros;
- tool calling nativo;
- visión;
- contexto escalado hasta 1M;
- alrededor de 7 GB en Q4.
En agentes que analizan código, screenshots, salidas de herramientas y documentación extensa, esa combinación puede ser más relevante que un modelo puramente textual con mejor benchmark académico.
RavenX-CyberAgent: cuando el modelo empieza a parecer un componente de plataforma
RavenX usa una arquitectura MoE de unos 36B parámetros totales y ~3B activos, con 262K de contexto y tool calling.
Su especialización declarada incluye un protocolo estructurado para:
Attack Surface
→ Exploit
→ Impact
→ Remediation
→ Document
→ Prevent
También produce mappings como CVSS, CWE y MITRE ATT&CK.
Ese diseño ya no se parece tanto a un chatbot.
Se parece más a un worker especializado dentro de un sistema de seguridad.
El mapa de hardware también cambió
La lista deja claro que “correr un modelo de seguridad local” ya no significa necesariamente una workstation de miles de dólares.
Podemos pensar en cuatro escalones.
~2 GB: modelos ultraligeros
Modelos como security-slm-unsloth-1.5B pueden entrar en equipos muy modestos.
No son candidatos para reemplazar a un modelo grande, pero sí para tareas como:
- clasificación;
- routing;
- extracción;
- etiquetado;
- triage;
- filtros.
~6–8 GB: la zona más interesante para experimentar
Aquí aparecen varios modelos de 7B–9B:
- DeepHat;
- Cyber-Ornith;
- Dolphin3-Cyber;
- pentest-v2;
- Qwythos.
Es probablemente el rango más atractivo para laboratorios locales porque permite combinar:
modelo local
+ Ollama / llama.cpp
+ herramientas reales
+ harness
sin necesitar infraestructura de datacenter.
~18–24 GB: agentes locales más ambiciosos
En esta zona entran varios 27B–36B cuantizados.
Aquí ya podemos obtener mayor capacidad de razonamiento y generación, pero también aumenta la presión sobre:
- VRAM;
- RAM;
- ancho de banda;
- latencia de prompt;
- longitud real de contexto utilizable.
Multi-GPU: modelos frontera open-weight
Algunas variantes GLM o grandes MoE de la lista requieren hardware de datacenter.
Técnicamente son open-weight, pero operativamente pertenecen a otra categoría.
“Se puede descargar” no significa “es práctico correrlo en casa”.
“Uncensored” no significa “mejor”
Esta es probablemente la advertencia más importante.
Eliminar refusals puede ser útil en investigación autorizada porque un modelo demasiado restrictivo puede bloquear incluso actividades legítimas de:
- análisis de vulnerabilidades;
- malware research;
- reverse engineering;
- exploit reproduction;
- CTF;
- red team.
Pero quitar refusals no mejora automáticamente:
- razonamiento;
- precisión;
- grounding;
- planificación;
- tool calling;
- seguimiento de scope;
- resistencia a alucinaciones.
Incluso puede introducir nuevos riesgos.
Un modelo que nunca se niega también puede ejecutar con mucha confianza una hipótesis equivocada.
Para un sistema de seguridad, eso importa muchísimo.
Cómo evaluaría un modelo para un agente real
Antes de mirar un leaderboard, probaría el modelo dentro del workflow que realmente queremos construir.
Por ejemplo:
1. recibir un objetivo limitado
2. leer contexto
3. seleccionar herramienta
4. emitir llamada válida
5. interpretar resultado
6. citar evidencia
7. distinguir "posible" de "confirmado"
8. recuperarse de error
9. respetar scope
10. producir reporte reproducible
Las métricas relevantes serían:
- porcentaje de tool calls válidas;
- tasa de falsos positivos;
- capacidad de citar evidencia real;
- consistencia después de errores;
- obediencia al scope;
- latencia;
- tokens por tarea;
- estabilidad en contexto largo;
- rendimiento con cuantización;
- licencia y procedencia del dataset.
Eso mide un sistema, no solamente un modelo.
El harness importa tanto como el LLM
El propio autor del repositorio mantiene también NeuroSploit, un harness en Rust para pentesting multi-modelo.
Su arquitectura actual pone énfasis en cosas que precisamente no puede resolver un checkpoint por sí solo:
- selección de agentes;
- ejecución paralela;
- uso de herramientas;
- validación cruzada entre modelos;
- tool receipts como evidencia;
- control de scope;
- reporting;
- soporte para modelos locales mediante Ollama y llama.cpp.
Repositorio: JoasASantos/NeuroSploit.
Eso apunta a una arquitectura más realista:
                 ┌───────────────┐
                 │     scope     │
                 └───────┬───────┘
                         ↓
┌──────────┐     ┌───────────────┐
│ modelo A │ ──→ │    harness    │
└──────────┘     └───────┬───────┘
                         ↓
                  ┌─────────────┐
                  │    tools    │
                  └──────┬──────┘
                         ↓
                  ┌─────────────┐
                  │  evidencia  │
                  └──────┬──────┘
                         ↓
                 ┌───────────────┐
                 │ validación B  │
                 └───────────────┘
El modelo propone.
Las herramientas observan.
El harness limita.
La evidencia decide.
La oportunidad real de los modelos locales
Los modelos pequeños especializados tienen una ventaja que a veces se pierde en la comparación con los frontier models:
pueden convertirse en infraestructura.
Un modelo local de 7B o 9B puede permanecer siempre encendido y resolver subtareas sin enviar datos fuera del entorno.
Por ejemplo:
LLM grande remoto
        │
        ├── reasoning difícil
        │
        ▼
      harness
        │
        ├── modelo local → clasificación
        ├── modelo local → tool routing
        ├── modelo local → triage
        └── modelo local → resumen de evidencia
También puede funcionar completamente offline en laboratorios aislados.
Eso es especialmente atractivo en seguridad, donde el contexto puede incluir:
- código propietario;
- topologías;
- logs;
- credenciales temporales;
- indicadores;
- reportes no publicados.
Qué vigilar antes de adoptar uno
Hay varios motivos para ser prudentes.
1. Los benchmarks no son directamente comparables
Cada model card puede usar datasets, prompts y criterios distintos.
No podemos convertir cifras heterogéneas en un ranking limpio.
2. Los contextos máximos no son contextos útiles garantizados
“262K” o “1M” describe capacidad técnica de contexto, no necesariamente calidad estable al razonar sobre todo ese contenido.
3. La cuantización cambia el comportamiento
Q4 puede ser excelente para un caso y degradar otro, especialmente en outputs estructurados o tareas de razonamiento estrechas.
4. El dataset importa
Un modelo entrenado con writeups puede aprender patrones útiles.
También puede memorizar artefactos o sobreajustarse al estilo de esos ejemplos.
5. Un modelo permisivo necesita más controles, no menos
Para un agente con acceso a shell, red o credenciales, la seguridad no puede depender de que el propio modelo decida detenerse.
Se necesitan límites externos:
- scope explícito;
- sandbox;
- permisos mínimos;
- logging;
- approvals;
- separación de secretos;
- validación de resultados.
De chatbot de hacking a sistema operativo de red team
La lista de Offensive-Security-AI-Models es interesante por los modelos que contiene.
Pero es todavía más interesante por lo que representa.
En poco tiempo, el ecosistema pasó de:
LLM general
+ prompt de ciberseguridad
a algo más parecido a:
modelo especializado
+ tool calling
+ contexto largo
+ cuantización local
+ harness agentic
+ evidencia
+ validadores
Ese cambio probablemente sea más importante que cualquier modelo individual.
El futuro de la IA aplicada a seguridad no parece ser un único “supermodelo hacker”.
Parece una arquitectura de agentes especializados, algunos grandes y otros pequeños, coordinados por un harness que controla herramientas, permisos, evidencia y scope.
Y ahí es donde los modelos open-weight pueden tener una ventaja especialmente fuerte: no solo podemos preguntarles cosas.
Podemos convertirlos en componentes programables de una plataforma.
Fuentes
- Offensive-Security-AI-Models — JoasASantos
- NeuroSploit — JoasASantos
- WhiteRabbitNeo en Hugging Face
- Cyber-Ornith-1.5-9B GGUF
- pentest-v2
- Dolphin3-Cyber-8B
- Qwythos-9B
- RavenX-CyberAgent
Uso responsable: estas herramientas y modelos deben emplearse únicamente en sistemas propios, laboratorios, CTF o entornos donde exista autorización explícita para realizar pruebas de seguridad.