 Capital de Tokens
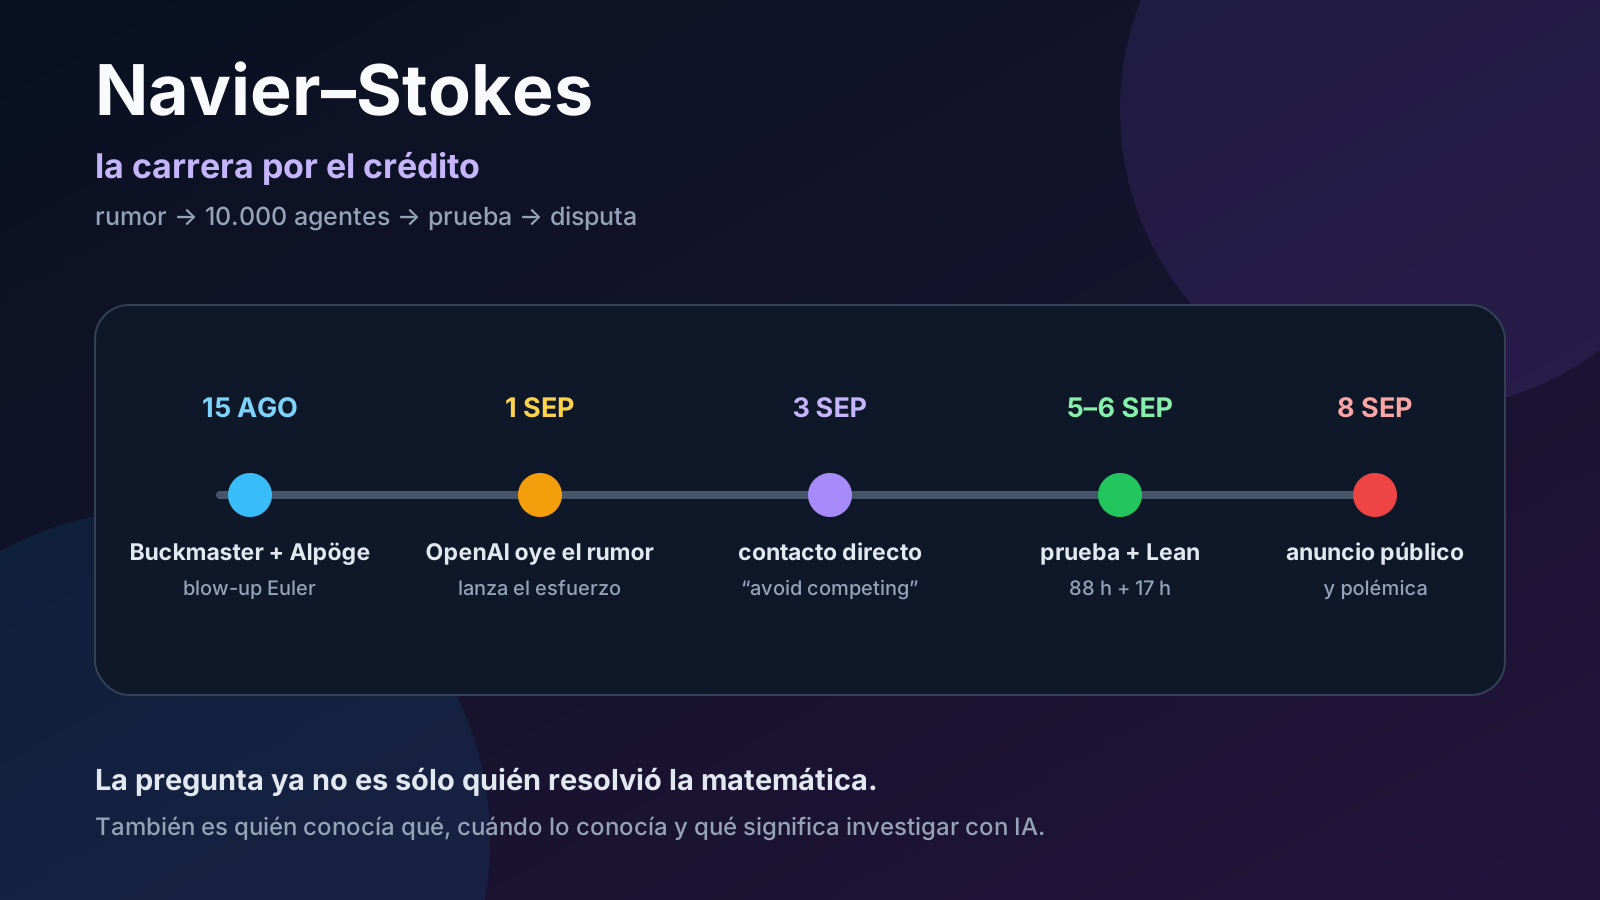
El posible avance de OpenAI sobre Navier–Stokes ya era una historia extraordinaria por sí sola: unos 10.000 agentes concurrentes, millones de mensajes, una prueba analítica y una formalización en Lean para uno de los problemas matemáticos más prestigiosos del mundo.
Pero pocas horas después apareció otra historia, posiblemente igual de importante.
No trata sólo de si la prueba es correcta.
Trata de prioridad científica, crédito, datos privados introducidos en sistemas de IA y qué ocurre cuando el proveedor de la herramienta que usas para investigar puede convertirse también en un competidor con muchísimo más compute.
La controversia enfrenta dos relatos que coinciden en varios hechos fundamentales, pero difieren en la interpretación de lo ocurrido.
Los protagonistas son:
- Tristan Buckmaster, profesor de matemáticas en NYU;
- Levent Alpöge, matemático y empleado de Anthropic, aunque esta colaboración era personal y no un proyecto institucional de Anthropic;
- Sébastien Bubeck y otros investigadores de OpenAI;
- y, detrás de todos ellos, varios modelos de IA: Claude, Codex, GPT-5.6 Sol, GPT-6 Astra y un modelo interno de OpenAI aún más potente.
Para entender la disputa hay que reconstruir la secuencia completa.
Este artículo complementa nuestro análisis anterior: OpenAI propone resolver Navier–Stokes: 10.000 agentes, Lean y un premio del milenio.
Antes de la polémica: un programa de investigación que no empezó con OpenAI
Buckmaster deja algo muy claro en su declaración pública: la línea matemática que él y Alpöge estaban siguiendo no fue inventada por ellos ni por un LLM.
Atribuye la idea fundamental a Diego Córdoba y Luis Martínez-Zoroa, quienes llevaban años estudiando construcciones de blow-up con forcing para ecuaciones de fluidos.
Buckmaster y Alpöge tomaron ese programa como punto de partida y usaron LLMs para intentar empujarlo más lejos: desde resultados con forcing más irregular hacia forcing suave y hacia las ecuaciones de Euler incomprensibles en tres dimensiones.
Durante casi un año usaron diferentes modelos, incluyendo Claude y, de forma importante, OpenAI Codex con GPT-5.6 Sol. Más recientemente utilizaron Astra principalmente para auditoría y redacción.
Ese detalle será crucial después.
15 de agosto: Buckmaster y Alpöge obtienen su gran avance
Según Buckmaster, el 15 de agosto de 2026 obtuvieron resultados de finite-time blow-up con forcing suave para Boussinesq y Euler.
El primer proof generado con ayuda del LLM era, en sus propias palabras, extremadamente difícil de leer. El trabajo de las semanas siguientes consistió en entenderlo, verificarlo y convertirlo en matemática presentable.
El 22 de agosto afirman haber terminado la verificación en Lean del resultado de Euler.
Hasta aquí, OpenAI no aparece todavía como competidor directo.
28 de agosto: OpenAI empieza a entrenar un modelo matemático mucho más potente
OpenAI cuenta que el 28 de agosto comenzó a entrenar un nuevo modelo interno que mostraba una mejora extraordinaria en benchmarks matemáticos.
La compañía dice que este modelo era significativamente más capaz que GPT-6 Astra.
Este entrenamiento comenzó antes de la carrera específica por Navier–Stokes.
1 de septiembre: el dato más importante de toda la historia
OpenAI reconoce públicamente algo fundamental:
el 1 de septiembre oyó rumores de que dos Millennium Prize Problems habían sido resueltos.
La compañía afirma que esos rumores, combinados con el rendimiento de su nuevo modelo, la llevaron a lanzar una evaluación masiva sobre todos los Millennium Problems todavía abiertos y algunos problemas relacionados.
Más tarde OpenAI identificó aquel rumor como relacionado con el trabajo de Levent Alpöge y Tristan Buckmaster.
Esto significa que la siguiente cadena no es una acusación externa; forma parte de la propia cronología de OpenAI:
rumor sobre un avance importante
        ↓
OpenAI decide probar su nuevo modelo
        ↓
lanza agentes sobre Millennium Problems
        ↓
encuentra primero un resultado de Euler
        ↓
concentra recursos en Navier–Stokes
Por tanto, la pregunta relevante no es si el correo que Buckmaster enviaría dos días después inició la carrera. No pudo hacerlo.
La pregunta es:
¿qué información contenía exactamente el rumor que ya había llegado a OpenAI antes del 1 de septiembre?
Eso todavía no está públicamente claro.
1–5 de septiembre: OpenAI convierte el rumor en una búsqueda masiva
OpenAI desplegó grupos de agentes sobre diferentes variantes de los problemas.
En uno de los experimentos pidió a cerca de 100 agentes trabajar sobre un problema relacionado de regularidad para las ecuaciones de Euler. Según OpenAI, esos agentes encontraron una solución para una variante sin forcing.
Ese éxito cambió la estrategia.
La compañía desplazó más recursos hacia Navier–Stokes, alimentó a nuevos agentes con los avances encontrados en Euler y utilizó Codex para consolidar ideas útiles entre grupos.
El grupo final de Navier–Stokes llegó a involucrar del orden de 10.000 agentes concurrentes.
OpenAI reporta para esa búsqueda:
- unos 2,7 millones de mensajes;
- aproximadamente 130.000 millones de tokens de salida;
- unas 88 horas hasta llegar a la solución;
- otras 17 horas para formalizarla y verificarla en Lean con GPT-6 Astra.
Esto importa porque ya no estamos hablando de preguntarle algo a un chatbot.
Estamos hablando de una organización capaz de convertir una pista de mercado o un rumor científico en una campaña de búsqueda computacional a escala industrial.
3 de septiembre: Buckmaster contacta directamente a OpenAI
El 3 de septiembre, Buckmaster dice que ya circulaba un rumor que vinculaba a Anthropic con la resolución de un gran problema abierto.
Alpöge había recibido además avisos de que información sobre su progreso habría llegado a OpenAI.
Buckmaster escribe entonces a un matemático prominente de OpenAI.
No revela la prueba ni especifica exactamente qué problema habían resuelto. Explica que él y Alpöge tienen trabajo sólido, que publicarán pronto y que la colaboración es personal, no un proyecto de Anthropic.
La respuesta que reproduce Buckmaster contiene una frase especialmente relevante: OpenAI le dice que, si está dispuesto a compartir detalles, eso sería útil para “avoid competing”.
También le ofrece compute.
Buckmaster no entrega los detalles y propone hablar la semana siguiente.
4 de septiembre: OpenAI intenta adelantar la reunión
Según Buckmaster, al día siguiente le preguntan si puede reunirse ese mismo viernes.
Vuelve a responder que preferiría hablar la semana siguiente.
Mientras tanto, la búsqueda interna de OpenAI continúa.
5 de septiembre: OpenAI dice que sus agentes encuentran Navier–Stokes
La cronología oficial de OpenAI sitúa el hallazgo el sábado 5 de septiembre, aproximadamente 88 horas después del lanzamiento de los primeros agentes.
El resultado afirma construir una solución inicialmente suave de Navier–Stokes que desarrolla una singularidad en tiempo finito bajo forcing suave.
En la formulación oficial del Millennium Prize, OpenAI afirma resolver las opciones C y D.
Y aquí aparece el punto que activó las sospechas de Buckmaster.
La ruta mediante forcing suave era precisamente la dirección que él y Alpöge llevaban meses desarrollando a partir del programa de Córdoba y Martínez-Zoroa.
Buckmaster afirma que casi nadie de su entorno estaba atacando el problema por esa vía.
Por eso, cuando escuchó que la solución de OpenAI también era forced, lo describió como una “bright red flag”.
Eso no demuestra copia.
Pero explica por qué empezó a hacer preguntas.
6 de septiembre: las llamadas que convierten la carrera matemática en una disputa pública
El domingo 6 de septiembre OpenAI completa, según su cronología, la formalización en Lean.
Ese mismo día Buckmaster mantiene dos llamadas con OpenAI en las que participa Sébastien Bubeck.
Alpöge no está en las llamadas.
Buckmaster cuenta que inicialmente recibió la impresión de que el modelo interno simplemente había recibido el problem statement con “very little human input”.
Pero, según su relato, durante la conversación fue emergiendo una realidad mucho más compleja:
- un equipo completo había estado trabajando en el proyecto;
- se habían probado varios problemas;
- los agentes habían trabajado primero sobre problemas más sencillos como Euler;
- se habían usado prompts derivados de trabajo previo de los propios agentes;
- Codex había participado en consolidar información;
- y se había utilizado una cantidad enorme de compute.
Curiosamente, la publicación oficial de OpenAI confirma hoy prácticamente toda esa infraestructura multiagente.
La pregunta incómoda: ¿qué ocurrió con las sesiones privadas de Codex?
Aquí la historia deja de ser únicamente una disputa sobre prioridad científica.
Buckmaster y Alpöge habían usado Codex durante meses y habían introducido en esas sesiones borradores y razonamiento de su proyecto.
En la llamada del día 6 Buckmaster pregunta si el modelo interno de OpenAI había sido entrenado con esas sesiones o había tenido acceso a ellas.
Según su declaración, le respondieron que el modelo no había buscado datos de usuarios.
Cuando volvió a preguntar específicamente por training, dice que no obtuvo respuesta en ese momento.
OpenAI posteriormente publicó una posición más precisa:
- ni los investigadores ni los agentes vieron el trabajo de Buckmaster y Alpöge antes de que fuese público;
- no se accedió a datos específicos de usuario para resolver Navier–Stokes;
- pero la empresa no puede descartar completamente que datos desidentificados derivados del uso de sus productos hubieran contribuido previamente a mejorar sus modelos.
Esa última salvedad es extraordinariamente importante.
No prueba que la investigación privada de Buckmaster haya influido en la solución.
Pero muestra por qué el problema general existe.
Las propuestas sobre publicación y crédito
Buckmaster afirma que durante las conversaciones recibió dos propuestas.
La primera consistía, según su relato, en que él y Alpöge publicaran su resultado de Euler y OpenAI publicara Navier–Stokes al día siguiente.
La segunda implicaba que Buckmaster participara en un paper que presentara el resultado de Navier–Stokes producido por el modelo interno de OpenAI.
Buckmaster sostiene que Bubeck quería que Alpöge no apareciera como autor y que su empleo en Anthropic era parte del problema.
Aquí existe una disputa directa sobre la interpretación.
Bubeck ha rechazado públicamente la idea de que OpenAI quisiera quitar a Alpöge el crédito por el trabajo que Alpöge y Buckmaster ya habían hecho juntos.
La controversia parece depender de qué paper se estaba discutiendo exactamente: el trabajo original de Buckmaster/Alpöge o un eventual paper separado que explicara el resultado producido por OpenAI.
Sin transcripciones completas de las conversaciones, conviene mantener esa distinción.
“Why would you ruin your career?”
Buckmaster afirma que dijo que haría pública la historia si OpenAI procedía de la forma propuesta.
Según su declaración, recibió la respuesta:
“Why would you ruin your career?”
Buckmaster cuenta que preguntó por qué hacer pública la historia dañaría su carrera y recibió otra respuesta que interpretó como intimidatoria.
Es una acusación seria y debe tratarse como tal: es el relato de Buckmaster sobre una conversación privada.
La cobertura posterior de medios como WIRED y TechCrunch ha puesto este intercambio en el centro de la polémica, mientras Bubeck ha defendido públicamente la integridad académica de su actuación y ha disputado parte de la interpretación sobre el crédito.
7 de septiembre: Buckmaster y Alpöge publican antes de lo que querían
Buckmaster y Alpöge hacen públicos sus resultados sobre blow-up con forcing suave para varias ecuaciones de fluidos, incluyendo Euler 3D.
Buckmaster reconoce que algunos documentos están menos pulidos de lo que hubiera querido.
Su explicación es que la presión competitiva de los acontecimientos lo llevó a publicar antes.
Esto por sí mismo ilustra uno de los efectos nuevos de la ciencia asistida por IA:
investigación lenta y privada
        ↓
se filtra que existe un avance
        ↓
un laboratorio con enorme compute reacciona
        ↓
los investigadores originales aceleran la publicación
La IA no sólo cambia cómo se hace investigación.
También puede cambiar el ritmo estratégico de publicación.
8 de septiembre: OpenAI anuncia Navier–Stokes
OpenAI publica su solución propuesta, el paper y la formalización en Lean.
La compañía reconoce explícitamente que su esfuerzo comenzó el 1 de septiembre después de escuchar un rumor que posteriormente identificó como relacionado con Alpöge y Buckmaster.
También afirma que no utilizará este resultado para reclamar el premio de un millón de dólares del Clay Mathematics Institute.
En paralelo, la controversia sobre prioridad y proceso explota públicamente.
Qué está confirmado y qué sigue sin demostrarse
Es importante no convertir una historia complicada en una acusación más fuerte de lo que permiten los hechos públicos.
Lo que sí está confirmado
OpenAI reconoce que:
- oyó el rumor el 1 de septiembre;
- ese rumor estaba relacionado con Buckmaster y Alpöge;
- el rumor ayudó a motivar el esfuerzo;
- lanzó una búsqueda masiva usando miles de agentes;
- primero obtuvo un resultado relacionado de Euler;
- utilizó Codex para consolidar ideas entre grupos;
- finalmente llegó a una solución de Navier–Stokes con forcing suave;
- no puede descartar por completo que datos desidentificados del uso de sus productos hubieran contribuido a mejorar sus modelos.
Buckmaster reconoce que:
- él y Alpöge usaron ampliamente LLMs, incluido Codex;
- no ha visto la prueba interna de OpenAI antes de la publicación;
- no sabe qué hizo exactamente el modelo de OpenAI;
- no sabe si sus datos fueron utilizados.
Lo que no está demostrado públicamente
No existe evidencia pública que demuestre que:
- OpenAI leyó los prompts privados de Buckmaster y Alpöge para dirigir la búsqueda;
- OpenAI copió su prueba;
- el modelo interno reprodujo directamente razonamiento procedente de esas sesiones;
- el rumor del 1 de septiembre contenía detalles técnicos suficientes para revelar la ruta del forcing suave.
Ese último punto es probablemente el mayor agujero de la cronología.
El verdadero problema no es sólo Navier–Stokes
Supongamos incluso el escenario más favorable para OpenAI: que nadie leyó datos privados, que el modelo llegó de forma independiente a la solución y que el rumor sólo revelaba que “algo grande” estaba cerca.
Aun así aparece un problema estructural nuevo.
Imaginemos esta situación:
investigador usa una IA como colaborador
        ↓
introduce ideas todavía no publicadas
        ↓
el proveedor de la IA conoce que existe progreso
        ↓
puede movilizar miles de agentes y millones en compute
        ↓
obtiene un resultado competitivo antes de la publicación original
La vieja frontera entre herramienta y competidor empieza a desaparecer.
Un laboratorio de IA puede ser simultáneamente:
- proveedor de infraestructura;
- custodio de conversaciones;
- desarrollador del modelo;
- creador de modelos futuros entrenados con señales derivadas del uso;
- y participante directo en la misma carrera científica.
Ese conflicto potencial no tiene un equivalente perfecto en la ciencia tradicional.
Los prompts de investigación empiezan a parecer secretos industriales
Hasta ahora muchos científicos y desarrolladores han tratado los prompts como algo desechable.
Este caso sugiere otra mentalidad.
Cuando un prompt contiene:
- una conjetura inédita;
- una estrategia de prueba;
- resultados negativos;
- una arquitectura todavía no patentada;
- datos preliminares;
- o una idea que señala qué camino merece ser explorado,
puede contener propiedad intelectual de enorme valor, incluso aunque todavía no exista un paper terminado.
Para ciertos tipos de investigación de frontera, la pregunta ya no debería ser sólo:
“¿Este modelo me ayuda?”
También debería ser:
“¿Qué garantías contractuales y técnicas tengo sobre lo que estoy revelando mientras me ayuda?”
La prioridad científica también cambia cuando existe compute masivo
La ciencia moderna ha tenido siempre carreras.
Dos equipos podían acercarse simultáneamente al mismo resultado.
Lo nuevo es la asimetría de velocidad.
Un rumor pequeño puede permitir a una organización convertir una intuición en:
10 investigadores humanos
        vs.
10.000 agentes concurrentes
Eso no elimina el mérito de la solución encontrada por los agentes.
Pero sí obliga a repensar qué significa prioridad cuando una pista vaga puede transformarse casi instantáneamente en millones de intentos computacionales.
La lección para quienes investigan con modelos comerciales
Este caso todavía no demuestra abuso de datos.
Pero basta para justificar nuevas prácticas.
Equipos que trabajan con resultados sensibles deberían considerar:
- revisar explícitamente las políticas de entrenamiento y retención de cada herramienta;
- utilizar configuraciones empresariales o contractuales adecuadas para material confidencial;
- separar prompts públicos de prompts con conocimiento no publicado;
- mantener trazabilidad y timestamps de ideas, proofs y experimentos;
- formalizar acuerdos de colaboración antes de compartir resultados decisivos;
- tratar las sesiones de IA como parte del registro científico del proyecto, no como conversaciones efímeras.
Probablemente veremos también cambios institucionales en universidades, journals y organismos de financiación.
Conclusión
La polémica de Navier–Stokes tiene dos niveles distintos.
El primero es matemático:
¿la prueba de OpenAI es correcta y resuelve realmente el Millennium Prize Problem?
Eso lo decidirá la revisión matemática.
El segundo es institucional:
¿cómo deben funcionar el crédito, la confidencialidad y la prioridad científica cuando los investigadores usan sistemas de IA construidos por laboratorios que también compiten por los descubrimientos?
Esa pregunta no necesita esperar dos años a Clay.
Ya está aquí.
Y posiblemente sea la consecuencia más importante de toda esta historia.
Fuentes
- Tristan Buckmaster — declaración pública sobre la cronología y la disputa
- OpenAI — On the Navier–Stokes Millennium Prize Problem
- WIRED — OpenAI Just Claimed a Huge Math Discovery. Some Academics Are Crying Foul
- TechCrunch — OpenAI fought dirty on career-making math problem, says NYU mathematician
- MSN — You should care about the AI math breakthrough drama even if you’re not a nerd