 Capital de Tokens
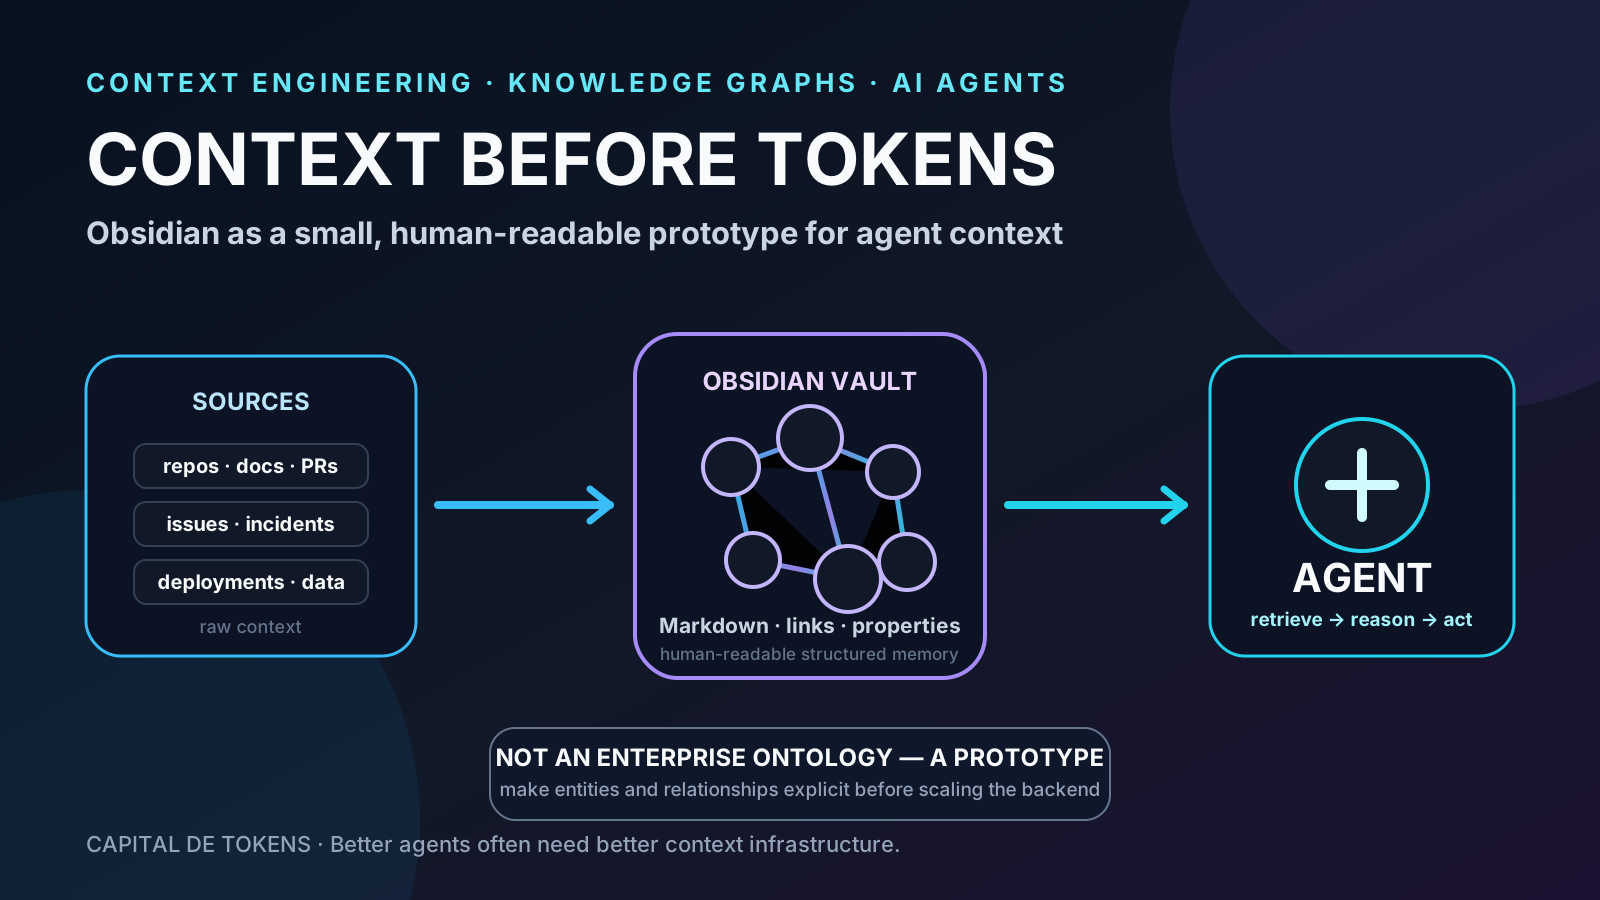
Los modelos de IA son cada vez mejores razonando, escribiendo código y usando herramientas. Pero en sistemas reales aparece un problema menos glamoroso y, con frecuencia, más importante:
el agente no sabe dónde está la información correcta.
Puede tener acceso a repositorios, tickets, incidentes, despliegues, documentación, datasets y chats internos. Si todo eso llega como fuentes aisladas, el agente termina haciendo lo que haría una persona sin mapa: buscar, abrir, leer, volver atrás y seguir buscando.
Uber publicó recientemente una cifra que hace visible el costo de ese problema. Su AI Context Graph reúne aproximadamente 24 millones de nodos y 80 millones de relaciones, con 86 tipos de nodo y 117 tipos de relación, alimentados por más de 30 sistemas internos. En un experimento, el mismo modelo respondió correctamente en 38 segundos usando el grafo; sin esa capa de contexto estuvo más de 20 minutos buscando y terminó equivocado.
Eso sugiere una idea poderosa para equipos mucho más pequeños:
quizá no necesitamos empezar por un knowledge graph empresarial. Podemos empezar por representar explícitamente las entidades y relaciones que un agente necesita conocer.
Y una herramienta inesperadamente útil para experimentar con ese patrón es Obsidian.
Tres ideas que se están acercando
Aunque provienen de mundos distintos, Uber, Palantir y Obsidian permiten observar tres niveles del mismo problema.
1. Obsidian: conocimiento enlazado y legible por humanos
Obsidian guarda las notas como archivos Markdown dentro de un vault. Sus enlaces internos conectan notas y su Graph View representa esas conexiones como nodos y líneas.
Eso ya nos da una estructura mínima:
nota          -> nodo
[[enlace]]    -> relación
property      -> atributo
vault         -> universo de conocimiento
No es una ontología empresarial. Pero es una forma muy barata de comenzar a hacer explícitas las relaciones.
2. Uber: contexto estructurado para que el agente no busque a ciegas
El AI Context Graph de Uber conecta servicios, equipos, pull requests, incidentes, documentos de arquitectura, deployments, datasets y uso histórico de tablas.
La diferencia crítica no es únicamente que Uber tenga “muchos datos”. Es que el agente puede navegar una representación donde las relaciones ya existen:
servicio
  ├── pertenece_a -> equipo
  ├── desplegado_en -> producción
  ├── afectado_por -> incidente
  ├── modificado_por -> pull request
  └── consume -> dataset
En vez de pedirle al modelo que descubra esas relaciones cada vez, el sistema se las entrega como infraestructura.
Eso es Context Engineering llevado más allá del prompt.
3. Palantir: cuando el grafo deja de ser solo conocimiento
La Ontology de Palantir va bastante más lejos. Modela objetos, propiedades y links, pero también incorpora lógica, acciones y seguridad.
Conceptualmente:
datos
  ↓
objetos + propiedades + relaciones
  ↓
lógica
  ↓
acciones
  ↓
sistemas operacionales
Ahí está una diferencia importante.
Un grafo de conocimiento puede decir:
PR #742 -> modifica -> servicio de pagosUna ontología operacional puede además representar:
servicio de pagos
  -> puede desplegarse mediante
  -> acción Deploy
  -> bajo determinadas políticas
Por eso decir que Obsidian “es como Palantir Ontology” sería exagerado.
Pero decir que Obsidian puede servir como prototipo del modelo mental sí resulta bastante útil.
Cómo convertir un vault en un Context Graph pequeño
Imaginemos un proyecto de software con repositorio, issues, PRs, decisiones técnicas e incidentes.
Una estructura inicial podría ser:
Knowledge/
├── systems/
├── components/
├── repositories/
├── teams/
├── decisions/
├── incidents/
├── issues/
├── pull-requests/
└── deployments/
Cada archivo representa una entidad.
Por ejemplo:
---
type: component
status: production
owner: Platform
depends_on:
  - "[[Publisher]]"
  - "[[YouTube API]]"
runs_on:
  - "[[Oracle Runner]]"
related_issues:
  - "[[Issue 290]]"
---
Y en Markdown:
# Thumbnail Pipeline

Genera la miniatura del episodio.

## Relaciones

- depende de [[Storyboard]]
- ejecuta en [[Oracle Runner]]
- notifica mediante [[Telegram Bot]]
- fue modificado por [[PR 293]]
Para una persona, esto es documentación.
Para un agente, empieza a convertirse en un modelo navegable del sistema.
El salto importante: no crear notas manualmente
Si el experimento depende de que alguien mantenga cientos de notas a mano, morirá rápidamente.
La parte interesante sería automatizar la ingestión.
GitHub
Docs
Issues
PRs
Incidents
Deployments
        │
        ▼
   extractor
        │
        ▼
normalización
        │
        ▼
Obsidian Vault
        │
        ├── Markdown
        ├── properties
        └── links
Un agente como Codex o Cursor podría recorrer documentos existentes y generar una primera versión del vault. Después, otro proceso podría mantenerlo sincronizado con cambios en los sistemas fuente.
Pero hay una regla crucial:
la relación debe tener semántica.
No basta con producir miles de backlinks.
[[Service A]] -> [[Team B]]dice que existe una conexión.
owner: [[Team B]]dice qué significa.
Ese pequeño cambio acerca el vault a un verdadero modelo semántico.
Obsidian como interfaz, no necesariamente como backend
Aquí aparece probablemente la arquitectura más interesante.
No hace falta que Obsidian sea el sistema de retrieval final.
Puede convertirse en la capa legible por humanos:
                 ┌───────────────┐
                 │    Obsidian   │
                 │ human-readable│
                 └───────┬───────┘
                         │
                canonical knowledge
                         │
        ┌────────────────┴────────────────┐
        │                                 │
        ▼                                 ▼
     SQLite                         Graph / JSON
        │                                 │
        └──────────────┬──────────────────┘
                       ▼
                Retrieval service
                       │
                       ▼
                    Agents
El vault permite inspeccionar, corregir y discutir el conocimiento.
Una representación estructurada debajo permite:
- consultas rápidas;
- relaciones tipadas;
- filtros;
- versionado;
- scoring;
- APIs;
- integración con MCP;
- retrieval programático.
Así Obsidian deja de competir con Neo4j, PostgreSQL o un vector database. Cumple otra función: ser una vista humana y editable de la memoria estructurada del sistema.
¿Y el vector search?
Un Context Graph y un vector database resuelven problemas diferentes.
La búsqueda vectorial responde bien preguntas parecidas a:
¿qué documentos hablan de fallos de publicación?
El grafo responde mejor preguntas como:
¿qué componente publica, en qué host corre, qué PR lo modificó y qué incidentes afectaron esa ruta?
En la práctica, los dos pueden convivir:
pregunta del agente
      │
      ├── semantic search -> documentos relevantes
      │
      └── graph traversal -> entidades y relaciones
                         │
                         ▼
                    contexto final
                         │
                         ▼
                       LLM
El objetivo no es reemplazar RAG.
Es evitar que todo dependa de similitud semántica.
Un ejemplo: investigar un fallo
Supongamos que un agente recibe:
“¿Por qué el publicador automático no publicó el episodio?”
Sin contexto estructurado podría empezar buscando “publish”, después scheduler, después CI, después Telegram, después YouTube.
Con un grafo pequeño podría recuperar inmediatamente:
Auto Publisher
  ├── scheduled_by -> Systemd Timer
  ├── runs_on -> Oracle Runner
  ├── invokes -> YouTube Publisher
  ├── notifies -> Telegram Bot
  ├── configured_by -> Environment
  ├── modified_by -> PR 293
  └── related_incidents -> Incident 2026-09-24
El modelo sigue razonando.
Pero ya no necesita descubrir la topología básica del sistema desde cero.
Ese es exactamente el tipo de ventaja que muestra el experimento publicado por Uber.
Donde Obsidian se queda corto
El prototipo tiene límites claros.
Obsidian no ofrece por sí mismo:
- un esquema fuerte de tipos de objeto;
- constraints de relaciones;
- control transaccional;
- autorización granular por objeto;
- acciones operacionales tipadas;
- sincronización empresarial en tiempo real;
- traversals de grafo optimizados a gran escala;
- gobernanza equivalente a una plataforma como Palantir.
Incluso su Graph View representa principalmente enlaces entre notas; no convierte automáticamente cada relación en un edge tipado con semántica formal.
Por eso el camino razonable sería:
fase 1
Markdown + links + properties

fase 2
schema explícito

fase 3
extractor automático

fase 4
índice estructurado

fase 5
API / MCP para agentes

fase 6
acciones + permisos + feedback
Obsidian puede ser el laboratorio.
No tiene por qué ser el destino final.
Y aquí aparece otra idea de Uber: skills que evolucionan
Uber también describe una dirección especialmente interesante: registrar problemas encontrados durante las ejecuciones de skills y usar esas trazas para generar mejoras.
Si combinamos ambas ideas aparece un loop bastante potente:
agent execution
      │
      ▼
trace / failure / success
      │
      ▼
Context Graph
      │
      ├── qué contexto fue útil
      ├── qué relación faltaba
      ├── qué tool falló
      └── qué skill resolvió el problema
      │
      ▼
propuesta de mejora
      │
      ▼
skill actualizada
Ahora la memoria del sistema no solo ayuda al agente a resolver tareas.
También ayuda a mejorar la forma en que el agente trabaja.
El experimento que vale la pena hacer
Para un equipo pequeño, no empezaría instalando una plataforma compleja.
Empezaría con algo mucho más simple:
- tomar la documentación existente;
- convertirla en Markdown estructurado;
- definir 10 o 15 tipos de entidades importantes;
- definir un vocabulario pequeño de relaciones;
- generar el vault automáticamente;
- conectar un agente a ese conocimiento;
- medir cuánto disminuyen sus búsquedas, tokens, tiempo y errores.
Si el resultado funciona, entonces tiene sentido sustituir piezas.
Obsidian
   ↓
prototype
   ↓
structured store
   ↓
production Context Graph
La tecnología específica puede cambiar.
El principio permanece.
Un agente con más tokens no necesariamente tiene mejor contexto.
Y a medida que los agentes ejecuten tareas cada vez más largas, la capacidad de representar explícitamente qué existe, cómo se relaciona y dónde encontrarlo puede terminar siendo tan importante como el modelo que razona sobre esa información.