 Capital de Tokens
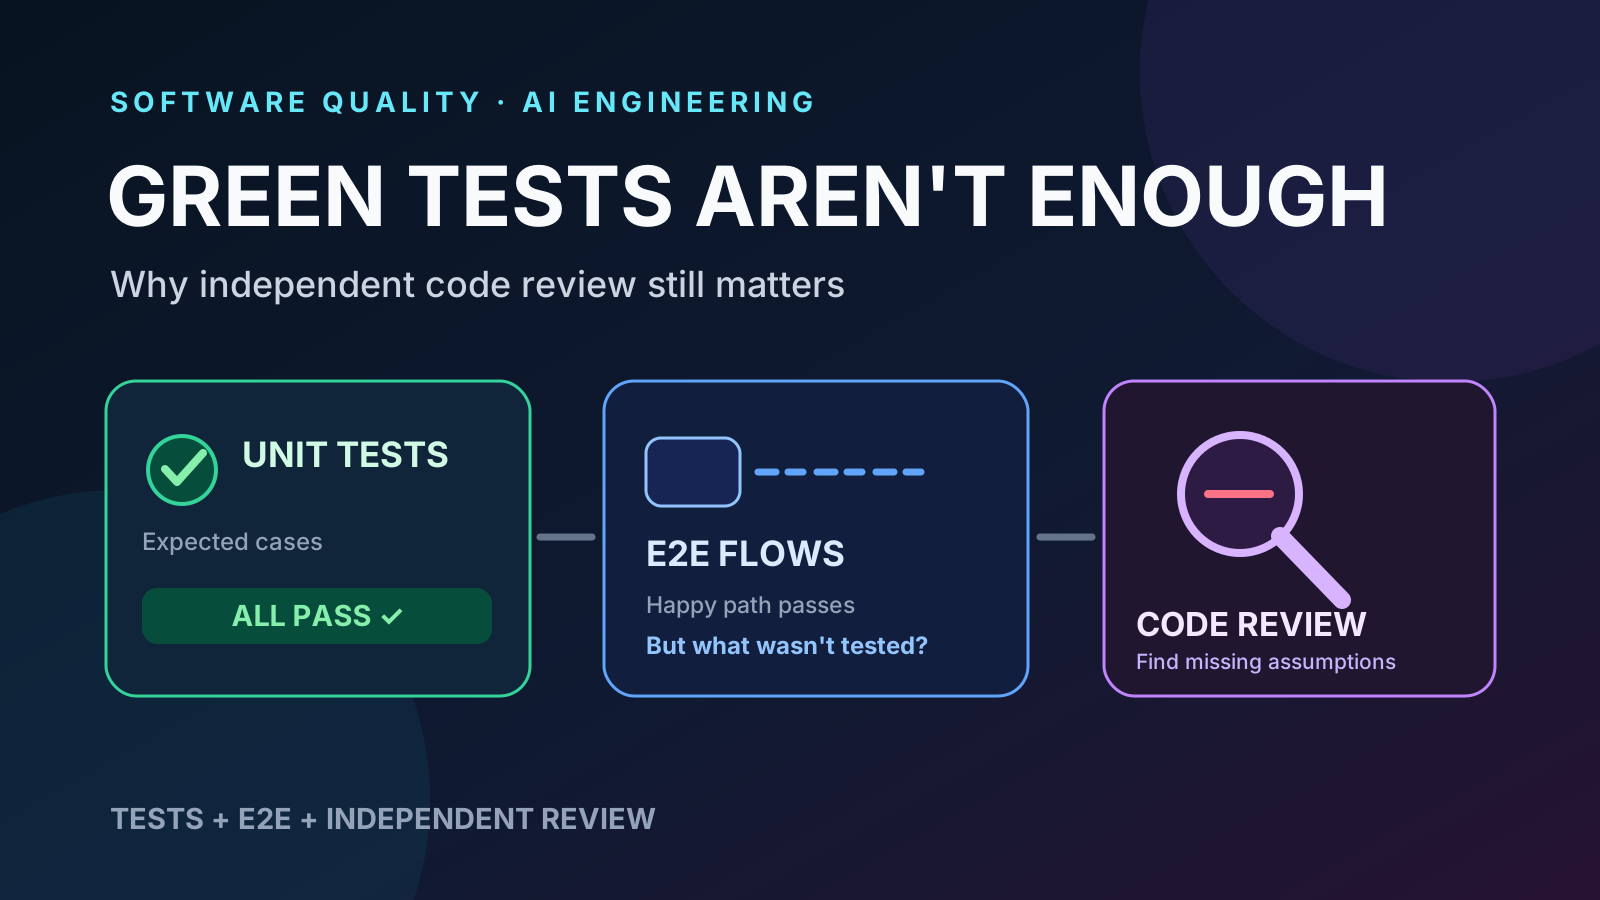
Hay una pregunta que aparece cada vez más en equipos que programan con asistentes de inteligencia artificial: si la IA escribe el código, genera los tests unitarios, ejecuta pruebas end-to-end (E2E) y todo pasa, ¿para qué necesitamos un code review?
La respuesta corta es que una suite verde demuestra que pasaron las comprobaciones que alguien decidió ejecutar; no demuestra que todas las comprobaciones necesarias existan.
No se trata de elegir entre pruebas o revisores. Son mecanismos distintos que se complementan. Y, cuanto más rápido generamos código con IA, más importante es distinguirlos.
La trampa de las pruebas que confirman el mismo supuesto
Imagina que un asistente implementa un endpoint para cancelar pedidos. El requisito real es sencillo:
Un usuario puede cancelar sus propios pedidos, pero nunca los de otra persona.
La implementación contiene una omisión:
def cancelar_pedido(pedido_id, usuario):
    pedido = repositorio.obtener(pedido_id)
    pedido.estado = "cancelado"
    repositorio.guardar(pedido)
    return {"estado": "cancelado"}
La función no comprueba si el pedido pertenece al usuario. Pero el test generado puede ser perfectamente verde:
def test_cancelar_pedido_propio():
    resultado = cancelar_pedido(id_pedido_propio, usuario_autenticado)
    assert resultado["estado"] == "cancelado"
El test demuestra que un usuario puede cancelar un pedido. No demuestra que otro usuario tenga prohibido cancelarlo. Incluso un E2E que inicia sesión, pulsa «Cancelar» y comprueba el resultado puede pasar si sólo utiliza el recorrido legítimo.
Aquí aparece un riesgo particular del desarrollo asistido por IA: si el código y sus tests nacen de la misma interpretación incompleta del requisito, ambos pueden repetir el mismo error. También puede ocurrir cuando una persona escribe código y pruebas; la IA no inventó este problema, pero puede multiplicar la cantidad de cambios producidos sin una segunda perspectiva.
Un revisor que contraste la implementación con el requisito debería preguntar: ¿dónde se valida la propiedad del pedido? Y pedir, como mínimo, una prueba negativa:
def test_no_permite_cancelar_pedido_ajeno():
    with pytest.raises(PermisoDenegado):
        cancelar_pedido(id_pedido_ajeno, usuario_autenticado)
La corrección no consiste en añadir un test decorativo. La autorización debe imponerse en el servidor, en la operación que modifica el estado, y probar que un acceso ajeno es rechazado.
Este ejemplo es deliberadamente simplificado. En una aplicación real también importan los controles en la capa de servicio, el aislamiento entre usuarios y la ausencia de cambios parciales cuando la operación falla.
Qué responde cada capa de calidad
| Capa | Pregunta principal | Qué puede dejar escapar |
|---|---|---|
| Tests unitarios | ¿Esta función produce el resultado esperado para los casos escritos? | Casos que nunca se imaginaron, requisitos mal interpretados, efectos entre componentes. |
| Tests de integración | ¿Funcionan correctamente juntos los componentes y servicios? | Caminos no ejercitados, fallos de diseño o seguridad fuera de sus escenarios. |
| E2E | ¿Puede completarse un flujo real de principio a fin? | Rutas alternativas, abuso de permisos, condiciones de carrera o errores no incluidos en los flujos. |
| Code review independiente | ¿Es correcto el cambio para el requisito y el sistema en conjunto? | También puede equivocarse: depende del contexto, la pericia y la profundidad de revisión. |
El revisor no sustituye a las pruebas: puede descubrir qué pruebas faltan y por qué. Las pruebas convierten ese hallazgo en una protección repetible frente a regresiones.
Seis problemas que una suite verde puede no ver
- Autorización y seguridad: se comprueba que el usuario legítimo puede actuar, pero no que uno no autorizado sea rechazado.
- Condiciones de carrera: dos trabajadores procesan simultáneamente el mismo evento. Las pruebas secuenciales pasan, la producción duplica el efecto.
- Errores de lógica de negocio: el sistema implementa con precisión una regla que nunca fue la solicitada.
- Contratos entre componentes: una API cambia silenciosamente el significado de un campo, aunque las pruebas de la función modificada sigan verdes.
- Privacidad y datos: el código envía información al destinatario equivocado o registra datos sensibles; el caso feliz no lo verifica.
- Mantenibilidad y arquitectura: funciona hoy, pero añade acoplamiento, complejidad o una dependencia innecesaria que complicará el siguiente cambio.
Las guías de Google Engineering Practices piden revisar no sólo el funcionamiento, sino también el diseño, la complejidad, la concurrencia y la calidad de los propios tests. OWASP destaca el valor de revisar la lógica de negocio, los controles de autorización y los límites de confianza que la automatización puede pasar por alto.
¿Y si tenemos un 90 % o incluso un 100 % de cobertura?
La cobertura indica qué líneas o ramas se ejecutaron durante los tests; no certifica que sus aserciones sean útiles o que se haya comprobado el comportamiento correcto.
Un test que llama a la función equivocada y apenas verifica que no explote puede elevar la cobertura sin aportar suficiente confianza. Por eso, Martin Fowler advierte que el porcentaje de cobertura resulta más útil para localizar zonas sin probar que como nota única de calidad.
Una meta de cobertura puede ser una buena señal de alarma, pero no debería convertirse en una licencia automática para hacer merge.
¿Puede otra IA hacer de reviewer?
Sí, como capa adicional. Un agente que no escribió el código puede leer el diff, comparar requisitos, proponer escenarios adversarios y sugerir tests. Es especialmente útil como primera revisión rápida.
Pero hay que distinguir independencia de contexto de garantía de corrección. Dos modelos pueden compartir sesgos, omitir información o aprobar una solución incorrecta. En cambios con permisos, pagos, privacidad o infraestructura, conviene incorporar revisión humana competente y, cuando proceda, pruebas especializadas de seguridad.
La revisión automática tampoco debería limitarse a decir «todo bien». Una buena observación identifica un riesgo concreto, dónde se manifiesta y cómo reproducirlo.
Un flujo práctico para cada pull request
- Definir la intención: qué cambia, qué no debe cambiar y quién puede realizar cada acción.
- Generar e implementar: usar IA o escribir manualmente, con tests unitarios y de integración que incluyan casos negativos.
- Ejecutar controles automáticos: lint, análisis estático, pruebas, build y E2E pertinentes.
- Revisar desde otra perspectiva: solicitar un code review independiente que busque fallos de lógica, seguridad, concurrencia, diseño y tests ausentes.
- Corregir y convertir hallazgos en regresiones: si aparece un bug, demostrarlo con un test que falle antes de la corrección y pase después, siempre que sea viable.
- Hacer merge con criterios explícitos: checks verdes, hallazgos relevantes resueltos y las aprobaciones correspondientes según el riesgo.
No todos los cambios requieren una auditoría profunda. Una corrección tipográfica y una modificación del sistema de autorizaciones tienen perfiles de riesgo muy distintos. La revisión puede ser proporcional, pero no conviene confundir «pasó los tests» con «está demostrado que es seguro y correcto».
Conclusión
Los tests responden: «¿Funciona lo que probamos?»
El E2E añade: «¿Funciona este recorrido completo?»
El code review pregunta algo diferente: «¿Probamos lo correcto, omitimos algún escenario importante y encaja este cambio en el sistema?»
La combinación es lo que aporta confianza: tests + E2E + revisión independiente, con profundidad acorde al riesgo. Ninguna capa es infalible; juntas hacen mucho más difícil que un supuesto equivocado llegue a producción.