 Capital de Tokens
En la carrera por construir mejores agentes de IA es fácil concentrarse en el modelo: más razonamiento, más contexto, más herramientas.
Uber está mostrando otra pieza que puede ser igual de importante: la infraestructura que le dice al agente qué necesita saber y cómo reutilizar lo aprendido durante sus ejecuciones.
La compañía describe dos iniciativas particularmente interesantes dentro de su Software Factory:
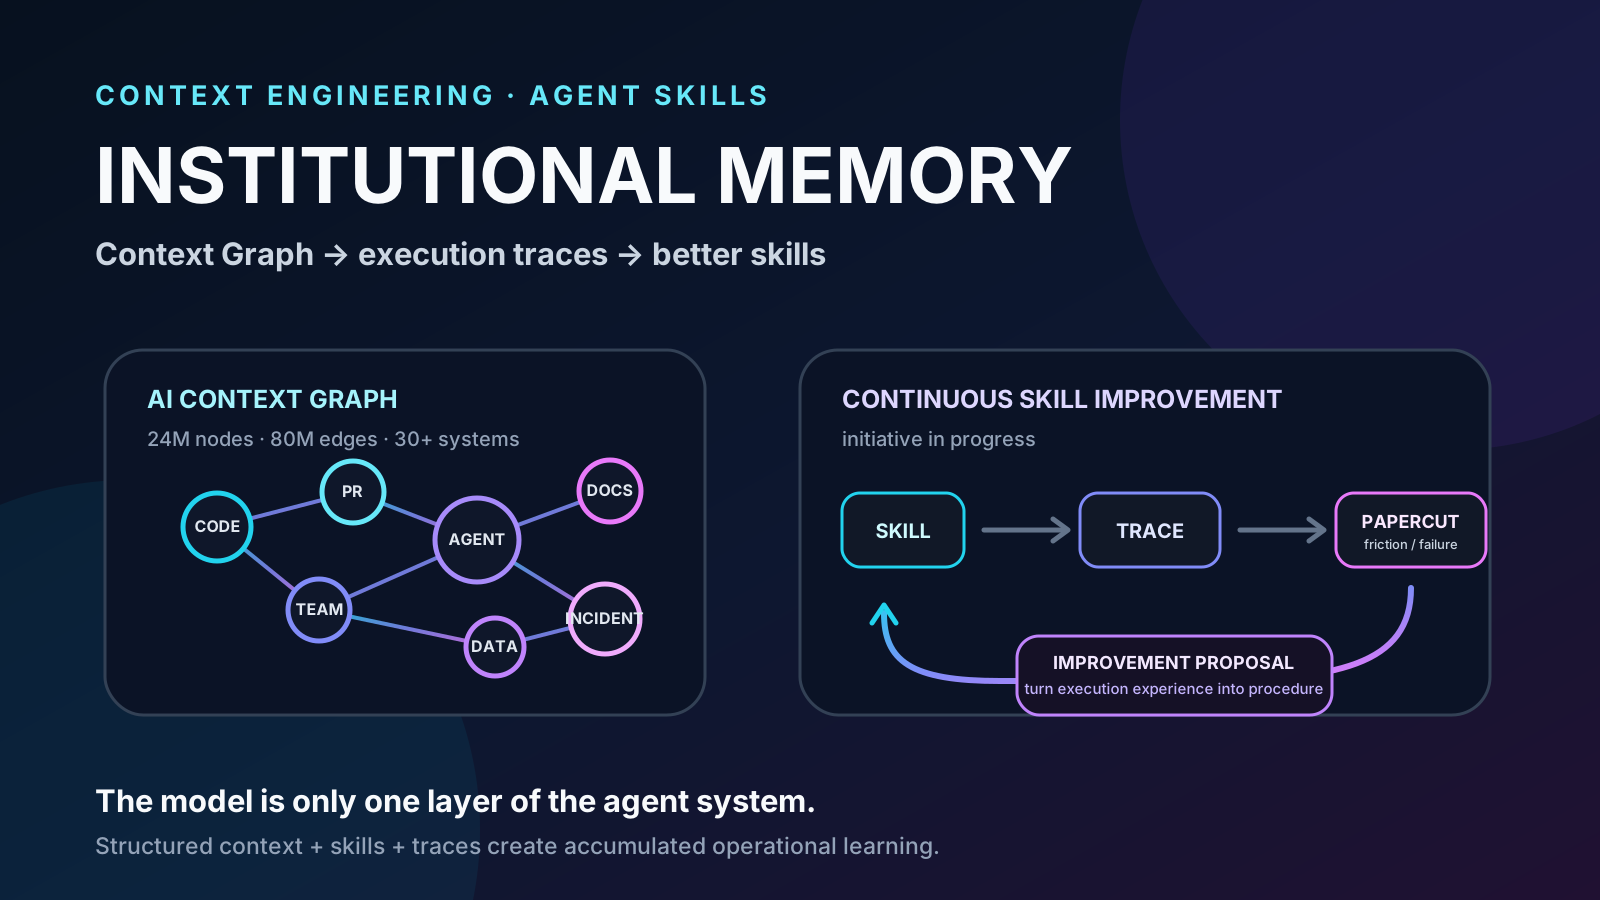
- un AI Context Graph que conecta conocimiento disperso por toda la organización;
- un proyecto de Continuous Skill Improvement que busca transformar las trazas de ejecución en propuestas automáticas de mejora para las skills.
La primera ya está en funcionamiento. La segunda sigue siendo una iniciativa en desarrollo.
Juntas apuntan a una arquitectura distinta para sistemas agentic a gran escala: no basta con tener un modelo potente. También hace falta una forma estructurada de darle memoria institucional y un ciclo operativo para convertir la experiencia acumulada en mejores procedimientos.
Información verificada el 29 de septiembre de 2026 a partir de la publicación oficial de Uber Engineering del 27 de agosto de 2026.
El problema no siempre es que el agente razone mal
Uber explica que, dentro de una base de código enorme y un ecosistema de datos con miles de tablas, muchos turnos de un agente se consumen simplemente intentando localizar información.
Eso cambia la naturaleza del problema.
Un agente puede tener un modelo excelente y aun así perder tiempo porque no sabe:
- qué servicio posee determinada responsabilidad;
- qué repositorio contiene la implementación relevante;
- qué equipo mantiene ese sistema;
- qué incidentes históricos están relacionados;
- qué pull requests cambiaron ese comportamiento;
- qué documento de arquitectura explica la decisión original;
- qué dataset o tabla usan realmente los analistas;
- qué despliegue introdujo un cambio.
Sin ese contexto, el agente empieza a explorar.
Abre archivos, busca documentación, consulta herramientas, lanza subagentes y añade cada vez más resultados a su ventana de contexto.
Cada búsqueda puede aumentar simultáneamente latencia, número de requests y tokens consumidos.
Uber resume el problema de forma muy directa: un agente sin grounding puede fallar lentamente, no barato.
Fuente: Uber Engineering — Running a Software Factory Efficiently at Uber Scale
AI Context Graph: convertir la organización en contexto consultable
Para reducir esa exploración, Uber construyó su AI Context Graph, una red que conecta conocimiento procedente de más de 30 sistemas internos.
Según Uber, el grafo contiene aproximadamente:
- 24 millones de nodos;
- 80 millones de relaciones;
- 86 tipos de nodos;
- 117 tipos de relaciones.
Entre las fuentes conectadas aparecen servicios, equipos de ingeniería, incidentes, pull requests, documentos de arquitectura, deployments, datasets y consultas históricas sobre el uso de tablas.
La diferencia importante frente a simplemente “meter más documentos en el prompt” es la estructura.
Un grafo puede representar relaciones explícitas:
servicio
  ↓ mantenido por
equipo
  ↓ modificó
pull request
  ↓ relacionado con
incidente
  ↓ usa
dataset
Eso permite que el agente consulte conexiones relevantes en vez de reconstruirlas desde cero en cada sesión.
En términos prácticos, se parece menos a una carpeta gigantesca de documentos y más a una capa de conocimiento operacional sobre la organización.
38 segundos frente a más de 20 minutos
Uber mostró un experimento especialmente ilustrativo.
Envió el mismo prompt al mismo modelo en dos condiciones: con grounding mediante el Context Graph y sin él.
Con el grafo, el agente consultó el uso histórico, identificó la tabla específica utilizada por más de 50 analistas y respondió correctamente en 38 segundos.
Sin el grafo, el agente:
- pasó alrededor de 20 minutos investigando;
- inspeccionó código de servicios;
- lanzó dos subagentes;
- encontró tres errores durante el proceso;
- y terminó concluyendo incorrectamente que el dataset no podía consultarse.
El resultado no demuestra que un Context Graph resuelva todos los problemas de agentes. Sí ilustra algo más general: la calidad del contexto disponible puede cambiar radicalmente el costo y la precisión de una ejecución incluso cuando el modelo es exactamente el mismo.
Del “modelo + prompt + tools” a una memoria institucional estructurada
Durante los últimos años muchas arquitecturas de agentes se han descrito esencialmente así:
modelo + prompt + herramientasPero al llevar agentes a organizaciones grandes aparece otra necesidad:
modelo + herramientas + contexto institucional estructuradoLa idea no es que el agente “recuerde” la empresa como lo haría una persona.
Es que exista una capa persistente donde las relaciones importantes ya estén modeladas y puedan recuperarse cuando una tarea las necesite.
Así, cada nueva ejecución no tiene que redescubrir desde cero quién mantiene un servicio, qué dataset es realmente usado o qué decisiones históricas explican la arquitectura actual.
En ese sentido, Context Engineering deja de ser solamente escribir un buen prompt.
Empieza a parecerse a diseñar la infraestructura que decide qué conocimiento entra al contexto, cuándo entra y mediante qué relaciones.
Uber ya opera miles de agent skills
La otra pieza interesante son las skills.
Uber afirma que sus ingenieros han creado más de 3.600 agent skills a lo largo del ciclo de desarrollo y que la plataforma registra más de 30.000 ejecuciones de skills al día.
Una skill encapsula una forma repetible de realizar una tarea: instrucciones, herramientas y procedimientos que permiten al agente ejecutar un workflow concreto.
Pero una skill escrita hoy inevitablemente encuentra casos que su autor no anticipó.
Por ejemplo:
- una API cambia ligeramente su formato;
- una instrucción resulta ambigua;
- aparece un workaround que todos los agentes terminan repitiendo;
- cierta secuencia de herramientas genera requests innecesarios;
- un fallo aparece repetidamente;
- los usuarios terminan corrigiendo siempre el mismo comportamiento.
Uber llama a estas pequeñas fricciones papercuts.
El problema es que, en muchos sistemas de agentes, esas experiencias desaparecen cuando termina la sesión.
Continuous Skill Improvement: convertir las trazas en aprendizaje operacional
Aquí aparece una de las ideas más interesantes de la publicación.
Dentro de sus iniciativas futuras, Uber describe Continuous Skill Improvement: está trabajando en una forma automatizada de registrar papercuts encontrados durante las ejecuciones de skills y generar actualizaciones de esas skills a partir de las trazas acumuladas.
Es importante el matiz: Uber lo presenta como una iniciativa en progreso, no como una capacidad completamente desplegada.
El loop conceptual podría representarse así:
Skill
  ↓
Ejecución
  ↓
Trace
  ↓
Fallo / fricción / workaround
  ↓
Propuesta de mejora
  ↓
Nueva versión de la skill
  ↓
Próxima ejecución
Eso cambia el valor de una ejecución.
La ejecución ya no produce únicamente el resultado solicitado. También puede producir datos operacionales sobre cómo mejorar el procedimiento que generó ese resultado.
Las traces se convierten en un activo
Los sistemas agentic generan enormes cantidades de señales:
- herramientas elegidas;
- orden de ejecución;
- errores;
- reintentos;
- tiempo consumido;
- tokens usados;
- correcciones humanas;
- rutas innecesarias;
- decisiones que terminaron funcionando.
Si esas señales simplemente se guardan como logs, sirven sobre todo para depuración.
Si se evalúan de forma sistemática, pueden convertirse en feedback para mejorar la plataforma.
Y si además pueden transformarse en actualizaciones revisables de las skills, aparece una forma de aprendizaje operacional acumulativo.
No es entrenamiento del modelo base.
Es mejorar continuamente la capa de procedimientos que rodea al modelo.
Una posible arquitectura para agentes que mejoran con el uso
La combinación de estas piezas sugiere una arquitectura bastante clara:
Context Graph
      ↓
qué necesita saber el agente

Skills
      ↓
cómo debe ejecutar el trabajo

Traces + evaluaciones
      ↓
qué ocurrió durante la ejecución

Continuous Skill Improvement
      ↓
qué debería cambiar para la próxima vez
El modelo sigue siendo importante, pero deja de cargar con toda la inteligencia del sistema.
Parte de esa inteligencia vive en el contexto estructurado, otra parte en las skills, y otra en los feedback loops.
El moat puede no estar únicamente en el modelo
Dos empresas pueden usar exactamente el mismo modelo y obtener resultados muy diferentes.
Una puede darle al agente acceso a miles de herramientas y esperar que explore.
La otra puede tener:
- un grafo que conecta su conocimiento interno;
- skills maduras para tareas repetibles;
- traces de todas las ejecuciones;
- evaluaciones automáticas;
- mecanismos para convertir errores recurrentes en mejoras.
El modelo es el mismo.
La infraestructura alrededor del modelo no.
Ahí puede estar una parte importante del valor de las próximas plataformas agentic: cada ejecución deja al sistema mejor preparado para la siguiente.
Uber todavía no afirma haber cerrado completamente ese ciclo. El Context Graph ya existe y se está integrando en más agentes; la mejora automática de skills desde trazas sigue en desarrollo.
Pero la dirección es significativa.
Pasamos de pensar en agentes como sesiones aisladas que reciben instrucciones a pensar en sistemas con memoria institucional y aprendizaje operacional acumulativo.
Eso se parece mucho más a una verdadera software factory.
Fuente
- Uber Engineering — Running a Software Factory Efficiently at Uber Scale — publicado el 27 de agosto de 2026.