 Capital de Tokens
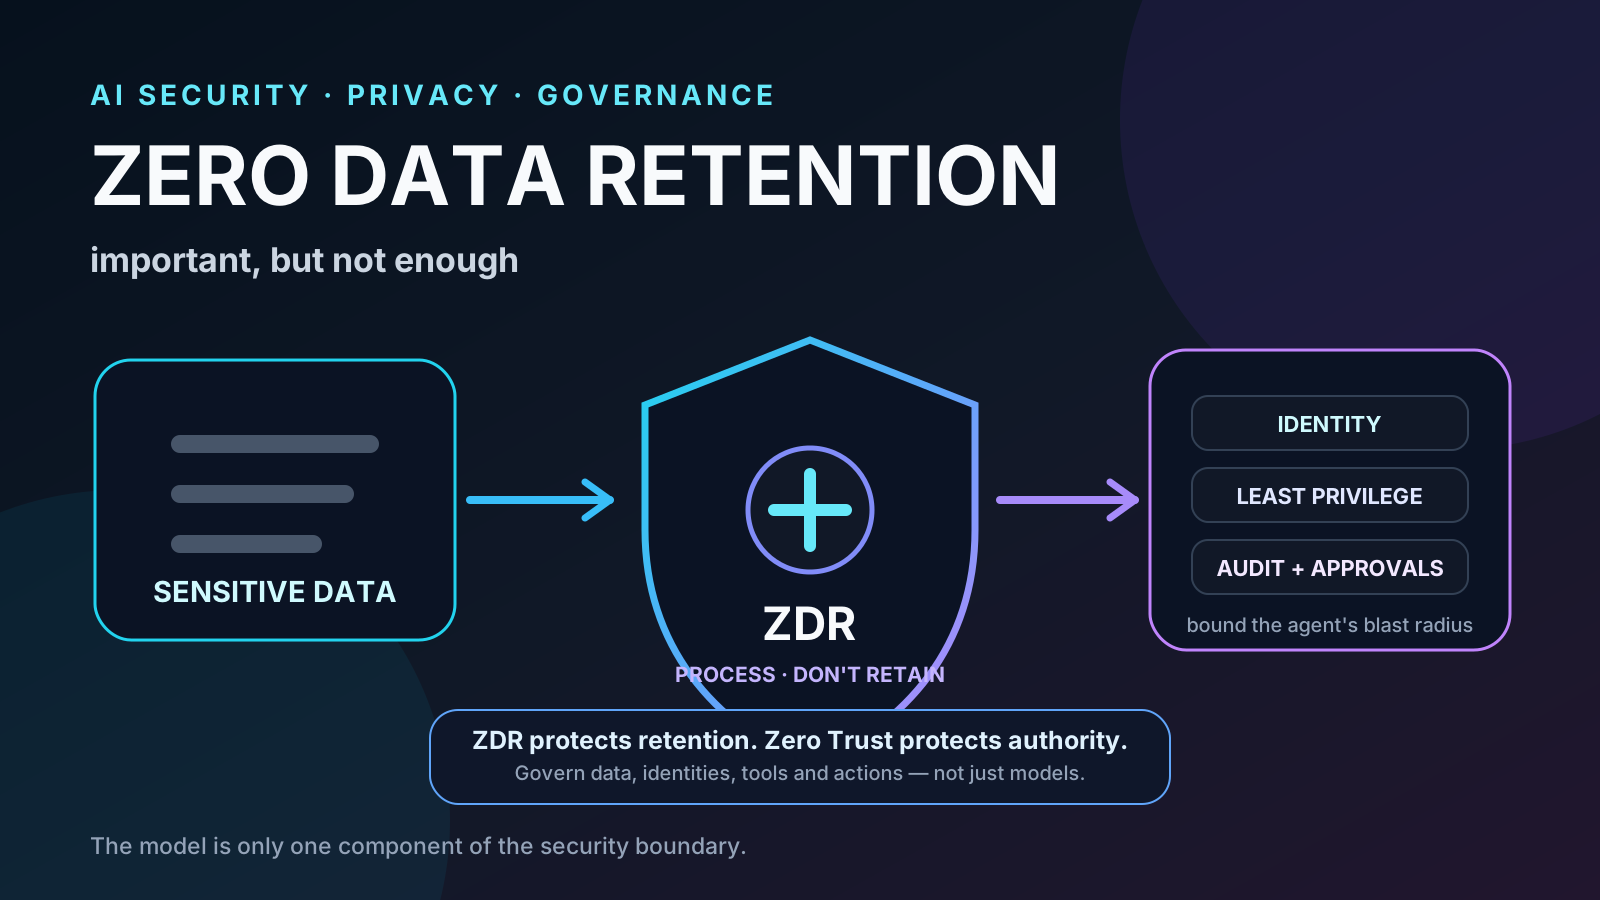
La discusión sobre gobernanza de inteligencia artificial suele empezar por la herramienta equivocada.
Una empresa descubre que sus empleados usan ChatGPT, Claude, Gemini o agentes conectados a sistemas internos y la reacción inmediata es crear una política específica para “la IA”, un comité nuevo, un catálogo de modelos permitidos y una larga lista de prohibiciones.
Pero hay una pregunta anterior y más importante:
¿Qué datos puede ver cada persona o agente, con qué identidad, durante cuánto tiempo y qué acciones puede ejecutar sobre ellos?
Esa es una de las ideas centrales del video de Platzi El costoso error de gobernar AI en empresas: el riesgo no vive únicamente en el modelo. Vive en los datos, los accesos, los permisos y las integraciones que rodean al modelo.
La analogía es útil: las empresas no crearon un “departamento de Excel” cuando las hojas de cálculo se volvieron ubicuas. Excel terminó siendo una herramienta transversal gobernada por las mismas reglas de identidad, acceso, auditoría y clasificación de datos que el resto del entorno empresarial.
Con la IA probablemente ocurra algo parecido.
La diferencia es que la IA —y especialmente los agentes— puede amplificar muchísimo el impacto de una mala configuración.
Información verificada el 27 de septiembre de 2026. Las políticas de retención y seguridad de los proveedores cambian con rapidez; conviene revisar la documentación contractual y técnica vigente antes de adoptar una configuración de producción.
El concepto que está ganando importancia: Zero Data Retention
Zero Data Retention (ZDR) describe una modalidad en la que un proveedor procesa una solicitud, produce una respuesta y no conserva el contenido de esa interacción después de completar el procesamiento, dentro del alcance exacto definido por el servicio.
OpenAI, por ejemplo, describe actualmente ZDR para clientes elegibles de API como un compromiso por el cual los prompts y las respuestas no se retienen después de procesar la solicitud y el contenido del cliente no queda disponible para revisión por personal de OpenAI.
Fuente: OpenAI — Offering Zero Data Retention for frontier models
La idea es poderosa porque cambia el modelo de riesgo:
sin ZDR

empresa
   │
   ▼
proveedor de IA
   │
   ├── procesa
   └── retiene durante un periodo
frente a:
con ZDR

empresa
   │
   ▼
proveedor de IA
   │
   ├── procesa
   └── no conserva el contenido después
       del procesamiento dentro del
       alcance ZDR contratado
Para cargas sensibles —código privado, documentos legales, datos de clientes, investigación interna o información financiera— reducir la cantidad de copias persistentes es una propiedad de seguridad muy valiosa.
Pero aquí aparece la primera distinción crítica.
ZDR no es lo mismo que “no usamos tus datos para entrenar”
Estas dos políticas se confunden constantemente.
No training significa que el proveedor no utiliza los prompts y respuestas para entrenar o mejorar sus modelos.
Zero Data Retention significa algo más estricto sobre persistencia: el contenido no queda almacenado después de procesar la solicitud, dentro del alcance ZDR.
Una plataforma puede perfectamente ofrecer:
no training = sí
retención = 30 días
Eso no es ZDR.
OpenAI indica que no utiliza datos empresariales para entrenar por defecto. En la API, los registros de monitoreo de abuso suelen conservarse hasta 30 días, con excepciones legales y de seguridad. El estado de aplicación tiene plazos propios según el endpoint; ciertos objetos persisten hasta su eliminación. ZDR requiere aprobación y no cubre todas las funciones ni sus excepciones: hay que revisar la matriz técnica vigente.
Fuentes:
- OpenAI — Privacidad para empresas
- OpenAI — Business data privacy, security, and compliance
- OpenAI — Data controls and endpoint retention
Por tanto:
NO TRAINING
¿usa el proveedor estos datos para mejorar modelos?
            │
            ▼
           no

ZDR
¿persiste el proveedor este contenido después
de procesar la solicitud?
            │
            ▼
           no
Son propiedades diferentes.
ZDR tampoco significa que “los datos nunca salen de la empresa”
El modelo necesita recibir el prompt para procesarlo.
Por tanto, incluso con ZDR:
- el contenido se transmite al servicio;
- la infraestructura del proveedor lo procesa;
- se genera una respuesta;
- el contenido deja de persistirse según las condiciones del servicio ZDR.
ZDR reduce la retención, no elimina el procesamiento remoto.
Y tampoco puede proteger automáticamente copias creadas fuera de ese límite.
Por ejemplo:
usuario
  │
  ▼
aplicación interna
  │
  ├── logs propios
  ├── tracing
  ├── base de datos
  └── analytics
  │
  ▼
API con ZDR
Si la aplicación interna guarda cada prompt en sus logs durante un año, activar ZDR en el proveedor no elimina esa copia.
Lo mismo ocurre con herramientas externas, conectores, sistemas de observabilidad o plugins que formen parte del flujo.
Por eso ZDR es una pieza de una arquitectura de privacidad, no una arquitectura de privacidad completa.
El problema más peligroso sigue siendo quién puede acceder a qué
Supongamos que un empleado solo debería tener acceso a una carpeta concreta.
Si conectamos un asistente de IA a un repositorio documental mucho mayor y le damos una credencial capaz de leerlo todo, hemos creado una inconsistencia:
humano
  │
  └── puede leer 20 documentos

agente usado por ese humano
  │
  └── puede leer 200.000 documentos
Aunque el modelo tenga ZDR perfecto, el diseño sigue siendo inseguro.
La pregunta correcta no es:
“¿Confiamos en este modelo?”
Sino:
“¿Cuál es el máximo daño que puede producir esta identidad si algo sale mal?”
Microsoft resume esta idea tratando a cada agente como un principal de primera clase: identidad propia, roles explícitos, permisos mínimos, herramientas controladas y trazabilidad de extremo a extremo.
Fuente: Microsoft Security — Least privilege for AI agents: Identity, access, and tool binding
El modelo recomendado se parece más a esto:
persona
  │
  ├── identidad
  └── permisos
        │
        ▼
      agente
        │
        ├── identidad propia
        ├── permisos mínimos
        ├── herramientas aprobadas
        └── auditoría
No:
persona
  │
  ▼
agente
  │
  └── credencial maestra de toda la empresa
Los agentes cambian la escala del problema
Un chatbot tradicional recibe texto y devuelve texto.
Un agente puede:
- abrir archivos;
- consultar correo;
- llamar APIs;
- modificar tickets;
- ejecutar código;
- crear recursos;
- enviar mensajes;
- borrar datos;
- desplegar software;
- encadenar varias herramientas sin intervención humana.
Esto cambia por completo la superficie de riesgo.
OWASP denomina Excessive Agency a la situación en la que un sistema basado en LLM recibe demasiadas funciones, demasiados permisos o demasiada autonomía. Una alucinación, una instrucción ambigua o una prompt injection pueden entonces convertirse en una acción real con consecuencias sobre confidencialidad, integridad o disponibilidad.
Fuente: OWASP — LLM06:2025 Excessive Agency
La frontera de seguridad deja de ser solo:
¿qué puede decir el modelo?y pasa a ser:
¿qué puede HACER el modelo?El blast radius importa más que la inteligencia del modelo
Cuando una organización evalúa un agente, suele dedicar mucho tiempo a medir precisión:
¿responde correctamente?
¿razona bien?
¿alucina?
Pero desde seguridad hay otra métrica igual de importante:
blast radius.
Es decir:
si este agente falla, es manipulado o interpreta mal una instrucción, ¿hasta dónde puede llegar el daño?
Dos agentes con exactamente el mismo modelo pueden tener perfiles de riesgo completamente distintos.
Agente A
- solo lectura
- una colección documental
- sin acceso a secretos
- sin acciones externas

Agente B
- correo
- repositorios
- nube
- base de datos
- permisos de escritura
- capacidad de ejecutar comandos
El modelo puede ser idéntico.
El blast radius no.
Microsoft recomienda una estrategia de defensa en profundidad donde los agentes se diseñen como componentes de alcance limitado, con permisos que empiezan en cero y se habilitan explícitamente.
Fuente: Microsoft Security — Defense in depth for autonomous AI agents
Shadow AI: prohibirlo todo puede empeorar el problema
Aquí aparece otra idea importante del video de Platzi.
Cuando una empresa simplemente prohíbe herramientas de IA pero los empleados siguen necesitando sus capacidades, aparece shadow AI:
política corporativa
      │
      └── "no usar IA"
              │
              ▼
empleado necesita resolver una tarea
              │
              ▼
cuenta personal / herramienta externa
              │
              ▼
copiar y pegar información corporativa
La organización pierde precisamente lo que pretendía ganar:
- visibilidad;
- logging;
- controles de identidad;
- contratos empresariales;
- retención definida;
- configuración central;
- capacidad de revocar acceso.
La alternativa no es permitir cualquier herramienta.
Es ofrecer rutas aprobadas suficientemente útiles para que el camino seguro sea también el camino fácil.
La gobernanza útil empieza por los datos
Una estrategia madura puede invertir el orden habitual.
En lugar de empezar preguntando:
“¿Qué IA dejamos usar?”
empezar por:
“¿Qué clases de datos tenemos y qué se puede hacer con cada una?”
Por ejemplo:
| Tipo de dato | Uso con IA |
|---|---|
| Público | modelos aprobados |
| Interno | servicios empresariales, no training |
| Confidencial | acceso restringido + retención controlada |
| Altamente sensible | ZDR cuando aplique + aislamiento + controles adicionales |
| Secretos / credenciales | no enviar al modelo salvo diseño explícito y justificado |
Después se aplica identidad y autorización.
datos
  │
clasificación
  │
identidad
  │
autorización
  │
herramientas
  │
modelo
El modelo está al final de la cadena, no al principio.
Un patrón práctico para agentes empresariales
Una arquitectura defensiva razonable tiene varias barreras independientes.
1. Una identidad por agente
No utilizar una credencial compartida por todos los agentes.
Cada agente debería tener una identidad rastreable con propietario, propósito y ciclo de vida definido.
2. Least privilege
El agente recibe únicamente las operaciones necesarias.
Si su función es resumir documentos:
readno debería obtener automáticamente:
write
delete
share
export
admin
3. Separar lectura y escritura
Un patrón especialmente útil es dividir el flujo:
agente lector
    │
    ▼
propuesta
    │
    ▼
validación
    │
    ▼
acción con privilegio mayor
Eso evita que la misma identidad que descubre información tenga automáticamente capacidad de modificar todo el sistema.
4. Herramientas allowlisted
El agente no necesita conocer cada API disponible.
Debe ver únicamente las herramientas necesarias para su tarea.
Microsoft recomienda explícitamente vincular agentes a conjuntos de herramientas preconfigurados y aprobados.
Fuente: Microsoft Security — Least privilege for AI agents
5. Aprobaciones para operaciones de alto impacto
Enviar dinero, borrar datos, desplegar producción, cambiar permisos o publicar externamente son buenos candidatos para una confirmación adicional.
La autonomía no tiene que ser binaria.
leer        → automático
analizar    → automático
proponer    → automático
borrar      → aprobación
publicar    → aprobación
escalar privilegios → aprobación
6. Auditoría completa
Debe ser posible responder:
- qué agente actuó;
- quién inició la ejecución;
- con qué identidad;
- qué herramientas llamó;
- qué recursos tocó;
- qué cambió;
- bajo qué aprobación.
Sin eso, investigar un incidente agéntico puede ser extraordinariamente difícil.
Dónde encaja ZDR dentro de todo esto
ZDR reduce una dimensión concreta del riesgo:
RIESGO TOTAL
│
├── retención por el proveedor ← ZDR ayuda aquí
├── permisos excesivos
├── credenciales
├── prompt injection
├── herramientas inseguras
├── shadow AI
├── logging interno
├── conectores externos
└── acciones autónomas
Por eso ZDR es importante, pero no sustituye Zero Trust.
Un sistema puede tener ZDR y seguir siendo peligrosísimo si entrega a un agente una credencial administrativa.
Y un sistema puede tener permisos muy bien diseñados pero incumplir requisitos de privacidad si conserva indefinidamente prompts sensibles.
Las dos dimensiones deben resolverse juntas.
Checklist antes de aprobar una plataforma de IA
Una evaluación útil debería preguntar al menos:
- ¿Se usan los datos para entrenamiento?
- ¿Cuál es la retención por defecto?
- ¿Existe ZDR y para qué endpoints o productos exactamente?
- ¿Qué excepciones existen?
- ¿Quién puede acceder al contenido retenido?
- ¿Qué ocurre con logs y telemetría?
- ¿Qué hacen los conectores o herramientas de terceros con los datos?
- ¿Respeta el agente los permisos del usuario o utiliza una identidad más poderosa?
- ¿Puede separarse lectura de escritura?
- ¿Hay approvals para acciones irreversibles?
- ¿Existen logs de auditoría suficientes?
- ¿Puede revocarse rápidamente una identidad o herramienta comprometida?
Esas preguntas suelen revelar mucho más que una etiqueta genérica de “IA empresarial segura”.
No necesitamos un departamento de Excel 2.0
La IA está pasando rápidamente de producto aislado a capacidad integrada dentro de casi todas las aplicaciones.
Eso hace poco sostenible crear una burocracia paralela para cada nuevo modelo.
La alternativa es más aburrida, pero probablemente más robusta:
identidad
+
clasificación de datos
+
least privilege
+
retención
+
auditoría
+
aprobaciones
+
seguridad de herramientas
y aplicar esas propiedades también a la IA.
La gobernanza madura no consiste en confiar ciegamente en los modelos ni en prohibirlos.
Consiste en conseguir que un modelo nunca pueda superar las fronteras que la organización ya decidió que una identidad, un dato o una acción deben tener.
Conclusión
Zero Data Retention es una de las propiedades más interesantes para cargas de IA sensibles porque reduce la cantidad de contenido que permanece almacenado después del procesamiento.
Pero ZDR no resuelve la pregunta más importante:
¿qué puede hacer el sistema mientras está procesando esos datos?
Esa respuesta depende de identidad, permisos, herramientas, aislamiento, aprobaciones y auditoría.
Con chatbots, una mala respuesta podía ser un problema de calidad.
Con agentes, una mala decisión puede convertirse en una llamada API, una modificación, una publicación o una eliminación.
Por eso la seguridad de la próxima generación de IA empresarial probablemente no se parecerá a un enorme “firewall para modelos”.
Se parecerá mucho más a principios que ya conocemos:
Zero Trust, least privilege, identidades separadas, datos clasificados, acciones auditables y retención mínima.
La IA no invalida esas reglas.
Las vuelve mucho más importantes.