 Capital de Tokens
Cuando construimos software tradicional, sabemos bastante bien qué significa probarlo.
Una función recibe una entrada, devuelve una salida y podemos escribir algo como:
assert sumar(2, 3) == 5Con un agente de IA la situación cambia.
Un agente puede decidir qué herramienta usar, en qué orden, cuántas veces intentarlo, qué información conservar y cómo redactar la respuesta final. Dos ejecuciones válidas pueden seguir caminos distintos.
Entonces aparece una pregunta incómoda:
¿cómo sabemos si el agente realmente hizo bien su trabajo?
Ahí entra el agent evaluator.
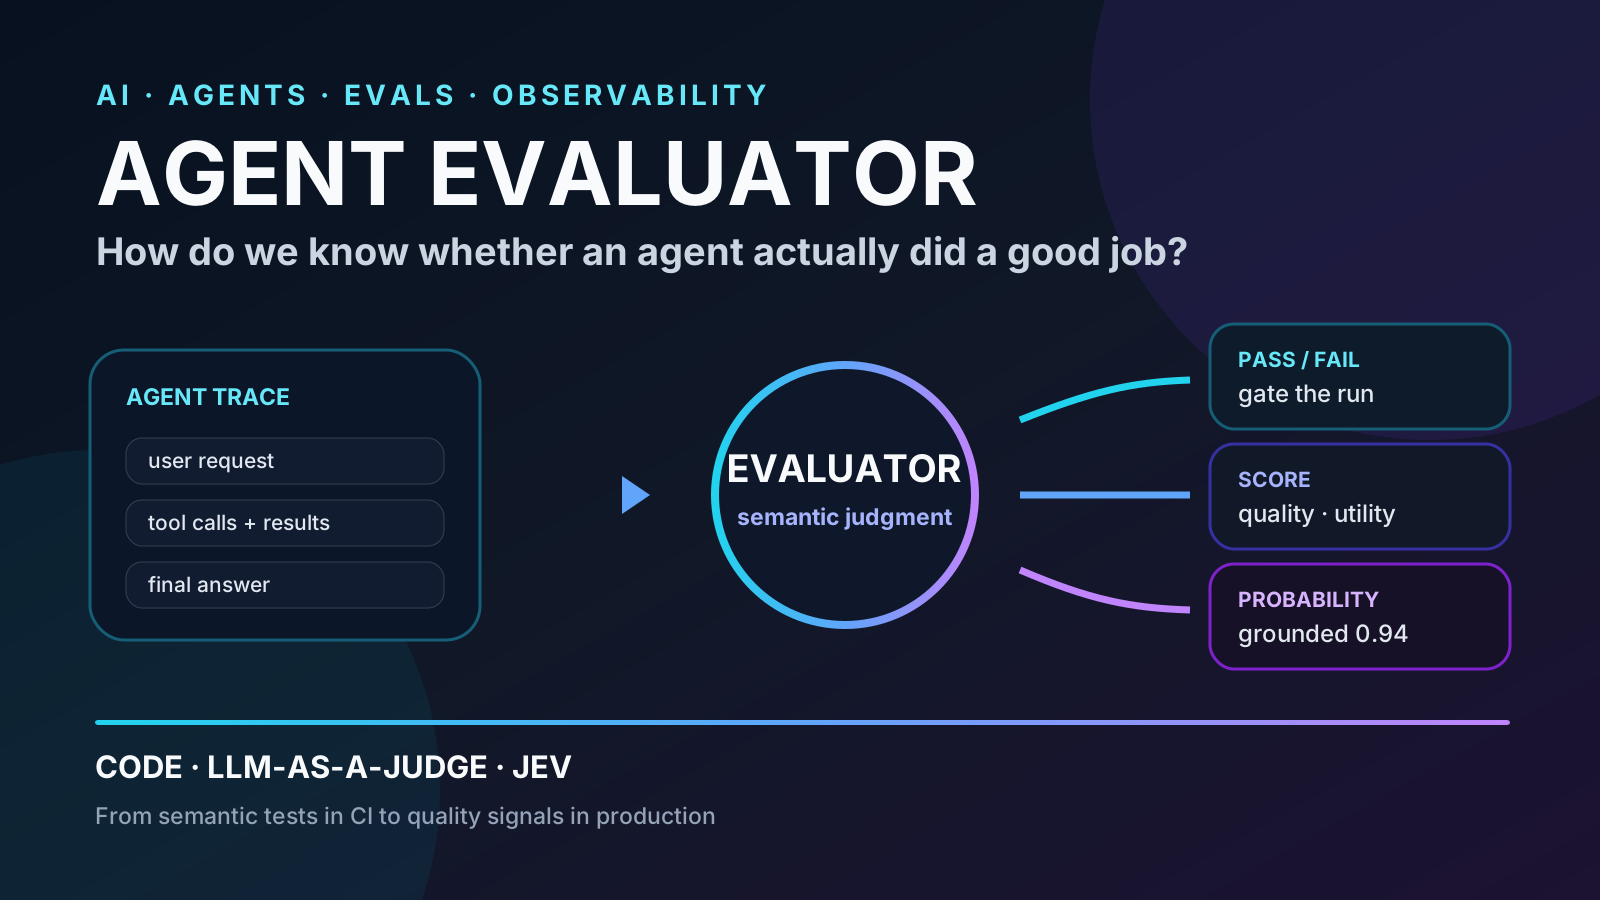
Un agent evaluator es un componente que observa una ejecución de un agente y la transforma en una señal evaluable: un booleano, una categoría, una puntuación, una probabilidad o varias métricas.
No es el agente que resuelve la tarea.
Es el sistema que juzga la ejecución.
La definición más simple
Podemos pensar en un agente así:
usuario
  │
  ▼
agente
  │
  ├── decide
  ├── llama tools
  ├── observa resultados
  ├── vuelve a decidir
  └── responde
        │
        ▼
     evaluator
        │
        ├── pass / fail
        ├── score
        ├── categoría
        └── probabilidad
El evaluator puede mirar solamente la respuesta final o puede recibir mucho más contexto:
- la petición original;
- la respuesta final;
- las tool calls;
- los resultados devueltos por las herramientas;
- la secuencia completa de pasos;
- una respuesta esperada;
- una rúbrica;
- etiquetas humanas anteriores.
A ese historial completo solemos llamarlo trace.
La evaluación convierte una trace, que es compleja y difícil de comparar, en señales que podemos almacenar, graficar, usar en CI o vigilar en producción.
Qué preguntas puede contestar
Un buen evaluator no necesita responder una pregunta filosófica como “¿este agente es bueno?”.
Es más útil dividirla en criterios pequeños.
Por ejemplo:
¿Respondió lo que pidió el usuario?
¿La respuesta está respaldada por los resultados de las tools?
¿Usó una búsqueda cuando era necesaria?
¿Inventó información que no aparece en la evidencia?
¿Eligió la herramienta correcta?
¿La respuesta es suficientemente útil?
¿Debe permitirse que esta ejecución continúe?
Cada pregunta puede convertirse en una métrica distinta.
Esto es importante porque un agente puede pasar unas dimensiones y fallar otras.
Por ejemplo, una respuesta puede ser:
relevancia       0.96
groundedness     0.91
tool_selection   PASS
completitud      0.72
policy_gate      PASS
Decir simplemente “8/10” perdería mucha información.
Primer tipo: evaluadores basados en código
La forma más sencilla de evaluar sigue siendo código determinista.
assert "weather" in called_tools
assert final_answer != ""
assert latency_ms < 3000
Este tipo de evaluator tiene ventajas enormes:
- es barato;
- rápido;
- reproducible;
- fácil de ejecutar miles de veces;
- perfecto para invariantes.
El problema aparece cuando queremos evaluar significado.
Podemos comprobar si el agente llamó a la herramienta de clima.
Es mucho más difícil codificar manualmente:
¿Utilizó correctamente el resultado de esa herramienta para responder la pregunta del usuario?
En una tarea abierta puede haber muchas respuestas correctas y muchas trayectorias válidas.
Intentar enumerarlas todas en código se vuelve impráctico.
Segundo tipo: LLM-as-a-judge
La solución que se volvió común con agentes modernos es usar otro LLM como juez.
El flujo es aproximadamente:
pregunta + trace + evidencia + rúbrica
                │
                ▼
              LLM
                │
                ▼
       explicación + score
Un LLM puede leer texto no estructurado y evaluar cosas difíciles de expresar con reglas rígidas.
Por ejemplo:
Evalúa del 1 al 5 si la respuesta resolvió realmente la petición del usuario.
Eso funciona sorprendentemente bien para muchas tareas.
Pero introduce tres problemas.
1. Variabilidad
El juez también es un modelo generativo.
La misma trace puede recibir puntuaciones ligeramente distintas entre ejecuciones.
2. Latencia
Para producir una decisión, el modelo genera tokens.
Aunque al final solo queramos un número, internamente estamos usando un sistema diseñado para generar lenguaje.
3. Coste
Si queremos evaluar miles o millones de traces de producción, cada llamada adicional importa.
Por eso la evaluación online suele obligar a elegir qué porcentaje de ejecuciones realmente vamos a juzgar.
Jev introduce una tercera forma
El artículo de LangChain Jev-as-a-Judge for Agent Evals explora otra posibilidad.
Jev, de TypeSafe AI, no está diseñado para generar texto.
Recibe un state y preguntas tipadas y devuelve directamente decisiones y probabilidades.
En otras palabras:
trace / state
     │
     ▼
    Jev
     │
     ├── Choice
     ├── Score
     └── Noul
Los tres tipos de pregunta cubren una gran parte de las necesidades habituales de evaluación.
Choice
Escoge una opción entre varias y devuelve probabilidades y confianza.
¿Cuál describe mejor esta ejecución?

- searched_appropriately
- searched_unnecessarily
- failed_to_search
Score
Evalúa contra una rúbrica ordenada.
¿Qué tan útil fue la respuesta?

1  inútil
2  pobre
3  aceptable
4  buena
5  excelente
Noul
Devuelve la probabilidad de que una afirmación binaria sea cierta.
¿La respuesta final está respaldada por la evidencia?

0.94
Esto elimina un paso habitual del LLM-as-a-judge: generar lenguaje para luego extraer una decisión estructurada.
Ya habíamos analizado qué está diciendo la comunidad técnica sobre Jev. Lo interesante aquí no es Jev como producto aislado, sino lo bien que su forma de salida encaja con el problema de evaluar agentes.
Qué hizo LangChain en su experimento
LangChain construyó un pequeño agente de clima con Deep Agents y guardó ejecuciones fijas en un dataset de LangSmith.
Eso es fundamental.
Si cada juez observara una ejecución distinta, sería difícil saber si una diferencia en la puntuación viene del evaluator o del propio agente.
Por eso compararon los jueces sobre exactamente las mismas traces.
El conjunto contenía cinco peticiones de clima. Para cada una almacenaron la respuesta y la ejecución completa, y luego midieron dos señales:
- quality, una puntuación continua;
- does_pass, una decisión binaria.
Un humano etiquetó las mismas ejecuciones para crear un oracle de referencia.
Después repitieron cada evaluación 100 veces con Jev, GPT-5.6 Luna, GPT-5.6 Terra y Claude Sonnet 4.6.
Según los resultados publicados por LangChain, Jev coincidió con el oracle humano en las 500 decisiones binarias del experimento. Terra alcanzó 99.8%, Luna 96.4% y Claude 80.0%.
En la puntuación continua, Jev mostró una varianza media por caso de 0.0000149. LangChain reportó una varianza 433 veces mayor para Luna, 913 veces mayor para Terra y 92 veces mayor para Claude.
También midieron coste y latencia. Jev promedió 0.44 segundos y aproximadamente $0.00035 por llamada en esa prueba.
Los números son llamativos, pero hay que leerlos correctamente.
LangChain deja claro que es un experimento pequeño y estrecho. Cinco traces de un agente de clima no demuestran que Jev vaya a ser mejor evaluator en todos los dominios.
Además, baja varianza no implica automáticamente alta exactitud.
Un juez podría ser extremadamente consistente y estar consistentemente equivocado.
Ese matiz es probablemente la parte más importante de todo el experimento.
LangSmith no es el evaluator
Aquí conviene separar dos piezas.
LangSmith puede almacenar traces, datasets, ejecuciones, experimentos y métricas.
El evaluator es quien produce el juicio.
Podemos visualizarlo así:
agente
  │
  ▼
trace ───────────────► LangSmith
                          │
                          ▼
                     evaluator
                   /      |      \
                código   LLM     Jev
                   \      |      /
                          ▼
                  métricas / scores
                          │
                          ▼
                 dashboards / CI
LangSmith sirve como infraestructura de evaluación y observabilidad.
El evaluator es una función —o un modelo— dentro de ese sistema.
Por qué esto se parece a testing
Aquí aparece una idea poderosa.
Un evaluator permite crear algo parecido a un test semántico.
En un pipeline tradicional podemos comprobar:
¿terminó el proceso?
¿hubo exception?
¿el JSON cumple el schema?
En un pipeline agentic también podemos preguntar:
¿la salida conserva los hechos importantes?
¿el título representa realmente el contenido?
¿la respuesta está grounded en las fuentes?
¿la tool elegida era adecuada?
¿la ejecución merece publicarse?
El código convencional sigue siendo la primera línea de defensa para invariantes.
El evaluator añade una capa para propiedades que dependen del significado.
Ejemplo: evaluar un pipeline de contenido
Supongamos un pipeline:
fuentes
   ↓
extracción
   ↓
guion
   ↓
título + descripción
   ↓
publicación
Antes de publicar podríamos ejecutar varios evaluators.
grounded_in_sources     0.97
covers_main_claims      0.92
title_matches_script    0.95
description_is_faithful 0.98
publishable             0.96
Entonces el código decide:
if grounded_in_sources < 0.90:
    send_to_review()

if title_matches_script < 0.85:
    regenerate_title()

if publishable > 0.95:
    publish()
La IA hace el juicio semántico.
El software conserva el control de la política.
Esa separación es muy importante.
Offline evals y online evals
Los evaluators suelen aparecer en dos lugares distintos.
Offline
Antes de desplegar una versión nueva del agente.
cambio de prompt
      ↓
dataset de traces
      ↓
evaluators
      ↓
comparar con baseline
      ↓
CI pass / fail
Esto ayuda a detectar regresiones.
Un cambio puede pasar todos los unit tests y, aun así, empeorar la calidad semántica de las respuestas.
Online
Sobre ejecuciones reales de producción.
producción
   ↓
traces
   ↓
evaluators
   ↓
series temporales
   ↓
alertas
Aquí podemos detectar degradaciones que nunca aparecieron en el dataset de pruebas.
Por ejemplo:
groundedness cayó de 0.94 a 0.81 después del último deploy.
Eso convierte la calidad del agente en una señal operacional observable.
Un evaluator tampoco debe gobernar solo
La tentación es convertir la puntuación del evaluator en verdad absoluta.
Eso sería un error.
Un sistema serio combina varias capas:
invariantes deterministas
        +
evaluators semánticos
        +
datasets etiquetados
        +
revisión humana
        +
monitorización
El evaluator también necesita ser evaluado.
Hay que comprobar periódicamente si sus resultados siguen alineados con los juicios humanos que realmente nos importan.
Especialmente cuando sus decisiones bloquean acciones costosas, destructivas o irreversibles.
La idea que cambia la arquitectura
Lo más interesante del concepto de agent evaluator no es añadir “otro modelo” al sistema.
Es separar dos responsabilidades:
AGENTE
¿Qué debo hacer?

EVALUATOR
¿Qué tan bien lo hice?
Esa separación permite construir loops de feedback.
agente
  ↓
ejecución
  ↓
evaluator
  ↓
métrica
  ↓
regresión / alerta / aprendizaje
  ↺
Cuando un agente deja de ser una demo y empieza a operar continuamente, esa capa se vuelve cada vez más importante.
Porque ejecutar una tarea no basta.
Necesitamos una manera sistemática de saber si las ejecuciones siguen siendo buenas.
Y eso es, en esencia, lo que hace un agent evaluator.