 Capital de Tokens
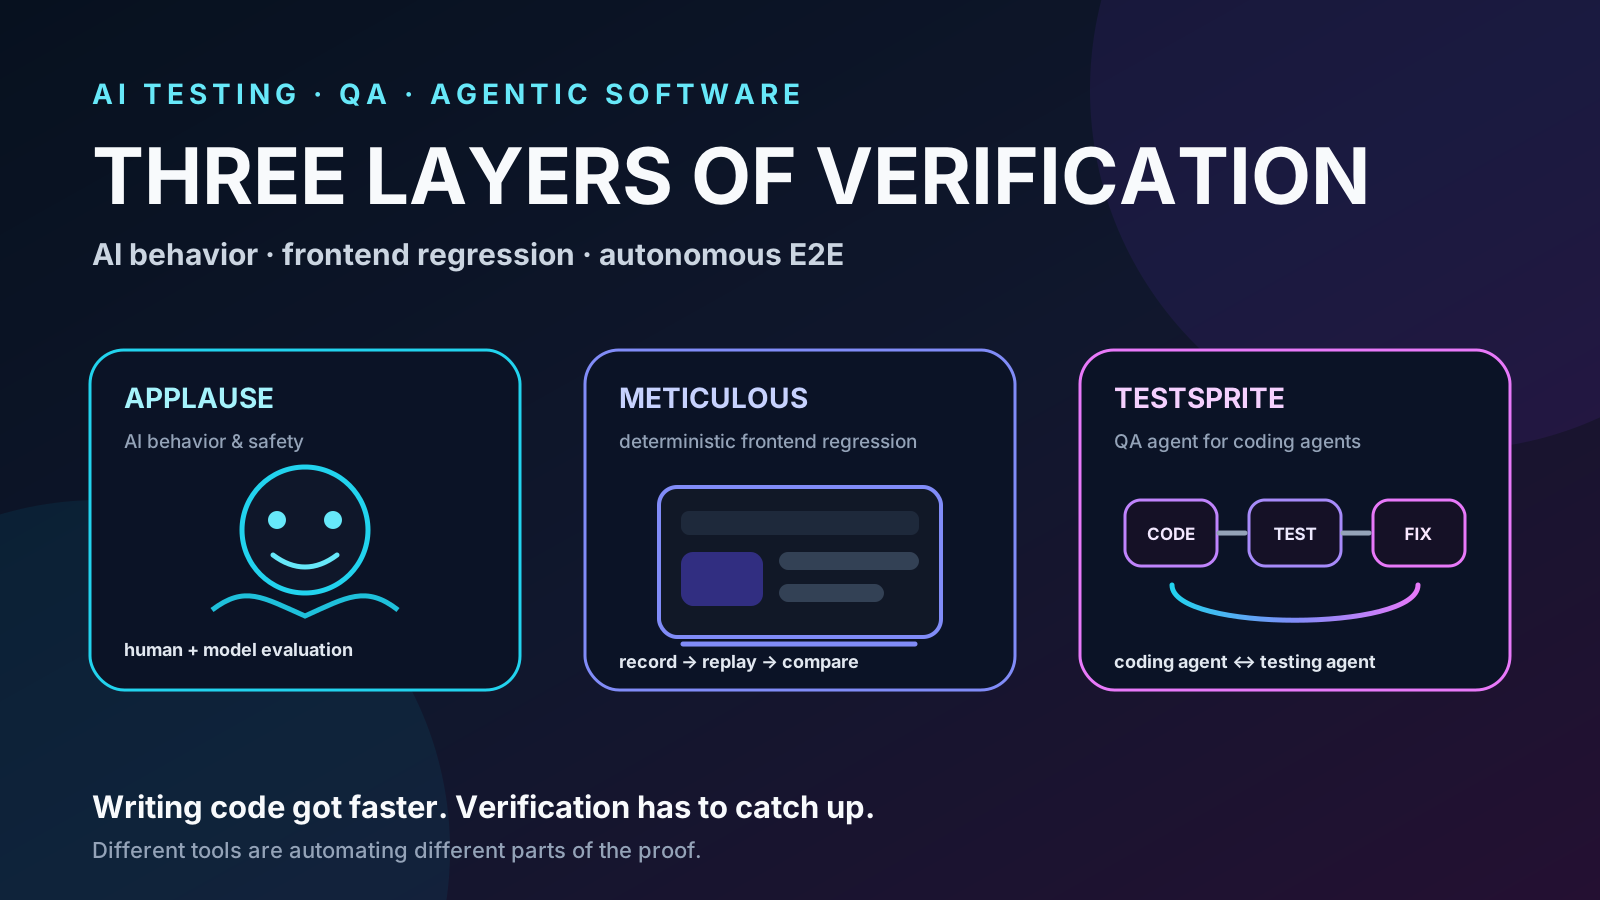
La aceleración del desarrollo con agentes de código está creando un problema curioso: escribir software puede volverse más rápido que demostrar que funciona.
En ese contexto están apareciendo herramientas que se venden bajo una etiqueta parecida —AI testing— pero que en realidad resuelven problemas bastante distintos.
Tres ejemplos ilustran bien esa fragmentación:
- Applause pone el foco en evaluar aplicaciones y agentes de IA en condiciones reales, combinando automatización, modelos evaluadores, expertos y usuarios.
- Meticulous automatiza principalmente la regresión de interfaces web observando interacciones y reproduciéndolas de forma determinista.
- TestSprite intenta convertirse en un agente de QA autónomo que genera, ejecuta y diagnostica pruebas E2E y que puede integrarse directamente con coding agents como Codex.
La comparación importa porque estas herramientas no son sustitutos perfectos. Representan tres capas distintas del problema de la calidad.
Información verificada el 29 de septiembre de 2026 a partir de documentación y páginas oficiales de Applause, Meticulous y TestSprite.
El cuello de botella se está moviendo
Durante años, automatizar testing significaba principalmente escribir y mantener suites con frameworks como Playwright, Cypress, Selenium, pytest o similares.
Los coding agents cambian la economía del proceso.
Si un agente puede producir varias modificaciones en minutos, el problema deja de ser únicamente:
¿cómo escribimos más código?
y empieza a ser:
¿cómo verificamos, con suficiente evidencia, todo lo que ese agente acaba de cambiar?
Una suite unitaria verde ayuda, pero no necesariamente demuestra que:
- una pantalla todavía carga;
- un checkout sigue funcionando de extremo a extremo;
- una API rechaza entradas incorrectas;
- un agente seleccionó la herramienta correcta;
- un sistema RAG recuperó la información adecuada;
- una respuesta generativa es segura y útil.
Ahí es donde empiezan a separarse Applause, Meticulous y TestSprite.
1. Applause: probar el comportamiento del sistema de IA
Applause es el más distinto de los tres.
No se presenta simplemente como un generador automático de tests. Su propuesta para IA está orientada a evaluar sistemas generativos y agentic con una combinación de automatización y juicio humano.
En sus servicios de Agentic AI Testing, Applause describe evaluaciones sobre:
- precisión de tool calls;
- relevancia del retrieval;
- completitud de tareas;
- comportamiento de workflows multi-step;
- RAG;
- coordinación entre modelos o agentes;
- seguridad y red teaming;
- sesgos, toxicidad y otros riesgos.
También enfatiza el uso de human-in-the-loop y expertos de dominio para encontrar fallos difíciles de reducir a una aserción clásica.
Eso tiene sentido porque un sistema de IA no siempre produce exactamente la misma salida para la misma entrada.
Una prueba tradicional podría preguntar:
esperado == obtenidoPero un agente necesita evaluaciones más cercanas a:
¿eligió la herramienta correcta?
¿usó los argumentos correctos?
¿recuperó evidencia relevante?
¿terminó la tarea?
¿su acción fue segura?
¿la respuesta final satisface el objetivo?
Applause dice que puede revisar esas trazas paso a paso y combinar evaluadores automáticos con humanos.
En otras palabras, su terreno natural es la calidad del comportamiento del sistema de IA, no solamente si un botón continúa funcionando.
Fuente oficial: Applause — Agentic AI Testing
Dónde encaja mejor
Applause tiene más sentido cuando el producto que debe ser probado es la propia experiencia de IA:
- agentes que ejecutan acciones;
- asistentes conversacionales;
- sistemas RAG;
- voz;
- flujos regulados;
- productos donde una respuesta plausible pero incorrecta puede ser un fallo serio.
Además, su modelo es claramente más cercano a un servicio empresarial administrado que a instalar una simple dependencia en un repositorio.
2. Meticulous: convertir uso real en tests de regresión
Meticulous ataca otro problema.
Su especialidad es el frontend.
La herramienta añade un recorder a entornos locales, staging o previews y observa cómo se utiliza la aplicación. A partir de esas interacciones construye una suite de tests visuales end-to-end que evoluciona conforme cambia el producto.
El flujo conceptual es:
desarrolladores/usuarios usan la app
        ↓
Meticulous registra los flujos
        ↓
genera cobertura E2E
        ↓
se abre un pull request
        ↓
reproduce los workflows
        ↓
detecta regresiones antes del merge
Un detalle especialmente interesante es cómo intenta reducir el flakiness.
Según su documentación, por defecto puede guardar y reproducir las respuestas originales del backend. De esa forma una ejecución no depende de que los datos remotos hayan cambiado entre una sesión y otra.
La compañía también afirma usar un scheduler determinista construido a nivel de Chromium para controlar fuentes de no determinismo.
Fuente oficial: Meticulous
Qué intenta eliminar
El objetivo de Meticulous no es que un LLM invente cientos de tests a partir del código.
Su propuesta es más parecida a:
observa qué hace realmente la aplicación y convierte esas interacciones en una red de regresión que no tengas que mantener manualmente.
Ese enfoque puede ser especialmente atractivo para aplicaciones web complejas donde una gran suite de Playwright o Cypress empieza a consumir una cantidad considerable de ingeniería solo en mantenimiento.
Meticulous soporta stacks como React, Next.js, Vue, Angular y SvelteKit, además de integraciones con GitHub y GitLab.
3. TestSprite: el QA agent que trabaja junto al coding agent
TestSprite representa la tercera dirección: agentificar el testing.
Su propuesta es que el sistema no se limite a generar archivos de test. El agente debería entender qué intenta hacer el producto, ejecutar pruebas contra la aplicación, recopilar evidencia, diagnosticar el fallo y devolver esa información al coding agent.
Su documentación describe un ciclo parecido a:
Codex implementa
      ↓
TestSprite genera / selecciona tests
      ↓
ejecuta UI + API + workflows
      ↓
recopila screenshot, DOM y pasos
      ↓
propone una causa y un fix
      ↓
Codex corrige
      ↓
se vuelve a verificar
TestSprite puede trabajar a partir de un PRD, documentación de API o inferir intención desde el propio proyecto.
También ejecuta casos en infraestructura cloud y mantiene evidencia de los fallos, incluyendo screenshots, snapshots del DOM y sesiones reproducibles.
Fuente oficial: TestSprite
Lo más interesante: Codex como cliente de QA
TestSprite publica una integración específica para OpenAI Codex.
Su comando:
testsprite setup --agent codexinstala una skill de verificación en el repositorio para que Codex conozca los comandos, formatos y códigos de salida necesarios para conducir el loop de testing.
La idea es importante más allá de TestSprite.
Estamos pasando de:
developer → test frameworka:
coding agent → testing agent → coding agentcon el desarrollador supervisando el ciclo.
TestSprite también ofrece integración mediante MCP y menciona herramientas como Claude Code, Cursor, VS Code y otros entornos agentic.
Fuente oficial: TestSprite — Testing Tool for Codex
No son tres competidores directos
Si se meten en una sola tabla de “herramientas de testing con IA”, se pierde la diferencia más importante.
| Herramienta | Pregunta principal |
|---|---|
| Applause | ¿Mi sistema de IA se comporta correctamente, de forma segura y útil en condiciones reales? |
| Meticulous | ¿Este cambio rompió algún flujo de mi interfaz web? |
| TestSprite | ¿Puede un agente de QA verificar automáticamente lo que acaba de construir mi coding agent? |
En un sistema suficientemente grande, incluso podrían coexistir.
Por ejemplo:
                    SOFTWARE
                       │
          ┌────────────┼────────────┐
          │            │            │
          ▼            ▼            ▼
     Meticulous    TestSprite    Applause
     frontend      E2E + API     AI behavior
     regression    agent loop    evals / safety
No necesariamente habría que usar las tres. La arquitectura muestra que cada una observa un tipo distinto de fallo.
El punto común: reducir trabajo de verificación manual
Aunque parten de lugares diferentes, existe una tendencia compartida.
El testing está moviéndose de escribir manualmente cada prueba hacia sistemas que intentan descubrir qué probar, ejecutar la verificación y mantener la cobertura por sí mismos.
Meticulous aprende de interacciones.
TestSprite aprende del producto y sus requisitos.
Applause intenta combinar evaluadores automáticos con personas y expertos capaces de juzgar comportamientos que no pueden reducirse fácilmente a un assert.
Eso sugiere que el futuro del QA puede tener varias capas:
unit tests
    ↓
integration tests
    ↓
agent-generated E2E
    ↓
deterministic regression replay
    ↓
AI evals
    ↓
human / domain expert evaluation
    ↓
red teaming
La IA no elimina necesariamente las capas anteriores. Puede aumentar la cantidad de software que necesita ser verificado y, por tanto, volverlas todavía más importantes.
La pregunta decisiva para equipos que usan coding agents
Hay una consecuencia particularmente relevante para Codex, Claude Code y sistemas similares.
Hasta ahora, un agente podía decir:
implementación terminada, tests pasan.
Pero esa frase vale exactamente lo que valgan los tests existentes.
Si el cambio no tenía cobertura, el agente podía estar muy seguro y aun así entregar una regresión.
Herramientas como TestSprite y Meticulous intentan ampliar esa evidencia automáticamente. Applause ataca una capa todavía más difícil: comprobar si un sistema de IA hizo realmente lo correcto.
Eso convierte el testing en una pieza central del harness del agente.
No basta con darle al modelo acceso al repositorio, terminal y documentación. También necesita una forma confiable de responder:
¿cómo sé que lo que acabo de hacer funciona?
Conclusión
La etiqueta AI testing es demasiado amplia.
Applause, Meticulous y TestSprite muestran tres posibles futuros del QA:
- evaluar sistemas de IA con automatización y juicio humano;
- transformar comportamiento real de la interfaz en regresiones deterministas;
- construir agentes de testing capaces de cerrar el loop con los agentes que escriben código.
La tendencia más importante no es que la IA vaya a “reemplazar los tests”.
Es que a medida que los agentes producen cambios más rápido, la verificación necesita convertirse en una capacidad automática, continua y tan agentic como la generación de código.