 Capital de Tokens
Si abres Chat Jimmy y le haces una pregunta, la primera impresión no es que el modelo sea más inteligente que los grandes modelos frontier.
La impresión es otra:
responde a una velocidad absurda.
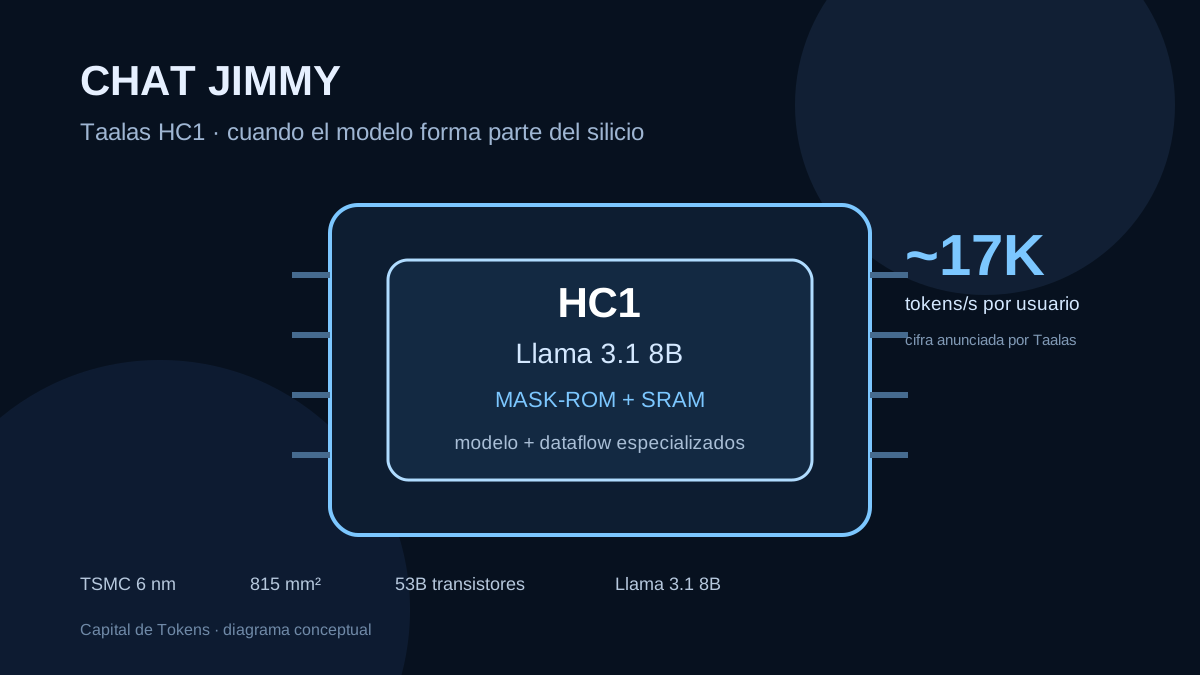
Detrás de esa experiencia hay una demostración de hardware llamada Taalas HC1, diseñada para ejecutar Llama 3.1 8B de una forma muy distinta a una GPU convencional.
Taalas resume su filosofía con una frase provocadora:
The Model is The Computer.
La idea es llevar la especialización tan lejos que el modelo deje de comportarse simplemente como un conjunto de pesos que una máquina carga desde memoria y pase a formar parte de la propia estructura del hardware que lo ejecuta.
Eso convierte a Chat Jimmy en algo más interesante que otro chatbot.
Es una ventana hacia una pregunta mucho más profunda:
¿qué ocurre si sacrificamos gran parte de la flexibilidad de una GPU para construir silicio alrededor de un modelo específico?
Qué es exactamente Chat Jimmy
Chat Jimmy es el chatbot público con el que Taalas demuestra su primer acelerador, HC1 Technology Demonstrator.
Según la ficha oficial de Taalas, HC1 ejecuta Llama 3.1 8B y está fabricado en TSMC 6 nm, con un die de 815 mm² y aproximadamente 53.000 millones de transistores. La compañía presenta además una configuración de servidor de 2,5 kW.
La cifra que ha atraído más atención es el rendimiento anunciado:
aproximadamente 17.000 tokens por segundo por usuario.
Taalas publica esa cifra para Llama 3.1 8B bajo una prueba con secuencias 1k/1k. Por tanto, no debe interpretarse como una garantía de 17.000 tokens/s para cualquier prompt, longitud de contexto o carga concurrente.
Aun así, la magnitud no parece ser solamente una gráfica de marketing. EE Times probó el chatbot y reportó más de 15.000 tokens/s durante su propia experiencia, mientras que Taalas indicó que internamente se acerca a 17.000 tokens/s bajo determinadas condiciones.
La misma cobertura también señala un detalle importante: la versión del modelo utilizada está cuantizada agresivamente.
La velocidad es real, pero también lo son los compromisos que la hacen posible.
El problema que Taalas intenta atacar: mover los pesos
En una GPU moderna, ejecutar un LLM no consiste solamente en hacer multiplicaciones de matrices.
Una parte enorme del problema consiste en alimentar continuamente esas unidades de cómputo con los pesos del modelo.
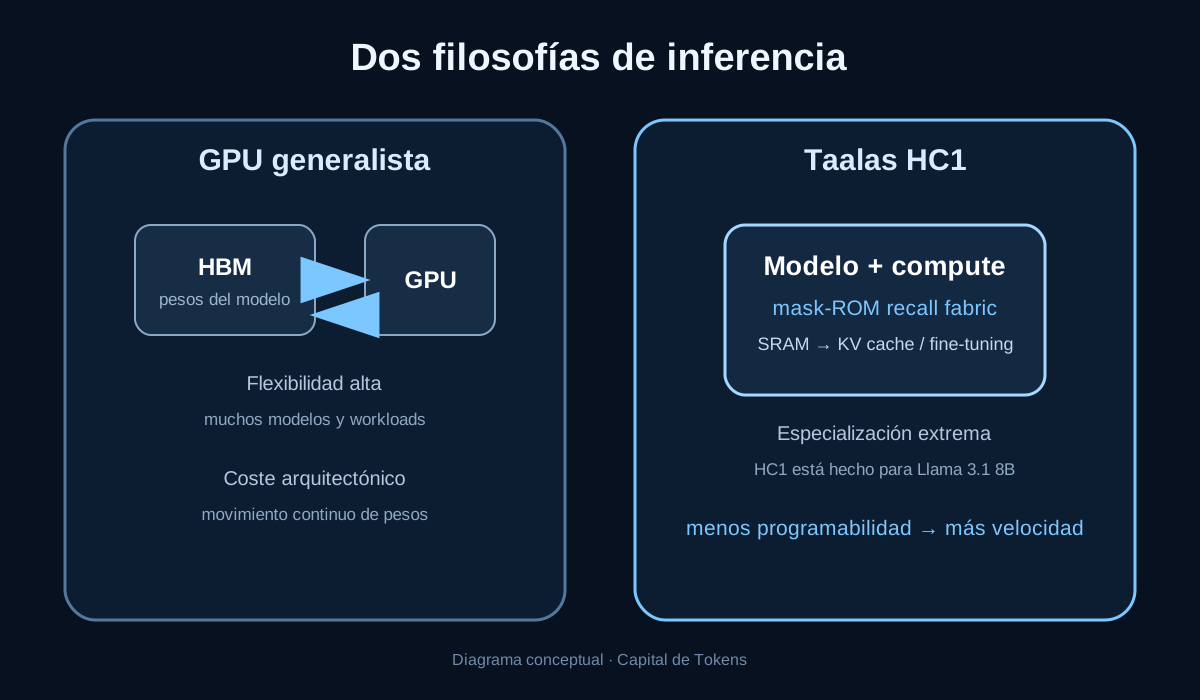
Conceptualmente, una arquitectura convencional se parece a esto:
HBM / memoria
      │
      │ pesos
      ▼
     GPU
      │
      ▼
operaciones
      │
      ▼
    token
Los aceleradores modernos invierten cantidades enormes de ingeniería en resolver ese problema: HBM de alto ancho de banda, interconexiones rápidas, cachés, batching, kernels optimizados y técnicas para aprovechar al máximo el hardware.
Taalas toma otro camino.
En lugar de preguntar:
¿cómo movemos los pesos todavía más rápido hacia un procesador programable?
la pregunta se convierte en:
¿y si los pesos y el dataflow del modelo forman parte del propio diseño del chip?
Mask-ROM + SRAM: el corazón de HC1
EE Times describe HC1 como una arquitectura que utiliza un mask-ROM-based recall fabric acompañado por SRAM programable.
La parte ROM permite incorporar los pesos principales del modelo en el chip.
La SRAM conserva espacio para información que sí necesita ser dinámica, como:
- KV cache;
- pesos de fine-tuning;
- adaptaciones del modelo.
La consecuencia arquitectónica es importante.
Una GPU intenta ser una máquina extremadamente poderosa y programable capaz de ejecutar muchos modelos y workloads diferentes.
HC1 renuncia deliberadamente a buena parte de esa generalidad.
Su objetivo no es ser una GPU mejor.
Su objetivo es ser una máquina extraordinariamente buena ejecutando el modelo para el que fue especializada.
El gran trade-off: programabilidad frente a velocidad
Aquí está la parte que evita convertir a Chat Jimmy en una historia simplista de “nuevo chip destruye a las GPUs”.
HC1 tiene una limitación enorme:
ese chip está hecho para Llama 3.1 8B.
No puedes tratarlo como una GPU y decidir mañana que quieres cargar cualquier modelo arbitrario de otra familia.
La comparación conceptual es:
GPU

muchos modelos
muchos workloads
alta programabilidad
        │
        ▼
mayor coste de generalidad
frente a:
HC1

modelo específico
flujo específico
muy poca generalidad
        │
        ▼
optimización extrema
Eso recuerda a una constante de la historia de la computación: la especialización puede producir mejoras enormes cuando estamos dispuestos a restringir el problema.
La diferencia es que Taalas intenta hacer que esa especialización no requiera los ciclos de desarrollo tradicionalmente asociados a un ASIC completamente nuevo para cada workload.
¿Cómo puede cambiar de modelo sin empezar de cero?
Según Taalas y la explicación técnica publicada por EE Times, la compañía toma ideas de los structured ASICs.
En lugar de rediseñar cada transistor desde cero, puede modificar una parte limitada de las máscaras —incluyendo interconexiones que determinan pesos y dataflow— para especializar el hardware.
EE Times señala que Taalas cambia dos máscaras para adaptar el chip.
Este punto es crítico para la viabilidad de la estrategia.
Un acelerador que tardara varios años en quedar listo correría el riesgo de nacer obsoleto en una industria donde los modelos cambian constantemente.
La apuesta de Taalas es reducir drásticamente ese ciclo y convertir el hardware especializado en algo que pueda seguir el ritmo del software con mucha más velocidad que un ASIC convencional.
17.000 tokens/s no significa automáticamente “mejor IA”
La velocidad de inferencia y la capacidad cognitiva son dimensiones diferentes.
Chat Jimmy ejecuta Llama 3.1 8B, un modelo pequeño comparado con los grandes sistemas frontier.
Por eso la comparación correcta no es:
Jimmy es mejor que los modelos frontier porque genera más tokens por segundo.
La comparación interesante es:
¿qué nuevas arquitecturas de software aparecen cuando generar tokens con un modelo pequeño deja de ser una operación lenta?
Ésa es una pregunta mucho más útil.
Imagina tareas como:
- clasificación;
- extracción estructurada;
- routing;
- normalización de texto;
- evaluación rápida;
- generación de variantes;
- parsing semántico;
- filtros de contenido;
- transformaciones repetitivas;
- pequeñas verificaciones dentro de un agente.
Muchas de esas operaciones no necesitan siempre el modelo más inteligente disponible.
Necesitan un modelo suficientemente capaz, barato y extremadamente rápido.
Por qué esto puede importar especialmente para agentes
Un chatbot tradicional suele tener un patrón sencillo:
usuario
   ↓
modelo
   ↓
respuesta
Un sistema agentic puede realizar muchas más inferencias para completar una sola tarea:
planificar
   ↓
seleccionar herramienta
   ↓
interpretar resultado
   ↓
clasificar
   ↓
verificar
   ↓
replanificar
   ↓
evaluar
   ↓
responder
La latencia de cada llamada empieza a multiplicarse.
Si un agente necesita hacer veinte pasos secuenciales y cada inferencia tarda un segundo, la experiencia puede convertirse rápidamente en algo frustrante.
Pero si una clase de worker puede devolver resultados en milisegundos, cambia el espacio de diseño.
Una arquitectura híbrida podría utilizar un modelo frontier para las decisiones difíciles y modelos pequeños ultrarrápidos para el trabajo repetitivo.
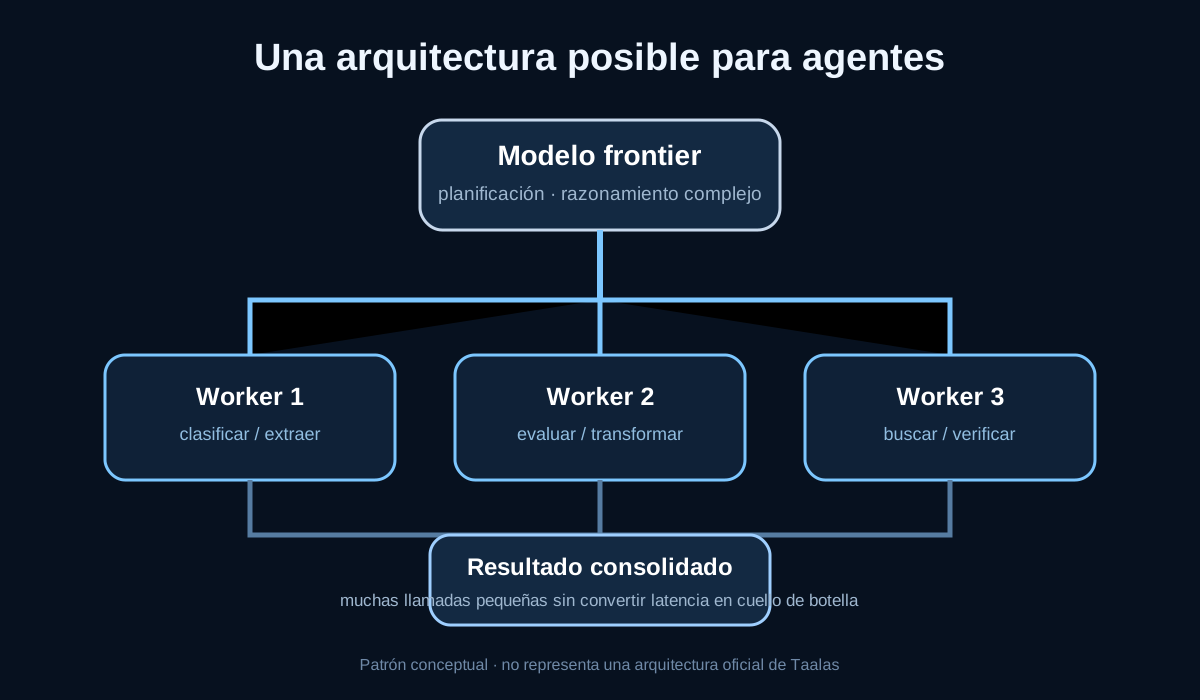
Conceptualmente:
             modelo frontier
                  │
               planner
                  │
        ┌─────────┼─────────┐
        ▼         ▼         ▼
     worker     worker     worker
   clasifica   evalúa     extrae
        │         │         │
        └─────────┼─────────┘
                  ▼
             resultado
Este diagrama no representa una arquitectura oficial de Taalas. Es una consecuencia de ingeniería que vale la pena explorar si la inferencia especializada alcanza latencias extremadamente bajas.
En sistemas de agentes, el rendimiento no depende solamente de cuántos tokens genera el modelo principal.
También importa cuánto cuesta cada pequeño paso de coordinación.
Una API sorprendentemente familiar
Taalas no limita la demostración a la página de Chat Jimmy.
Tiene una API pública documentada para HC1 y ofrece endpoints compatibles con el formato de OpenAI:
POST /v1/chat/completions
POST /v1/completions
GET  /v1/models
La API soporta además streaming mediante Server-Sent Events.
Eso significa que, desde el punto de vista de integración, probar HC1 puede parecerse mucho a cambiar el base_url de un cliente que ya entiende el esquema de Chat Completions.
Un ejemplo conceptual sería:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_TAALAS_API_KEY",
    base_url="https://api.taalas.com/v1",
)

response = client.chat.completions.create(
    model="three_bit_numerics",
    messages=[
        {"role": "user", "content": "Explica qué es un circuit breaker."}
    ],
)
El nombre de modelo disponible debe consultarse en la API porque puede cambiar. La documentación actual muestra three_bit_numerics en sus ejemplos.
El punto arquitectónico es más importante que el snippet: Taalas intenta esconder una arquitectura de silicio radical detrás de una interfaz de software familiar.
Eso reduce considerablemente la fricción para experimentar.
Qué dice Taalas sobre privacidad
La política de privacidad de Taalas incluye una afirmación relevante para quienes prueban Chat Jimmy o su API.
La compañía declara que ella y sus proveedores no utilizan los prompts y outputs para crear, entrenar, fine-tunear o mejorar modelos de IA.
Al mismo tiempo, Taalas sí recopila datos técnicos y de uso del servicio para operar, medir y mejorar su plataforma.
La recomendación práctica sigue siendo la misma que con cualquier servicio cloud:
no introducir secretos, credenciales, código confidencial o información personal sensible salvo que la política y el contexto de seguridad sean compatibles con ese uso.
AMD vio suficiente valor como para moverse
La historia de Taalas adquirió una dimensión mucho mayor en agosto de 2026.
El 6 de agosto de 2026, AMD anunció que había alcanzado un acuerdo definitivo para adquirir Taalas.
La precisión importa: el anuncio indica que la operación está sujeta a condiciones de cierre y aprobaciones regulatorias. No es correcto describirla todavía como una integración completamente consumada.
AMD explica que planea incorporar la tecnología de Taalas a su roadmap de aceleradores y desarrollar soluciones a nivel de sistema junto con AMD Instinct GPUs.
Eso sugiere algo interesante.
El futuro de la inferencia probablemente no será una guerra donde solamente sobreviva una arquitectura.
Podría ser un sistema heterogéneo donde diferentes workloads terminan en diferentes tipos de compute:
workload frontier
      ↓
GPU / acelerador general

workload estable y repetitivo
      ↓
silicio altamente especializado

CPU / control
      ↓
orquestación y lógica del sistema
La adquisición propuesta encaja precisamente con esa visión: usar el tipo correcto de compute para cada problema.
El dato que realmente importa no es 17K
Es fácil quedarse con el número grande.
17.000 tokens/s es una demostración espectacular porque convierte el rendimiento en algo visible para cualquier usuario que abra el chatbot.
Pero la parte más importante de Chat Jimmy no es la cifra exacta.
Es la demostración de tres ideas:
- La memoria sigue siendo uno de los grandes cuellos de botella de la inferencia.
- La especialización extrema puede intercambiar programabilidad por mejoras radicales de rendimiento.
- Si el ciclo de fabricación puede acercarse al ritmo de evolución de los modelos, el hardware model-specific puede ocupar un espacio real junto a GPUs y otros aceleradores.
Ese tercer punto es el más difícil.
Un modelo de IA puede cambiar en meses.
Una arquitectura de silicio tradicional puede necesitar mucho más tiempo.
La tecnología de Taalas sólo será transformadora a gran escala si consigue mantener suficientemente corto el camino entre:
modelo elegido
      ↓
especialización
      ↓
tape-out
      ↓
fabricación
      ↓
tarjeta desplegable
Ahí está una de las preguntas que conviene seguir observando.
También hay riesgos en la especialización extrema
La misma característica que produce el rendimiento de HC1 produce sus riesgos.
Si el modelo cambia demasiado rápido, el silicio puede perder relevancia.
Si una arquitectura requiere nuevas operaciones que el chip no contempla, la falta de programabilidad puede convertirse en una limitación importante.
Si el mercado se fragmenta en cientos de modelos, elegir cuál merece convertirse en hardware especializado se vuelve una decisión económica difícil.
Y si los modelos pequeños mejoran mientras los frontier cambian constantemente, podría aparecer una división natural:
- modelos muy dinámicos → hardware generalista;
- modelos maduros y de alto volumen → hardware especializado.
Ésa probablemente sea una forma más útil de pensar en HC1 que imaginarlo como un reemplazo universal de las GPUs.
Una nueva capa de optimización para la IA
Durante años el desarrollo de aplicaciones de IA se ha concentrado principalmente en la capa del modelo y del software:
prompt
RAG
agents
fine-tuning
tools
orchestration
Chat Jimmy obliga a mirar una capa más abajo.
¿Qué ocurre cuando también podemos optimizar agresivamente la relación entre modelo y silicio?
La pila empieza a verse así:
Aplicación
   ↓
Agente / orquestador
   ↓
Modelo
   ↓
Runtime
   ↓
Arquitectura de inferencia
   ↓
Silicio
Cuanto más volumen tenga la inferencia, más importante se vuelve cada capa.
En ese contexto, Taalas no está intentando simplemente construir “otra GPU”.
Está cuestionando una premisa más básica:
¿por qué el modelo y la computadora tienen que seguir siendo dos cosas tan separadas?
Chat Jimmy es, por ahora, una demostración extremadamente especializada de esa idea.
Pero la velocidad con la que genera texto hace que el experimento sea difícil de ignorar.
Fuentes y lecturas recomendadas
- Chat Jimmy
- Taalas — HC1 Technology Demonstrator
- Taalas API — documentación y endpoints OpenAI-compatible
- Taalas — Privacy Policy
- EE Times — Taalas Specializes to Extremes for Extraordinary Token Speed
- AMD — acuerdo definitivo para adquirir Taalas, 6 de agosto de 2026
La cifra de ~17.000 tokens/s, las especificaciones de 6 nm, 815 mm², 53B transistores y servidor de 2,5 kW proceden de Taalas. La descripción independiente del mask-ROM recall fabric, SRAM, cuantización agresiva y prueba de más de 15.000 tokens/s procede de EE Times. El estado de la operación con AMD se basa en el anuncio corporativo oficial del 6 de agosto de 2026.