 Capital de Tokens
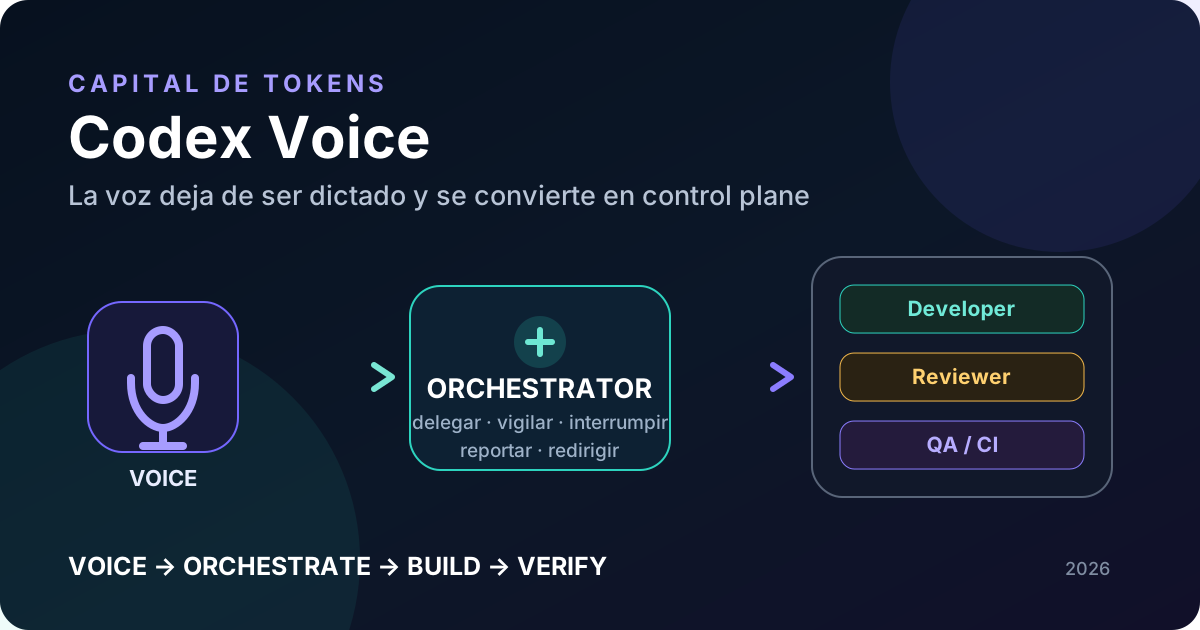
Cuando pensamos en usar voz para programar, la primera imagen suele ser bastante limitada:
hablo
  ↓
speech-to-text
  ↓
prompt
  ↓
agente escribe código
Eso ya es útil. Dictar una instrucción larga puede ser más rápido que escribirla y, al hablar, solemos añadir contexto, restricciones y ejemplos que quizá omitiríamos con el teclado.
Pero Voice en Codex apunta a otra cosa.
OpenAI presentó el 23 de julio de 2026 una experiencia de voz para Work y Codex en desktop diseñada no solo para conversar, sino para iniciar tareas, consultar progreso, hacer preguntas sobre agentes y coordinar múltiples agentes desde una sola conversación.
Ese detalle cambia por completo el modelo mental.
La voz deja de ser solamente una forma alternativa de introducir texto.
Empieza a convertirse en una interfaz de control para trabajo agentic.
Y las primeras semanas de uso público ya están mostrando cómo puede evolucionar ese patrón.
Lo que OpenAI lanzó realmente
Conviene separar dos experiencias que a veces se mezclan en la conversación pública.
Por un lado está el dictado: hablas, se transcribe tu voz y obtienes texto que puedes revisar antes de enviarlo.
Por otro está Live Voice: una conversación bidireccional en tiempo real donde el sistema puede escuchar, responder y, en Work o Codex, coordinar trabajo mientras los agentes siguen ejecutando tareas.
La documentación oficial describe capacidades como:
- iniciar tareas;
- consultar el progreso;
- preguntar por el estado de los agentes;
- coordinar múltiples agentes;
- interrumpir o redirigir trabajo desde la conversación.
Eso sugiere una arquitectura bastante diferente a la del “micrófono dentro del editor”.
voz
  ↓
orquestador
  ↓
┌────────────┬────────────┬────────────┐
│ developer  │ reviewer   │ QA / CI    │
└────────────┴────────────┴────────────┘
  ↓
estado + resultados
  ↓
voz
La conversación pasa a ser el plano de control.
Los workers ejecutan el trabajo.
Qué está haciendo realmente la comunidad
No existe todavía una estadística amplia que permita hablar de un consenso cuantitativo. Lo que sí aparece repetidamente en Reddit, GitHub y discusiones de usuarios son patrones de uso concretos.
1. Un manager por voz para varios agentes
Uno de los usos más interesantes apareció inmediatamente después del lanzamiento.
Usuarios descubrieron que una conversación de Voice podía servir para mirar proyectos activos, lanzar workers y enviar mensajes a otros threads de Codex.
En lugar de mantener una conversación independiente con cada agente, el usuario habla con un coordinador:
"Revisa mis proyectos activos."
"Manda un agente a arreglar ese CI."
"Abre otro worker para revisar el cambio."
"¿Cómo va el primero?"
"Cancela el segundo."
Ese patrón es importante porque desplaza la interfaz desde el agente ejecutor hacia un orquestador.
El humano ya no necesita saber exactamente qué thread contiene cada tarea.
Solo necesita expresar intención y recibir estado.
2. Conversar sobre arquitectura y delegar la implementación
Otro patrón natural consiste en usar la voz para la parte más ambigua del trabajo: diseño, requisitos, trade-offs y decisiones.
La conversación puede durar varios minutos.
Cuando la dirección queda clara, la implementación se delega a un worker.
humano + voz
      ↓
explorar problema
      ↓
acordar arquitectura
      ↓
crear task capsule
      ↓
worker implementa
Esto tiene sentido porque hablar es especialmente eficiente para transmitir contexto de alto nivel, mientras que el agente ejecutor puede trabajar con una instrucción estructurada y acotada.
3. Coding hands-free durante tareas largas
En Reddit hay usuarios describiendo sesiones de Voice de varias horas mientras Codex coordinaba trabajo real; uno de los ejemplos comentados fue una migración de cloud.
No debemos convertir una experiencia individual en evidencia universal, pero sí revela un workflow posible:
"Haz X."
      ↓
agente trabaja
      ↓
"¿Cómo vas?"
      ↓
status
      ↓
"No hagas eso; usa Y."
      ↓
redirección
La capacidad importante aquí no es transcribir voz.
Es poder intervenir mientras el trabajo está vivo.
4. Voz como interfaz de status
Este puede terminar siendo uno de los casos más valiosos.
Hoy, para saber cómo va un task, normalmente abrimos GitHub, un dashboard, un terminal o la conversación específica del agente.
Una capa de voz podría convertirlo en algo mucho más directo:
"¿Cómo va el PR?"

"Developer terminó. Reviewer encontró dos problemas.
El CI tiene 18 de 19 checks verdes."

"Dile al Developer que arregle el fallo."
La voz funciona entonces como una consola operacional en lenguaje natural.
No reemplaza GitHub Actions ni el sistema de observabilidad.
Los abstrae.
5. Meter más contexto con menos fricción
Muchos developers llevan tiempo usando dictado por una razón simple: hablar puede producir prompts más ricos.
Cuando escribimos, tendemos a resumir.
Cuando hablamos, explicamos.
Eso suele introducir de forma natural:
- antecedentes;
- ejemplos;
- restricciones;
- edge cases;
- prioridades;
- razones detrás de una decisión.
Por eso Dictation y Live Voice no deberían verse como competidores.
Son herramientas distintas.
Dictation funciona muy bien cuando queremos hablar, revisar y luego enviar.
Live Voice funciona mejor cuando queremos mantener una conversación continua con un sistema que además está coordinando trabajo.
Pero todavía se siente como una v1
La otra mitad de la historia aparece en GitHub Issues y en las discusiones de usuarios.
La idea entusiasma, pero la UX todavía tiene varias aristas.
Falta visibilidad mientras el agente trabaja
Una conversación de voz necesita responder una pregunta constantemente:
¿Qué está pasando ahora mismo?
Si el agente está ejecutando una tarea larga y no muestra milestones claros, el usuario puede quedar hablando con un sistema cuyo estado interno no entiende.
Una interfaz agentic de voz necesita algo equivalente a:
Developer empezó.
↓
Implementación terminada.
↓
Reviewer revisando.
↓
Reviewer encontró 2 problemas.
↓
Developer corrigiendo.
↓
CI ejecutándose.
↓
Todos los checks verdes.
Sin esos checkpoints, la conversación puede sentirse opaca.
El uso puede ser caro
También hay usuarios que reportan que Live Voice consume su presupuesto de uso de Codex más rápido de lo que esperaban.
Un post de Reddit describió aproximadamente un 12% de consumo después de unos 30 minutos de pruebas casuales.
Otro usuario explicó que, para reducir coste, estaba usando Voice principalmente como capa de orquestación y descargando la implementación en otros agentes.
Son experiencias anecdóticas y los límites comerciales pueden cambiar, pero el principio técnico es interesante:
el orquestador debería mantener poco contexto operacional; los workers deberían poseer el trabajo pesado.
Ese mismo principio aparece en workflows agentic que intentan reducir el coste de releer contextos enormes en cada turno.
Dictado largo y pérdida de audio
Aquí aparecen problemas más serios.
Hay varios issues en el repositorio de Codex relacionados con grabaciones o transcripciones que pueden perderse:
- un permission prompt puede interrumpir una grabación activa;
- una transcripción fallida puede desaparecer al cambiar de thread;
- mensajes dictados muy largos pueden quedarse sin draft, transcript ni audio recuperable;
- algunas versiones han introducido regresiones en hotkeys de dictado.
Para instrucciones de dos segundos, esto es molesto.
Para una explicación técnica de diez o treinta minutos, es un problema de confiabilidad.
Una herramienta voice-first debería tratar el audio como datos importantes: persistirlo temporalmente, permitir retry y nunca descartar silenciosamente una entrada larga.
Push-to-talk, shortcuts y ergonomía
La comunidad también ha pedido mejores controles:
- start recording;
- stop recording;
- cancel recording;
- send transcript;
- hotkeys globales;
- elección entre toggle-to-record y push-to-talk.
Parece un detalle pequeño, pero no lo es.
Una experiencia hands-free deja de ser hands-free si cada interacción exige encontrar el botón correcto con el mouse.
La arquitectura que empieza a emerger
Si juntamos las capacidades oficiales con los workflows comunitarios, aparece un patrón bastante claro.
El agente principal no necesita ser quien programe.
Puede ser quien:
- escucha;
- entiende intención;
- decide a quién delegar;
- mantiene un ledger de estado;
- vigila progreso;
- recibe resultados compactos;
- interrumpe cuando hace falta;
- reporta milestones al humano.
Los workers, en cambio, poseen el contexto operacional.
                    HUMANO
                      │
                   Voice
                      │
                      ▼
             ┌────────────────┐
             │  Orchestrator  │
             └───────┬────────┘
                     │
       ┌─────────────┼─────────────┐
       ▼             ▼             ▼
   Developer      Reviewer        QA
       │             │             │
       └─────────────┼─────────────┘
                     ▼
              State / Ledger
                     │
                     ▼
            GitHub / CI / Hosts
Esto tiene varias ventajas.
El contexto principal crece más lentamente
El orquestador no necesita leer todos los logs, diffs y outputs de cada worker.
Solo recibe cambios materialmente importantes.
Los handoffs se vuelven explícitos
Developer termina.
Reviewer recibe un paquete definido.
QA valida.
El orquestador conoce el estado de cada transición.
La voz puede ser realmente operacional
Entonces comandos como estos dejan de ser demos:
"¿Qué agentes están trabajando?"
"¿Cómo va el issue 17?"
"Cancela ese workflow."
"Pon la tarea en pausa."
"Mándalo a review."
"Corrige lo que encontró el reviewer."
"Cuando esté verde, haz merge."
La interfaz deja de ser “hablarle al modelo”.
Se convierte en operar un sistema de agentes.
Qué debería tener una experiencia voice-first de verdad
A partir de estos casos, hay cinco propiedades que parecen fundamentales.
1. Estado persistente
La conversación no puede ser la única fuente de verdad.
Debe existir un ledger independiente con tareas, agentes, checkpoints, resultados y relaciones.
2. Milestones hablados
El sistema debe reportar transiciones importantes sin obligar al usuario a mirar una pantalla.
3. Interrupción de primera clase
“Stop”, “cancel”, “pause” y “redirect” deben ser operaciones reales sobre el task, no simples mensajes añadidos al final de una cola.
4. Handoffs pequeños
El orquestador debería transferir instrucciones y conocimiento relevante, no conversaciones enteras de cientos de miles de tokens.
5. Recuperación de voz
Si falla ASR o aparece un prompt de permisos, el audio no debería perderse.
Una interfaz que acepta minutos de pensamiento humano tiene que tratar ese input con la misma seriedad que un archivo sin guardar.
Entonces, ¿la voz reemplaza al teclado?
Probablemente no.
Para código, JSON, nombres exactos, paths, expresiones regulares, comandos peligrosos o cambios que queremos inspeccionar palabra por palabra, el texto sigue teniendo ventajas enormes.
La oportunidad de Voice parece estar en otra capa:
texto  → precisión
voz    → intención + coordinación + interrupción
La combinación puede ser más poderosa que cualquiera de las dos por separado.
La idea importante
Codex Voice todavía tiene problemas de ergonomía, consumo, visibilidad y confiabilidad del dictado.
Pero sería un error evaluarlo solamente preguntando:
“¿Es más rápido hablar que escribir un prompt?”
La pregunta más interesante es:
¿Puede la voz convertirse en el control plane de una flota de agentes de software?
Los primeros workflows de la comunidad sugieren que sí.
Y si esa dirección continúa, el futuro del coding por voz probablemente no será un developer diciendo cada línea de código en voz alta.
Será algo más parecido a un supervisor de ingeniería:
hablar
  ↓
delegar
  ↓
observar
  ↓
interrumpir
  ↓
validar
  ↓
entregar
La voz no reemplazaría al coding agent.
Se convertiría en la interfaz desde la que coordinamos muchos de ellos.
Fuentes
- OpenAI Developer Community — ChatGPT Voice is now in the desktop app
- OpenAI Help Center — ChatGPT Business release notes: Voice in Work and Codex
- Reddit r/codex — Does Codex voice mode work with existing projects?
- Reddit r/codex — Voice mode usage
- Reddit r/codex — MacOS Desktop app forces Voice live mode to eat up weekly Usage
- Reddit r/codex — What should I expect out of voice mode usage on the $100 plan?
- Reddit r/codex — How I effectively got 3× more Codex usage by changing the orchestration workflow
- GitHub openai/codex — Permission prompt interrupts active voice dictation and discards audio #21445
- GitHub openai/codex — Codex Desktop loses pending dictation after ASR failure and window/thread switch #28765
- GitHub openai/codex — Voice input can silently lose long dictated message #18223
- GitHub openai/codex — Dictation keyboard shortcut now requires being held instead of toggling recording #30208