 Capital de Tokens
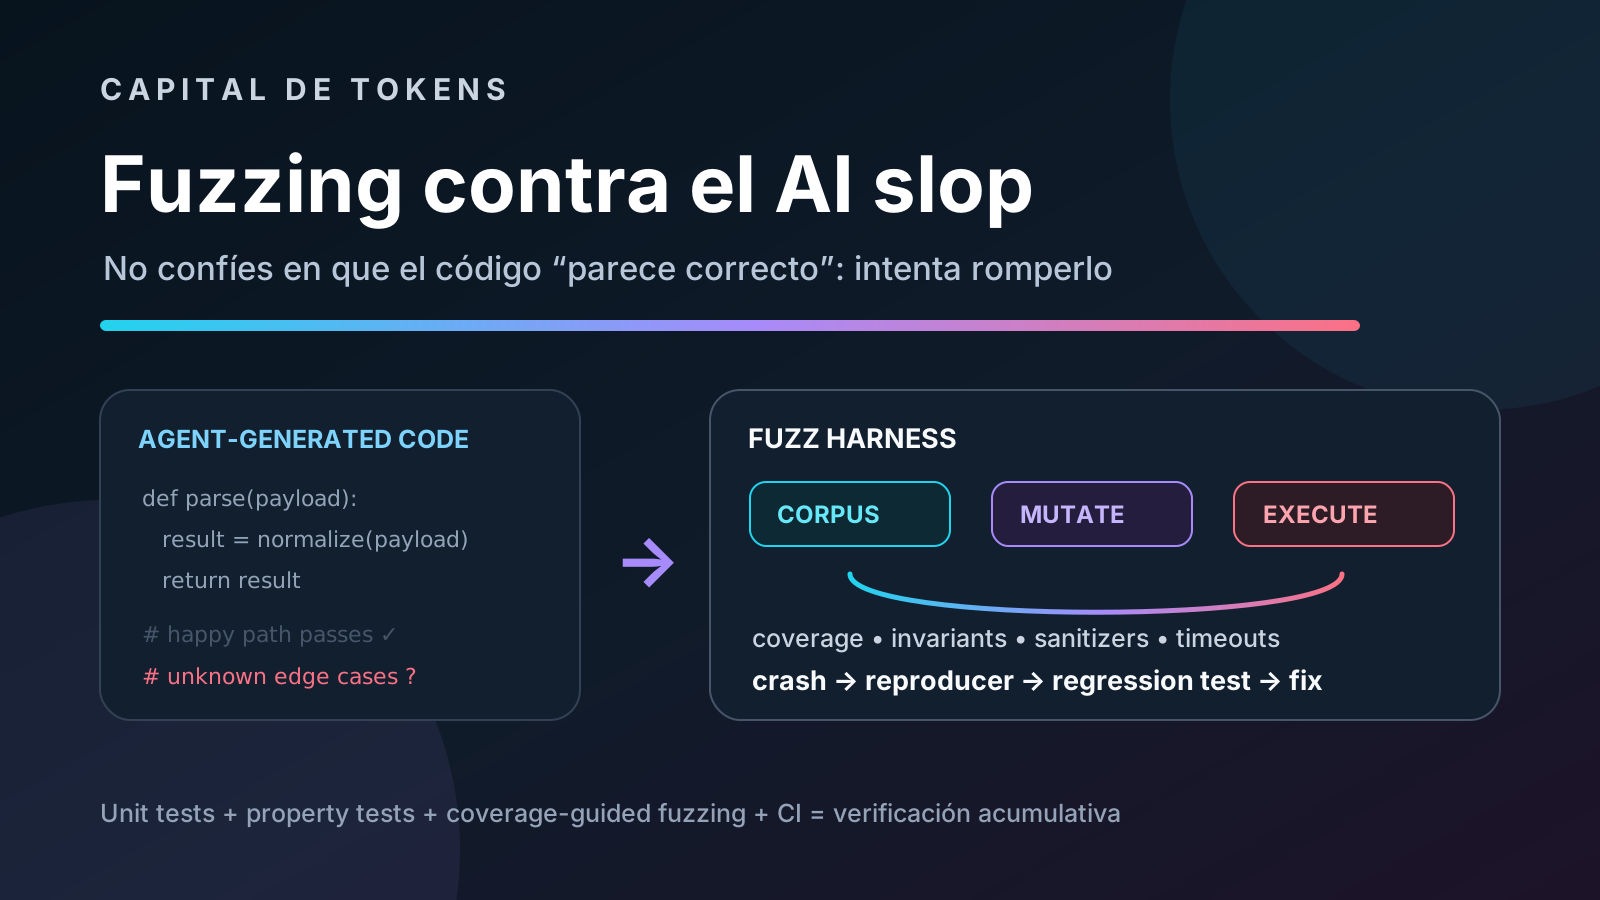
Una de las respuestas más interesantes al debate sobre el AI slop no consiste en pedirle al modelo que “escriba mejor código”. Consiste en cambiar la forma en que decidimos si ese código merece llegar a producción.
En septiembre de 2026, Business Insider publicó un intercambio entre un desarrollador preocupado por el deterioro de la calidad y Boris Cherny, creador de Claude Code. Cherny hizo una distinción razonable: el código desechable y de bajo impacto puede tratarse casi como una caja negra; el código de producción, en cambio, debería superar un listón incluso más alto que el código escrito manualmente.
Lo más interesante fue la lista de mecanismos que dijo que Anthropic usa alrededor del código: muchas reglas de lint, muchos tests, E2E dirigidos por Claude, revisiones automáticas, revisiones de seguridad, refactoring automatizado y fuzzers impulsados por Claude ejecutándose diariamente.
Ese último punto merece atención porque el fuzzing encaja especialmente bien con la programación agentic. Un agente puede producir código a una velocidad que hace imposible revisar manualmente cada combinación de estados, inputs y rutas. La respuesta no puede ser simplemente “leer más rápido”. Necesitamos sistemas que intenten romper el software por nosotros.
Este artículo explica qué es realmente el fuzzing, cómo funciona por debajo, en qué se diferencia de los property tests y cómo convertirlo en una pieza del harness que rodea a un coding agent.
El problema no es que la IA escriba muchas líneas
El problema aparece cuando confundimos volumen generado con evidencia de corrección.
Un agente puede entregar una implementación que:
- compila;
- pasa los cinco ejemplos que le dimos;
- parece razonable en review;
- respeta el estilo del repositorio;
- y aun así falla con una combinación de entrada que nadie imaginó.
Los humanos tenemos exactamente el mismo problema. La diferencia es de escala: un agente puede modificar varios módulos, añadir parsers, introducir nuevos estados y tocar contratos en minutos.
Cuanto mayor es la velocidad de generación, más importante se vuelve la pregunta:
¿Qué mecanismo independiente intenta falsar el comportamiento que el agente acaba de implementar?
Ahí entra el fuzzing.
Fuzzing no significa simplemente “meter datos aleatorios”
La versión intuitiva del fuzzing es sencilla:
programa
  +
inputs raros
  ↓
¿crash?
¿hang?
¿overflow?
¿excepción inesperada?
¿consumo absurdo de memoria?
Pero los fuzzers modernos son bastante más sofisticados.
Un fuzzer coverage-guided como libFuzzer mantiene un corpus de inputs interesantes. Toma uno, lo muta, ejecuta el programa y observa qué rutas del código fueron alcanzadas. Si la mutación abre una ruta nueva, el nuevo input se conserva en el corpus y se usa como materia prima para mutaciones futuras.
El loop conceptual es:
seed corpus
    ↓
seleccionar input
    ↓
mutarlo
    ↓
ejecutar target
    ↓
medir cobertura / señales
    ↓
¿descubrió una ruta nueva?
   sí → guardar input
   no → descartarlo
    ↓
repetir miles o millones de veces
El fuzzing deja de ser una lotería puramente aleatoria. Se convierte en una búsqueda dirigida por feedback.
Ese detalle es importante. Un parser puede rechazar el 99,999 % de los bytes aleatorios antes de alcanzar la lógica interesante. Un fuzzer guiado por cobertura aprende qué mutaciones lo acercan a ramas nuevas y conserva las que progresan.
¿Qué está buscando exactamente?
El oráculo más simple es: el proceso no debería romperse.
Un fuzzer puede marcar como fallo:
- una excepción no esperada;
- un segmentation fault;
- un assert;
- un timeout;
- un consumo de memoria excesivo;
- comportamiento indefinido detectado por un sanitizer;
- una lectura o escritura inválida de memoria.
En C o C++, por eso es frecuente combinar libFuzzer con AddressSanitizer o UndefinedBehaviorSanitizer. La propia documentación de LLVM recomienda esa combinación para ampliar el tipo de fallos detectables.
Pero un fuzzer también puede comprobar invariantes semánticas. Por ejemplo:
parse(serialize(x)) == xdecode(encode(x)) == xbalance_final >= 0un job terminal nunca vuelve a pendingEn ese punto fuzzing y property-based testing empiezan a tocarse.
Unit tests, property tests, fuzzing y mutation testing no son lo mismo
Conviene separarlos porque atacan fallos diferentes.
| Técnica | Qué varía | Qué intenta comprobar |
|---|---|---|
| Unit test | ejemplos escritos por nosotros | comportamientos concretos conocidos |
| Property-based testing | inputs generados dentro de un dominio | invariantes que deben cumplirse para muchos casos |
| Fuzzing | inputs mutados/generados, normalmente guiados por cobertura | crashes, hangs, memory bugs, rutas inesperadas y propiedades rotas |
| Mutation testing | el propio código de producción | si nuestros tests detectan cambios incorrectos deliberados |
| Lint / static analysis | no ejecuta inputs | errores, patrones peligrosos y contratos estáticos |
La diferencia entre property testing y fuzzing es especialmente borrosa.
Hypothesis genera casos a partir de estrategias, recuerda fallos anteriores, intenta encontrar casos límite y reduce —shrink— un fallo grande hasta obtener un ejemplo mínimo. Su documentación incluso incluye fases de mutación orientada a objetivos y recomienda técnicas de coverage-guided fuzzing cuando se ejecutan cantidades muy grandes de casos.
Un fuzzer clásico como libFuzzer parte más directamente de cobertura, corpus y mutaciones de bytes o estructuras. Ambos enfoques pueden converger sobre la misma idea: explorar automáticamente un espacio de estados demasiado grande para enumerarlo a mano.
Un ejemplo con property-based testing
Imaginemos un servicio que recibe URLs y normaliza un identificador.
Un unit test típico sería:
def test_extract_id():
    assert extract_id("https://example.com/watch?v=abc123") == "abc123"
Eso demuestra una cosa: ese ejemplo funciona.
Con Hypothesis podemos expresar una propiedad:
from hypothesis import given, strategies as st

@given(st.text(min_size=1, max_size=64))
def test_roundtrip_video_id(video_id):
    url = f"https://example.com/watch?v={video_id}"
    assert extract_id(url) == video_id
Ahora la herramienta puede explorar Unicode, cadenas de longitud extraña, caracteres reservados y combinaciones que nunca habríamos escrito manualmente.
Una propiedad todavía mejor podría ser:
@given(st.text())
def test_parser_never_crashes(raw):
    try:
        extract_id(raw)
    except InvalidUrl:
        pass
Esto no garantiza que el parser sea correcto. Pero sí establece un contrato útil: cualquier input arbitrario debe producir un resultado válido o una excepción controlada, nunca una explosión inesperada.
Hypothesis guarda casos fallidos y puede volver a ejecutarlos en runs futuros. Cuando encuentra un fallo generado, intenta minimizarlo para que el desarrollador termine con algo manejable, no con un blob monstruoso imposible de razonar.
El mismo problema con un fuzzer coverage-guided en Python
Para Python existe Atheris, un fuzzer coverage-guided de Google basado en libFuzzer.
Un target mínimo tiene una forma parecida a esta:
import atheris
import sys

with atheris.instrument_imports():
    from app.parser import parse_payload


def TestOneInput(data: bytes):
    parse_payload(data)


atheris.Setup(sys.argv, TestOneInput)
atheris.Fuzz()
Atheris instrumenta el bytecode de Python para observar cobertura. Si una mutación alcanza código que antes no se había ejecutado, esa entrada puede incorporarse al corpus.
Para un parser JSON podríamos ser más explícitos:
import json


def TestOneInput(data: bytes):
    try:
        obj = json.loads(data)
    except (UnicodeDecodeError, json.JSONDecodeError):
        return

    result = normalize_request(obj)

    assert result.status in {"accepted", "rejected"}
Ahora no solo buscamos crashes. También codificamos una propiedad del dominio.
La técnica se vuelve especialmente poderosa cuando el código tiene una entrada compacta y una gran cantidad de ramas internas: parsers, formatos binarios, protocolos, serializadores, validadores, compiladores, regex engines, endpoints y librerías de transformación.
El corpus es memoria operativa
Una pieza que suele ignorarse es el corpus.
Un buen fuzzer no empieza necesariamente desde cero. Puede recibir inputs válidos e inválidos que representen casos reales:
corpus/
  valid-small.json
  empty.json
  malformed-header.bin
  unicode-edge-case.txt
  previous-crash-001
Cuando el fuzzer descubre una entrada que abre cobertura nueva, la conserva. Cuando descubre un crash, guarda el input que lo reproduce.
Eso convierte el fuzzing en una forma de memoria del sistema:
bug descubierto
    ↓
input reproducer
    ↓
corpus / regression test
    ↓
no volver a introducir el mismo bug
Éste es uno de los patrones más útiles para agentes autónomos. El agente puede arreglar el bug, pero el reproducer debe sobrevivir al agente.
El hallazgo útil no es “el agente dijo que ya está arreglado”
Supongamos que un nightly fuzzer encuentra este input:
b"\x00{\xff\xff"que provoca una excepción inesperada.
El flujo maduro no debería ser:
fuzzer encuentra crash
→ agente modifica código
→ agente dice "fixed"
→ merge
Debería ser:
fuzzer encuentra crash
→ guardar reproducer
→ crear test de regresión
→ agente propone fix
→ ejecutar reproducer
→ ejecutar unit/property tests
→ fuzzing corto de confirmación
→ review / CI
→ merge
El agente puede participar en casi todas las etapas. Lo que no debe hacer es convertirse en el único oráculo de su propio trabajo.
Por qué el fuzzing es especialmente bueno contra AI slop
El AI slop suele tener una característica peligrosa: plausibilidad local.
Una función puede verse bien. Los nombres son correctos. El estilo encaja. El happy path pasa. El diff parece profesional.
Lo que falta muchas veces son las interacciones que nadie pidió explícitamente:
input vacío
+ Unicode raro
+ retry
+ estado parcialmente persistido
+ timeout
+ duplicado
+ carrera
+ payload gigantesco
+ parser permisivo
+ excepción de dependencia
Un LLM es muy bueno produciendo un camino coherente a partir de una especificación. Un fuzzer es bueno atacando los huecos donde la especificación no fue suficientemente precisa.
Son herramientas complementarias.
Coverage-guided no significa “correctness-guided”
Hay que evitar otra trampa: mucha cobertura no equivale a corrección.
Un fuzzer puede ejecutar el 95 % de un módulo y no detectar que una comisión se calcula mal, que un timestamp se redondea incorrectamente o que dos estados válidos se intercambian.
La cobertura responde a:
¿qué partes ejecuté?
No a:
¿el resultado era el correcto?
Por eso los fuzz targets más potentes combinan exploración con invariantes, implementaciones de referencia, checks diferenciales o metamorphic testing.
Ejemplos:
implementación_nueva(x) == implementación_referencia(x)sort(sort(x)) == sort(x)decode(encode(x)) == xresultado(x) == resultado(transformación_equivalente(x))Cuanto mejor sea el oráculo, más clases de bugs puede descubrir el fuzzer.
Fuzzing diferencial: hacer competir dos implementaciones
Un patrón especialmente práctico durante refactors generados por IA es mantener temporalmente la implementación vieja como referencia.
def TestOneInput(data):
    old = old_parser(data)
    new = new_parser(data)
    assert normalize(old) == normalize(new)
El agente puede haber escrito un parser mucho más elegante. El fuzzing diferencial intenta encontrar inputs donde ambos divergen.
No demuestra que la versión vieja sea perfecta, pero reduce muchísimo el riesgo de que un refactor “limpio” elimine casos históricos que estaban implícitamente soportados.
Es una forma mecánica de preguntar:
¿El agente cambió la implementación o también cambió accidentalmente el contrato?
Structure-aware fuzzing
Mutar bytes funciona muy bien cuando los inputs son simples. Pero para JSON complejo, SQL, ASTs, protobufs o protocolos estructurados, la mayoría de las mutaciones pueden morir demasiado pronto.
Atheris y libFuzzer permiten mutadores personalizados; otras herramientas permiten grammars o generadores estructurados.
En vez de producir bytes arbitrarios:
\xff\x00{{{podemos producir objetos válidos con rarezas internas:
{
  "items": [],
  "retry": -1,
  "timeout_ms": 2147483648,
  "metadata": {"x": "\u0000"}
}
Eso empuja la exploración hacia la lógica de negocio y no solo hacia el parser superficial.
Sanitizers: ampliar lo que significa “fallar”
En lenguajes con memoria no administrada, un crash visible es solo una fracción de los problemas posibles.
Por eso los fuzzers suelen combinarse con:
ASan  → accesos inválidos de memoria
UBSan → comportamiento indefinido
MSan  → uso de memoria no inicializada
La idea es ampliar el oráculo. Algo que habría parecido una ejecución “normal” puede transformarse en un fallo detectable cuando el runtime está instrumentado.
Para C/C++ generado o modificado por agentes, esta combinación debería ser casi automática en fuzz targets críticos.
Un pipeline razonable para código generado por agentes
No hace falta ejecutar fuzzing durante horas en cada commit.
Un patrón práctico es distribuir el presupuesto por capas.
En cada PR
Ejecutar rápido:
lint
static analysis
unit tests
property tests
fuzzing focalizado de 30–120 s en targets afectados
El objetivo es encontrar regresiones obvias sin destruir el tiempo de feedback.
Después del merge o cada noche
Ejecutar más profundo:
10–60 min por target crítico
más corpus histórico
sanitizers
más workers
inputs más grandes
fuzzing diferencial
De forma continua
Para proyectos apropiados, servicios como OSS-Fuzz muestran el modelo a gran escala: fuzzing distribuido y continuo, con soporte para libFuzzer, AFL++, Honggfuzz y Centipede, además de integración con sanitizers.
OSS-Fuzz también ofrece un flujo de CI donde un pull request puede ejecutar fuzzers durante un presupuesto corto; si aparece un crash reproducible, el job falla y conserva el input responsable.
La arquitectura interesante es:
PR
 ↓
checks rápidos
 ↓
merge
 ↓
nightly fuzzing
 ↓
crash artifact
 ↓
issue / regression test
 ↓
agente propone fix
 ↓
CI vuelve a intentar falsarlo
Dejar que el agente escriba fuzzers: sí, pero con una condición
Cherny mencionó fuzzers “Claude-powered”. Eso abre una idea poderosa: usar al propio agente para crear targets, estrategias y propiedades.
Un coding agent puede inspeccionar una API y proponer:
- qué entradas mutar;
- qué invariantes deberían sostenerse;
- qué parsers son buenos targets;
- qué límites numéricos explorar;
- qué excepciones deberían considerarse válidas;
- qué corpus inicial sintetizar.
Pero hay una regla fundamental:
El agente no debería definir unilateralmente tanto la implementación como el criterio que declara correcta esa implementación.
Si escribe la función y además inventa un test que simplemente reproduce sus propias suposiciones, no hemos ganado independencia.
Las mejores propiedades vienen de contratos externos:
especificación
protocolo
modelo de dominio
invariantes de negocio
implementación de referencia
compatibilidad histórica
constraints de base de datos
El agente puede codificarlas. El significado debe venir de una fuente más estable que el mismo diff que estamos intentando validar.
Fuzzing + property tests + mutation testing: una combinación muy fuerte
Estas técnicas se refuerzan entre sí.
Un flujo posible:
1. property tests expresan invariantes
2. fuzzing busca inputs que las rompan
3. shrinking/minimización produce un caso pequeño
4. el caso se guarda como regresión
5. mutation testing modifica el código deliberadamente
6. verificamos que la suite sea capaz de detectar esos cambios
Fuzzing pregunta:
¿Puedo encontrar una entrada que rompa el programa?
Mutation testing pregunta:
Si el programa estuviera roto, ¿mis tests se darían cuenta?
Juntas atacan dos lados del mismo problema.
El harness importa más a medida que el modelo mejora
Es tentador pensar que un modelo mejor reduce la necesidad de tests agresivos.
En realidad puede ocurrir lo contrario.
Un modelo más capaz:
- toca más archivos;
- realiza refactors mayores;
- trabaja durante más tiempo sin supervisión;
- resuelve issues completos;
- genera código que parece más convincente;
- aumenta el coste de revisar manualmente cada decisión.
El harness se convierte entonces en la frontera de confianza.
coding agent
    ↓
implementación
    ↓
formatter / lint
    ↓
static analysis
    ↓
unit + integration
    ↓
property tests
    ↓
fuzzing
    ↓
security checks
    ↓
review
    ↓
producción + observabilidad
No todas las capas aplican a todos los cambios. La idea es que la confianza provenga de evidencia acumulada, no de que el agente haya sonado seguro.
La lección más útil del debate sobre AI slop
El dilema no es “leer cada línea” frente a “vibe coding sin controles”.
Existe una tercera opción mucho más interesante:
delegar más generación y, al mismo tiempo, aumentar la calidad de los verificadores.
Eso cambia el papel del ingeniero. Parte del trabajo deja de ser producir manualmente cada implementación y pasa a diseñar el sistema que decide cuándo una implementación merece confianza.
El fuzzing encaja perfectamente en esa transición porque no intenta adivinar si el código “parece bueno”. Lo ejecuta una y otra vez bajo condiciones que el autor —humano o agente— probablemente no imaginó.
El objetivo no es demostrar que el código generado por IA es correcto.
El objetivo es darle miles o millones de oportunidades para demostrar que está equivocado antes de que producción lo haga por nosotros.
Fuentes y lecturas recomendadas
- Business Insider — A developer emailed Claude Code’s creator about AI slop. Boris Cherny wrote back
- LLVM — libFuzzer: a library for coverage-guided fuzz testing
- Hypothesis — documentación oficial
- Hypothesis — cuándo usar property-based testing
- Google Atheris — coverage-guided fuzzing para Python
- Google OSS-Fuzz
- OSS-Fuzz — Continuous Integration / CIFuzz
- La IA está cambiando qué significa entender un codebase