 Capital de Tokens
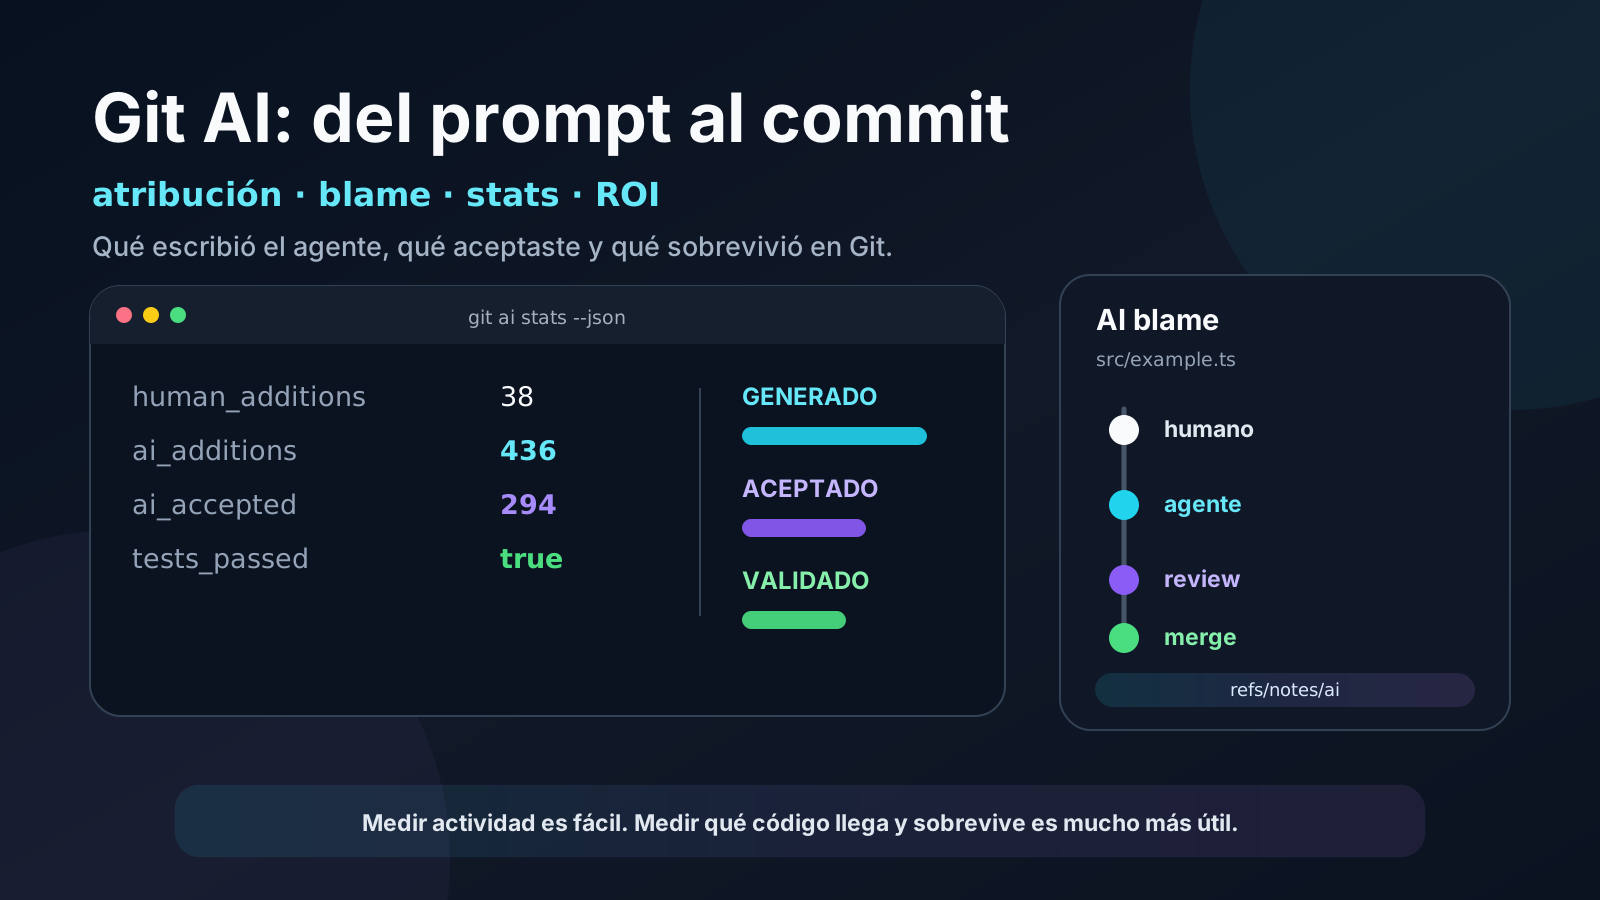
Los agentes de programación pueden escribir cientos o miles de líneas en una sesión. El problema empieza después: ¿qué parte de ese código terminó realmente en el commit?, ¿qué líneas sobrevivieron a la revisión?, ¿qué modelo las produjo?, ¿cuánto tuvo que reescribir una persona?
Contar prompts, sesiones o tokens sirve para medir actividad. No necesariamente mide valor.
Ahí entra Git AI: una extensión open source de Git que registra atribución a nivel de línea para código generado por agentes. En lugar de intentar adivinar si una línea “parece escrita por IA”, el propio agente marca los cambios que hizo y Git AI guarda esa procedencia junto al historial del repositorio.
El proyecto cobró todavía más relevancia en septiembre de 2026 cuando Git AI anunció que se une al equipo de Codex de OpenAI. El equipo dijo que seguirá invirtiendo en el proyecto abierto y en estándares que permitan comparar agentes y medir el retorno del software generado con IA.
Este artículo explica cómo usarlo de forma práctica, especialmente con Codex, sin convertir la medición en otra fuente de ruido.
Los nombres de máquinas, usuarios, repositorios, ramas internas, IDs, URLs privadas, credenciales y cifras operativas de los ejemplos fueron eliminados o sustituidos deliberadamente. Los comandos usan nombres genéricos.
Qué problema resuelve Git AI
Un repositorio tradicional sabe qué commit introdujo una línea y qué identidad Git creó ese commit:
git blame src/auth.tsPero eso se vuelve insuficiente cuando una persona dirige varios agentes y luego hace el commit con su propia identidad. Git ve un único autor humano aunque el contenido haya sido producido por varias sesiones, herramientas o modelos.
Git AI añade una capa adicional:
prompt
  ↓
agente
  ↓
edición del archivo
  ↓
checkpoint de atribución
  ↓
commit
  ↓
Git Note con qué líneas fueron AI-authored
Según su documentación, los agentes soportados ejecutan checkpoints cuando escriben o modifican archivos. Al crear el commit, Git AI consolida esos checkpoints y adjunta un registro de autoría bajo:
refs/notes/aiEso es importante porque no modifica el SHA ni el mensaje del commit. La metadata viaja como una Git Note asociada al objeto.
La atribución puede sobrevivir operaciones comunes como:
rebase
cherry-pick
stash / pop
merge
merge --squash
commit --amend
reset
pull --rebase
Git AI describe este proceso como eventualmente consistente: después de una reescritura de historial puede tardar unos milisegundos en reconstruir la nota correspondiente.
Instalar Git AI
En macOS, Linux o Windows mediante WSL:
curl -sSL https://usegitai.com/install.sh | bashEn Windows nativo existe un instalador PowerShell:
powershell -NoProfile -ExecutionPolicy Bypass -Command "irm https://usegitai.com/install.ps1 | iex"La instalación es global para el usuario. No hace falta inicializar Git AI en cada repositorio.
Después conviene reiniciar las sesiones del agente o el IDE que ya estaban abiertos para que recojan los hooks instalados.
Si acabas de instalar un agente nuevo o quieres forzar la configuración de las integraciones:
git ai install-hooksGit AI mantiene esas integraciones y las revisa periódicamente.
Usarlo con Codex
La integración de Codex está soportada explícitamente por Git AI. El flujo normal no cambia:
cd ~/example-repo

codex exec "añade validación al endpoint y actualiza los tests"

git status
git diff
git add .
git commit -m "feat: validate request input"
No necesitas pedirle a Codex que “marque” cada línea manualmente. La integración usa los hooks del agente para relacionar las modificaciones con la sesión que las produjo.
Si Git AI se instaló mientras Codex ya estaba ejecutándose, cierra esa sesión y abre otra antes de hacer la prueba.
La primera comprobación: git ai stats
Después de un commit:
git ai statsPara automatización, la versión interesante es JSON:
git ai stats --jsonTambién puedes limitar el cálculo a un rango:
git ai stats main..HEAD --jsonUna salida simplificada puede tener esta forma:
{
  "human_additions": 24,
  "unknown_additions": 3,
  "ai_additions": 81,
  "ai_accepted": 56,
  "git_diff_added_lines": 108,
  "tool_model_breakdown": {
    "codex::example-model": {
      "ai_additions": 81,
      "ai_accepted": 56
    }
  }
}
Los valores exactos y el identificador del modelo dependen de la integración y la versión instalada.
La documentación de Git AI define tres clases para las líneas añadidas:
human_additions
unknown_additions
ai_additions
y mantiene la invariante:
human + unknown + AI = líneas añadidas por GitEso permite distinguir entre “la IA generó mucho” y “mucho código generado terminó realmente en el commit”.
ai_accepted no significa “código correcto”
Esta distinción es fundamental.
Si el agente produjo 100 líneas y 70 llegaron al commit, puedes hablar de una tasa de aceptación aproximada del 70 %. Pero eso no demuestra que esas 70 líneas sean buenas.
Todavía pueden:
- fallar tests;
- introducir una regresión;
- ser innecesariamente complejas;
- necesitar reescritura durante review;
- desaparecer dos semanas después;
- provocar un incidente en producción.
Git AI mejora la observabilidad de la procedencia. No reemplaza CI, revisión, property tests, análisis estático, observabilidad de producción ni juicio de ingeniería.
Una forma más útil de pensar en las métricas es:
actividad del agente
        ↓
código generado
        ↓
código aceptado
        ↓
código mergeado
        ↓
código que sobrevive
        ↓
resultado del sistema
Cuanto más abajo puedas medir, más cerca estás de hablar de productividad y no simplemente de volumen.
git ai blame: un git blame para humanos y agentes
Para inspeccionar un archivo:
git ai blame src/auth.tsGit AI lo plantea como un reemplazo de git blame que conserva las opciones normales de Git pero añade la atribución del agente.
Conceptualmente, puedes terminar viendo algo parecido a:
commit-a  human              1) import ...
commit-a  human              2)
commit-b  Codex | model-x    3) function validate(...) {
commit-b  Codex | model-x    4)   ...
commit-b  Codex | model-x    5) }
commit-c  human              6) // follow-up fix
Eso vuelve posibles preguntas que antes exigían reconstruir sesiones manualmente:
¿esta función la escribió una persona o un agente?
¿qué herramienta produjo las líneas que estoy revisando?
¿cuánto de este archivo ha sido reescrito después?
También existe salida JSON para construir herramientas propias alrededor de la atribución.
Ver las Git Notes directamente
Git AI no oculta el mecanismo. Puedes inspeccionar las notas con Git:
git log --show-notes="ai"La nota contiene el mapa de líneas y metadata de las sesiones. La especificación abierta utiliza el namespace:
refs/notes/aiEsto tiene una ventaja arquitectónica importante: la atribución está ligada a Git y a commits concretos, no únicamente a un dashboard externo.
Para equipos que quieren experimentar sin comprar una plataforma completa, esas notas y git ai stats --json son suficiente materia prima para construir métricas internas.
Un experimento mínimo de cinco minutos
La mejor forma de entender Git AI es crear una prueba pequeña:
mkdir git-ai-demo
cd git-ai-demo
git init

echo "# Demo" > README.md
git add README.md
git commit -m "docs: initial readme"

codex exec "añade una sección breve de instalación al README"

git add README.md
git commit -m "docs: add installation section"

git ai stats --json
git ai blame README.md
git log --show-notes="ai"
Lo importante no es obtener un porcentaje espectacular. La prueba debe responder tres preguntas:
- ¿las líneas que tocó el agente aparecen atribuidas a IA?;
- ¿las líneas escritas manualmente permanecen separadas?;
- ¿la nota sigue existiendo después del flujo Git que utiliza normalmente el equipo?
Si alguna falla, primero hay que corregir la instrumentación. No tiene sentido construir dashboards sobre atribución incompleta.
Qué pasa con Squash and Merge en GitHub
Hay una diferencia entre hacer:
git merge --squash feature-branchlocalmente y pulsar Squash and merge en la interfaz web de un proveedor Git.
Cuando el servidor crea el nuevo commit, Git AI no está ejecutándose allí para reconstruir la atribución. La documentación señala que los squash/rebase merges hechos desde GitHub, GitLab, Bitbucket o Azure DevOps necesitan la plataforma de Git AI o sus acciones CI open source para preservar correctamente esa metadata.
Para GitHub existe un instalador:
git ai ci github installEl workflow generado se ejecuta después del merge, instala Git AI y reconstruye la autoría del commit resultante. Necesita permiso para escribir la referencia de notes:
permissions:
  contents: write
Esto merece revisión igual que cualquier workflow con permisos de escritura. La ventaja es que la acción escribe atribución, no necesita modificar las ramas de aplicación.
Llevar stats al CI
Una integración sencilla puede ejecutar, por PR o por commit:
git ai stats main..HEAD --json > git-ai-stats.jsonLuego el JSON puede guardarse como artifact o enviarse a una base analítica.
Por ejemplo:
PR              AI add.   AI accepted   Human add.   Acceptance
feature-a          420          310            55        73.8%
feature-b          160          151            84        94.4%
feature-c          900          210            12        23.3%
El tercer caso podría ser mucho más interesante que el segundo: quizá el agente estuvo explorando, reescribiendo y descartando grandes cantidades de código.
Esa señal no significa automáticamente “modelo malo”. Puede indicar:
- instrucciones ambiguas;
- arquitectura difícil de descubrir;
- falta de tests rápidos;
- documentación pobre;
- contexto insuficiente;
- tooling lento;
- un problema mal dividido.
Es decir, la métrica puede servir para harness engineering, no solo para juzgar modelos.
De porcentaje de IA a ROI
Un dashboard que solo diga “82 % del código lo escribió IA” es fácil de construir y fácil de malinterpretar.
Una evaluación más madura combina varias capas:
| Métrica | Pregunta útil |
|---|---|
% AI | ¿Cuánto código atribuido a agentes entra en los commits? |
| aceptación | ¿Cuánto de lo generado sobrevive hasta el commit? |
| rework en review | ¿Cuánto debe corregirse antes del merge? |
| churn | ¿Cuánto desaparece o se reescribe después? |
| tests / regresiones | ¿El cambio mantiene los invariantes? |
| incidentes | ¿El código contribuyó a fallos de producción? |
| tokens / coste | ¿Cuánto costó llegar al resultado? |
| tiempo humano | ¿Cuánta supervisión necesitó el agente? |
La versión open source cubre muy bien la atribución ligada a commits. Git AI for Teams añade uniones con datos del SDLC, PRs, coste de modelos, rework e incidentes.
La dirección es más interesante que una cifra aislada:
menos tokens
+ menos intervención humana
+ menos rework
+ misma o mejor calidad
= agente más efectivo
Privacidad: local-first no significa “no revisar nada”
En modo open source sin login, la política de privacidad de Git AI indica que código, prompts y datos de uso del agente permanecen localmente. Los prompts se guardan en una base SQLite local.
Pero hay dos detalles importantes.
Primero, la telemetría de errores y excepciones está habilitada por defecto en OSS y puede desactivarse mediante la configuración de telemetry_oss.
Segundo, las Git Notes de atribución sí forman parte del repositorio y pueden ser leídas por quien tenga acceso. Según la documentación, pueden incluir:
- agente y modelo;
- qué líneas fueron generadas por IA;
- porcentajes de aceptación;
- identidad Git —nombre y correo— de quien dirigió el prompt.
Por eso, antes de publicar un repositorio o sus notes, hay que revisar metadata además del contenido.
En ejemplos públicos evita incluir:
nombres reales de hosts
usuarios internos
IDs de cloud o de jobs
IPs
URLs privadas
rutas que revelen proyectos
nombres de clientes
correos personales
API keys
tokens
fragmentos de credenciales
Y nunca uses secretos reales para “demostrar” cómo funciona el tracking.
Limitaciones que conviene conocer
Git AI documenta algunas limitaciones actuales. Entre ellas:
git mvtodavía no preserva correctamente la atribución del archivo renombrado;git filter-branchygit filter-repono reconstruyen la atribución durante reescrituras masivas;- comandos Bash ejecutados por un agente fuera de la raíz correcta del repositorio pueden reducir la precisión de la atribución;
- merges squash/rebase realizados por la UI del proveedor necesitan CI o la plataforma para preservar las notes.
También es razonable tratar los identificadores de modelo como datos de observabilidad, no como una garantía perfecta. Las integraciones evolucionan y ha habido bugs históricos donde el modelo aparecía como unknown aunque la atribución de líneas sí funcionara.
Un patrón práctico para agentes autónomos
Si tienes un agente que trabaja de manera repetitiva sobre issues, una secuencia medible podría ser:
issue
  ↓
agente
  ↓
tests
  ↓
commit + Git AI attribution
  ↓
PR
  ↓
CI
  ↓
review
  ↓
merge
  ↓
producción
Y guardar por cada trabajo algo así:
{
  "task": "feature-example",
  "agent": "codex",
  "ai_additions": 436,
  "ai_accepted": 294,
  "human_additions": 38,
  "tests_passed": true
}
Más adelante puedes unir esos datos con duración del PR, revisiones, regresiones y coste.
El punto no es construir una clasificación de “humano vs. IA”. Es descubrir qué combinación de agente, modelo, contexto, tests y workflow entrega cambios útiles con menos desperdicio.
La consecuencia de que Git AI se una a OpenAI
El anuncio de septiembre de 2026 sugiere una dirección clara para Codex: además de hacer que los agentes produzcan código, OpenAI quiere mejorar la capacidad de medir qué ocurre con ese código después.
Eso importa porque la siguiente etapa de los agentes de software no se decide solamente por quién escribe más rápido. Se decide por quién puede demostrar:
qué generó
qué se aceptó
qué se corrigió
qué llegó a producción
qué sobrevivió
cuánto costó
Git AI convierte una parte de esa trazabilidad en datos asociados directamente a Git.
Para un desarrollador individual puede empezar con dos comandos:
git ai stats --json
git ai blame <archivo>
Para un equipo con agentes autónomos, esos mismos datos pueden convertirse en la primera capa de observabilidad de una software factory agentic.