 Capital de Tokens
Un sistema puede funcionar perfectamente durante una demostración y aun así ser poco confiable.
Puede responder rápido cuando todo está sano, pasar todos sus tests y desplegar sin errores. Pero la pregunta importante aparece después:
¿qué ocurre cuando una dependencia deja de responder, una API externa devuelve errores, una máquina se reinicia o una etapa de un pipeline falla después de veinte minutos de trabajo?
Ahí empieza la ingeniería de confiabilidad.
La idea central es sencilla: no diseñar asumiendo que nada fallará, sino diseñar sabiendo que eventualmente algo va a fallar.
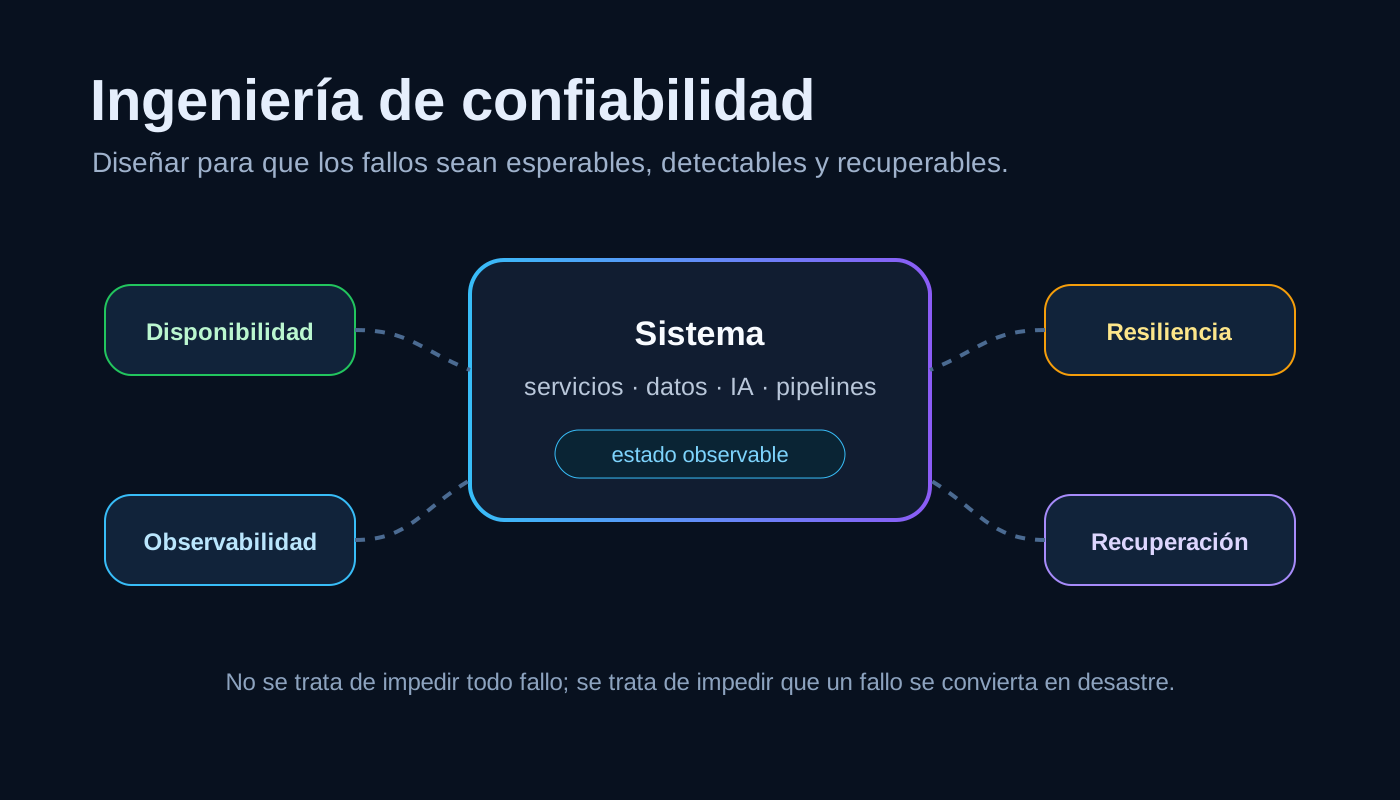
Qué es la ingeniería de confiabilidad
La ingeniería de confiabilidad —Reliability Engineering— es la disciplina que busca que un sistema siga ofreciendo el comportamiento esperado de forma consistente durante el tiempo para el que fue diseñado.
En software eso no significa solamente “tener pocos bugs”.
La confiabilidad también depende de preguntas operativas:
- ¿qué porcentaje del tiempo está disponible el sistema?;
- ¿qué ocurre cuando una dependencia falla?;
- ¿podemos detectar rápidamente una degradación?;
- ¿podemos recuperarnos sin intervención manual?;
- ¿podemos reintentar una operación sin duplicar efectos?;
- ¿podemos desplegar una nueva versión sin derribar todo el servicio?;
- ¿sabemos exactamente qué ocurrió después de un incidente?;
Un sistema confiable no es necesariamente un sistema que nunca falla.
Es un sistema donde los fallos son esperables, observables, contenidos y recuperables.
La diferencia entre “funciona” y “es confiable”
Imagina un pipeline que genera un episodio automáticamente:
Artículo
   ↓
Guion
   ↓
Audio
   ↓
Imágenes
   ↓
Video
   ↓
Publicación
Una validación funcional podría decir:
El pipeline funciona porque fue capaz de generar y publicar un episodio completo.
La ingeniería de confiabilidad hace preguntas diferentes.
¿Qué ocurre si la cuarta imagen falla después de que el guion y el audio ya fueron generados?
Un diseño frágil podría reiniciar todo el proceso.
Imagen 4 falla
      ↓
volver a empezar
      ↓
regenerar guion
      ↓
regenerar audio
      ↓
regenerar imágenes
Eso desperdicia tiempo, dinero y capacidad de cómputo. También introduce nuevas oportunidades de fallo.
Un diseño confiable conserva el trabajo válido y reanuda desde un punto seguro.
Artículo ✅
Guion    ✅
Audio    ✅
Imagen 1 ✅
Imagen 2 ✅
Imagen 3 ✅
Imagen 4 ❌

     retry
       ↓
Imagen 4 ✅
Video    ✅
Publicación ✅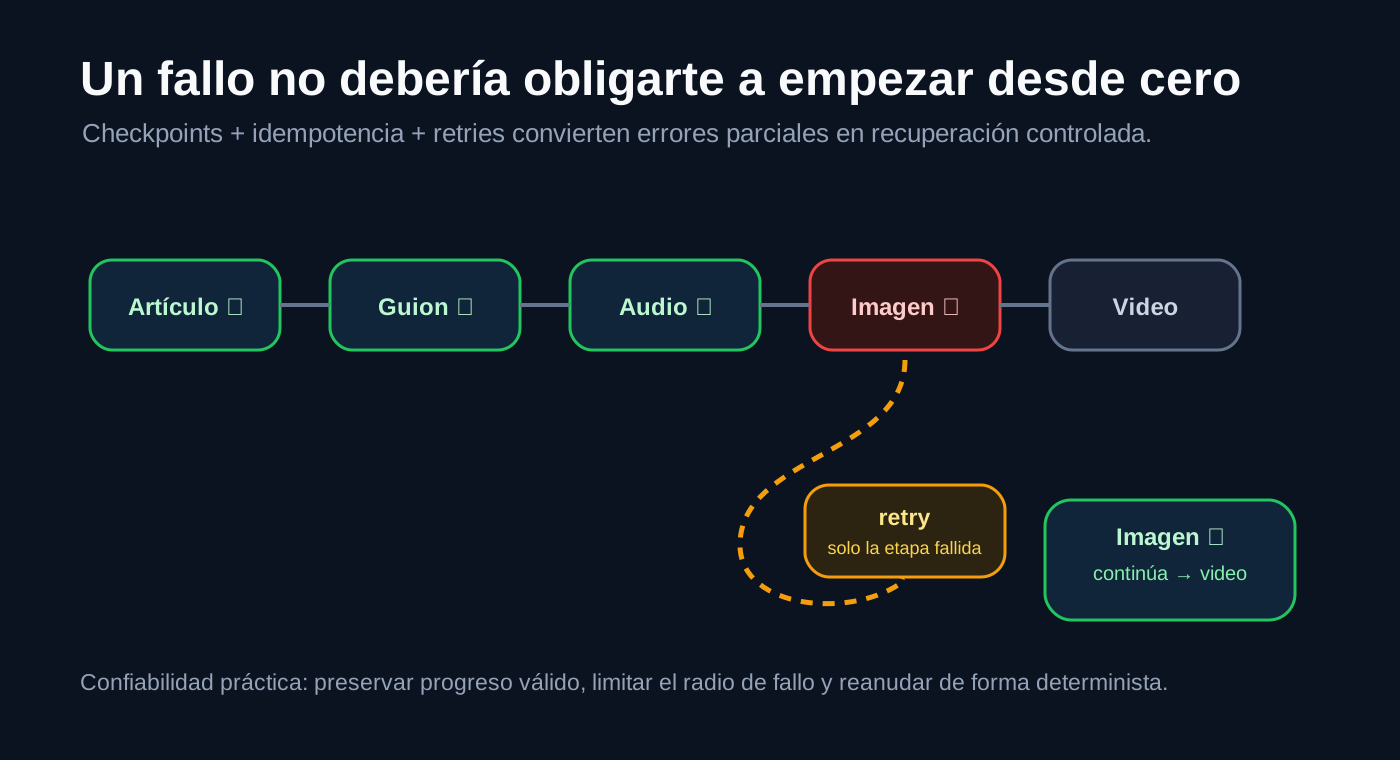
Aquí aparecen tres conceptos especialmente importantes: checkpoints, idempotencia y retries.
Checkpoints: conservar progreso válido
Un checkpoint registra que una etapa terminó correctamente y que su resultado puede reutilizarse.
En un pipeline largo, esto permite reanudar desde el último punto consistente en lugar de repetir todo el proceso.
La idea puede verse así:
etapa A ✅ → guardar estado
etapa B ✅ → guardar estado
etapa C ❌

reinicio
   ↓
leer estado
   ↓
reanudar desde C
Los checkpoints son especialmente útiles cuando las etapas son costosas: generación de video, entrenamiento, inferencia de modelos, procesamiento de grandes archivos o llamadas a APIs externas.
Idempotencia: repetir sin duplicar efectos
Una operación es idempotente cuando puede ejecutarse varias veces y producir el mismo resultado observable que si se hubiera ejecutado una sola vez.
Esto importa muchísimo en sistemas distribuidos.
Supón que una aplicación envía una solicitud para publicar un video y luego pierde la conexión antes de recibir la respuesta.
La aplicación no sabe si la publicación ocurrió.
Si simplemente repite la operación, podría crear dos publicaciones.
Una estrategia confiable utiliza un identificador estable:
publish(video, operation_id="episode-184-youtube")El servidor puede reconocer que esa operación ya fue procesada y devolver el resultado existente en vez de repetirla.
Sin idempotencia, los retries pueden convertirse en una fuente de corrupción.
Retries: volver a intentar, pero con criterio
Reintentar automáticamente puede aumentar mucho la confiabilidad, pero un retry mal diseñado puede empeorar un incidente.
Un patrón típico utiliza exponential backoff:
intento 1
  ↓ falla
esperar 1 s
intento 2
  ↓ falla
esperar 2 s
intento 3
  ↓ falla
esperar 4 s
Normalmente se añade también un pequeño componente aleatorio —jitter— para evitar que miles de clientes reintenten exactamente al mismo tiempo.
Pero no todos los errores deben reintentarse.
Un timeout temporal puede justificar un retry.
Una credencial inválida probablemente no.
La confiabilidad no consiste en poner retry() alrededor de todo. Consiste en clasificar fallos y definir una política explícita para cada uno.
Disponibilidad, confiabilidad y resiliencia no son lo mismo
Estos términos suelen utilizarse como sinónimos, pero describen propiedades distintas.
Disponibilidad
La availability mide cuánto tiempo un sistema puede utilizarse.
Un servicio con 99,9 % de disponibilidad puede estar indisponible alrededor de decenas de minutos en un mes típico.
La disponibilidad responde principalmente a:
¿El servicio está accesible cuando el usuario lo necesita?
Confiabilidad
La reliability pregunta si el sistema produce resultados correctos y consistentes durante el tiempo esperado.
Un endpoint puede estar disponible y responder HTTP 200, pero devolver resultados incorrectos.
Eso sería disponibilidad sin verdadera confiabilidad.
Resiliencia
La resilience describe la capacidad del sistema para soportar problemas y recuperar un estado útil.
Una arquitectura resiliente puede degradar algunas funcionalidades sin perder completamente el servicio.
Por ejemplo:
servicio principal
      ↓
API externa caída
      ↓
usar caché o fallback
      ↓
continuar con funcionalidad reducida
El objetivo no siempre es preservar el 100 % de las funciones. A veces es preservar la función más importante.
Fault tolerance: seguir funcionando a pesar del fallo
La tolerancia a fallos va un paso más allá.
En lugar de simplemente recuperarse después del error, el sistema puede seguir funcionando mientras uno de sus componentes está roto.
Ejemplo clásico:
Servidor A ─┐
Servidor B ─┼→ balanceador → usuarios
Servidor C ─┘
Si el servidor B deja de responder, A y C continúan atendiendo tráfico.
Pero la redundancia por sí sola no garantiza confiabilidad.
Si los tres servidores dependen de la misma base de datos sin redundancia, esa base de datos sigue siendo un único punto de fallo.
La pregunta útil es siempre:
¿Qué componentes pueden romper todo el sistema por sí solos?
Observabilidad: saber qué está pasando
No puedes recuperar rápidamente un sistema si no sabes qué está fallando.
Por eso la observabilidad es uno de los pilares de la confiabilidad moderna.
Normalmente se construye alrededor de tres fuentes principales:
logs
métricas
traces
Los logs explican eventos concretos.
Las métricas permiten observar tendencias: latencia, errores, uso de CPU, número de jobs fallidos, profundidad de una cola.
Los traces permiten seguir una operación a través de varios servicios.
En un sistema distribuido, esto cambia completamente el diagnóstico.
Sin observabilidad:
"el pipeline falló"Con observabilidad:
job: episode-184
step: image_generation
provider: image-api
attempt: 3
error: timeout
latency: 31.4 s
checkpoint: audio_complete
La segunda versión es accionable.
SLI, SLO y SLA
La ingeniería de confiabilidad necesita métricas, no solamente sensaciones.
Aquí aparecen tres términos fundamentales.
SLI — Service Level Indicator
Es una medición real del comportamiento del servicio.
Por ejemplo:
99,95 % de solicitudes completadas correctamenteSLO — Service Level Objective
Es el objetivo interno que queremos alcanzar.
Nuestro objetivo es mantener al menos 99,9 % de solicitudes exitosas.SLA — Service Level Agreement
Es un compromiso formal con el cliente.
Garantizamos contractualmente 99,9 % de disponibilidad mensual.Puede resumirse así:
SLI = qué estamos midiendo
SLO = qué queremos conseguir
SLA = qué prometemos externamente
Esta distinción es importante porque no todos los objetivos internos deben convertirse en promesas contractuales.
El error budget
Una consecuencia muy útil de definir un SLO es que también podemos definir cuánto fallo estamos dispuestos a tolerar.
Eso se conoce como error budget.
Si nuestro objetivo no es 100 %, estamos reconociendo una realidad importante: perseguir disponibilidad absoluta puede ser extremadamente caro.
El error budget ayuda a equilibrar dos fuerzas que compiten constantemente:
velocidad de cambio ←→ estabilidadSi el sistema está funcionando muy por encima del objetivo, el equipo puede asumir más riesgo y desplegar cambios con mayor velocidad.
Si está consumiendo rápidamente su presupuesto de error, conviene reducir cambios y concentrarse en estabilidad.
La confiabilidad deja así de ser una discusión subjetiva y se convierte en una decisión operativa basada en datos.
Entonces, ¿qué es SRE?
Site Reliability Engineering, o SRE, aplica estas ideas al funcionamiento de sistemas de software en producción.
Una forma útil de pensarlo es:
Ingeniería de software
        +
Operaciones
        +
Ingeniería de confiabilidad
        ↓
       SRE
SRE intenta resolver problemas operativos mediante software y automatización.
Un equipo SRE puede trabajar con:
- health checks;
- alertas;
- retries;
- circuit breakers;
- rate limiting;
- autoscaling;
- despliegues canary;
- rollback automático;
- disaster recovery;
- gestión de capacidad;
- postmortems;
- definición de SLOs;
- eliminación de trabajo manual repetitivo.
La idea es evitar que operar un sistema dependa de que una persona esté constantemente vigilándolo.
Circuit breakers: dejar de golpear una dependencia rota
Supón que tu aplicación llama a un servicio externo.
Si ese servicio está caído y cada request intenta llamarlo de nuevo, el problema puede propagarse.
Un circuit breaker detecta una tasa de fallos elevada y deja temporalmente de enviar tráfico a esa dependencia.
requests
   ↓
servicio externo
   ↓
muchos fallos
   ↓
circuit breaker OPEN
   ↓
fallar rápido / usar fallback
Después de un intervalo, el sistema prueba de nuevo.
Si la dependencia se recuperó, el circuito vuelve a cerrarse.
Esto limita el daño y evita gastar recursos esperando respuestas que probablemente no llegarán.
Código completo: un cliente de IA resiliente en Python
Para ver estos patrones funcionando juntos, preparé un ejemplo ejecutable en un solo archivo. Implementa timeout, retries con exponential backoff + jitter, circuit breaker con estados CLOSED / OPEN / HALF_OPEN, fallback, métricas y logs. También incluye un proveedor simulado que puede ejecutarse sin dependencias externas y un adaptador opcional para OpenAI.
Si quieres entender por qué ese cliente está estructurado así, la continuación natural es Patrones de diseño detrás de un cliente de IA resiliente: allí se descomponen Strategy, Adapter, Dependency Injection, Facade, Simple Factory y la máquina de estados del circuit breaker sobre este mismo ejemplo.
Ver resilient_ai_example.py en el Gist público →
También queda disponible como archivo directo del sitio:
Puedes ejecutarlo sin instalar nada adicional:
python resilient_ai_example.pyY, si quieres probar el adaptador de OpenAI:
pip install openai
export OPENAI_API_KEY="..."
python resilient_ai_example.py --openai "Explica circuit breaker en 3 frases"
El ejemplo aplica una idea importante de este artículo: no todos los fallos reciben el mismo tratamiento. Los errores temporales pueden reintentarse; los errores permanentes fallan sin retries ciegos; y el circuit breaker evita seguir golpeando una dependencia que ya está demostrando estar degradada.
Confiabilidad en sistemas de IA
Los sistemas de inteligencia artificial añaden un problema nuevo: la infraestructura puede funcionar perfectamente y aun así la salida puede ser incorrecta.
Una llamada a un modelo puede devolver HTTP 200 y producir contenido defectuoso.
Por eso la confiabilidad en sistemas de IA necesita capas adicionales.
Por ejemplo:
prompt
  ↓
modelo
  ↓
validación estructural
  ↓
verificación factual
  ↓
evaluación de calidad
  ↓
aprobación / fallback
En aplicaciones agentic, además hay que controlar acciones.
Un agente puede ejecutar correctamente una herramienta y aun así haber tomado una decisión equivocada.
Por eso aparecen mecanismos como:
- validación de outputs;
- schemas estrictos;
- evaluaciones automáticas;
- límites de autonomía;
- permisos por herramienta;
- checkpoints de estado;
- trazabilidad de decisiones;
- retries condicionados;
- aprobación humana para acciones de alto impacto;
- compensating actions para revertir efectos.
La confiabilidad del futuro no será solamente infraestructura confiable.
También será razonamiento verificable y ejecución controlada.
Un buen sistema no intenta esconder todos los fallos
Existe una tentación frecuente: capturar cualquier excepción y continuar.
Eso puede producir sistemas que parecen estables mientras acumulan corrupción silenciosa.
Un principio más sano es distinguir entre:
fallo recuperable
fallo degradable
fallo crítico
Un fallo recuperable puede reintentarse.
Un fallo degradable permite continuar con funcionalidad limitada.
Un fallo crítico debe detener el proceso, preservar evidencia y alertar.
A veces fallar rápido y claramente es más confiable que continuar incorrectamente.
Los postmortems también forman parte de la ingeniería
Después de un incidente importante, un equipo maduro no se limita a arreglar el bug.
Intenta entender por qué el sistema permitió que ese bug se convirtiera en un incidente.
Un buen postmortem pregunta:
- ¿qué ocurrió?;
- ¿cuándo empezó?;
- ¿cómo se detectó?;
- ¿qué impacto tuvo?;
- ¿qué mecanismos funcionaron?;
- ¿qué mecanismos no funcionaron?;
- ¿por qué el problema pudo propagarse?;
- ¿qué cambios reducirán la probabilidad o el impacto futuro?;
El objetivo no es buscar culpables.
El objetivo es mejorar el sistema.
La idea más importante
La ingeniería de confiabilidad parte de una premisa incómoda pero poderosa:
todo componente puede fallar.
Una red puede cortarse.
Una API puede saturarse.
Una máquina puede reiniciarse.
Una dependencia puede cambiar.
Un despliegue puede contener un bug.
Un modelo de IA puede devolver una respuesta incorrecta.
Lo que diferencia a un sistema robusto no es la ausencia total de esos eventos.
Es la forma en que responde cuando ocurren.
fallo
  ↓
detección
  ↓
contención
  ↓
recuperación
  ↓
aprendizaje
Ese ciclo es, en esencia, la ingeniería de confiabilidad.
Y cuanto más dependemos de cloud, microservicios, automatización, pipelines y agentes de IA, más importante se vuelve.
Porque en sistemas reales la pregunta nunca es solamente:
¿Funciona?
La pregunta que importa es:
¿Qué pasa cuando deja de funcionar?