 Capital de Tokens
Llamar a un modelo de IA desde código parece sencillo:
response = client.responses.create(...)Pero en producción esa línea vive en un mundo menos limpio: la red puede tardar demasiado, la API puede devolver un error temporal, un proveedor puede quedar degradado, una credencial puede ser inválida o una dependencia puede fallar justo cuando tenemos tráfico real.
Por eso un cliente de IA resiliente no es solamente un wrapper alrededor de un SDK. Es una pequeña pieza de arquitectura donde aparecen varios patrones de diseño clásicos y varios patrones operativos de resiliencia.
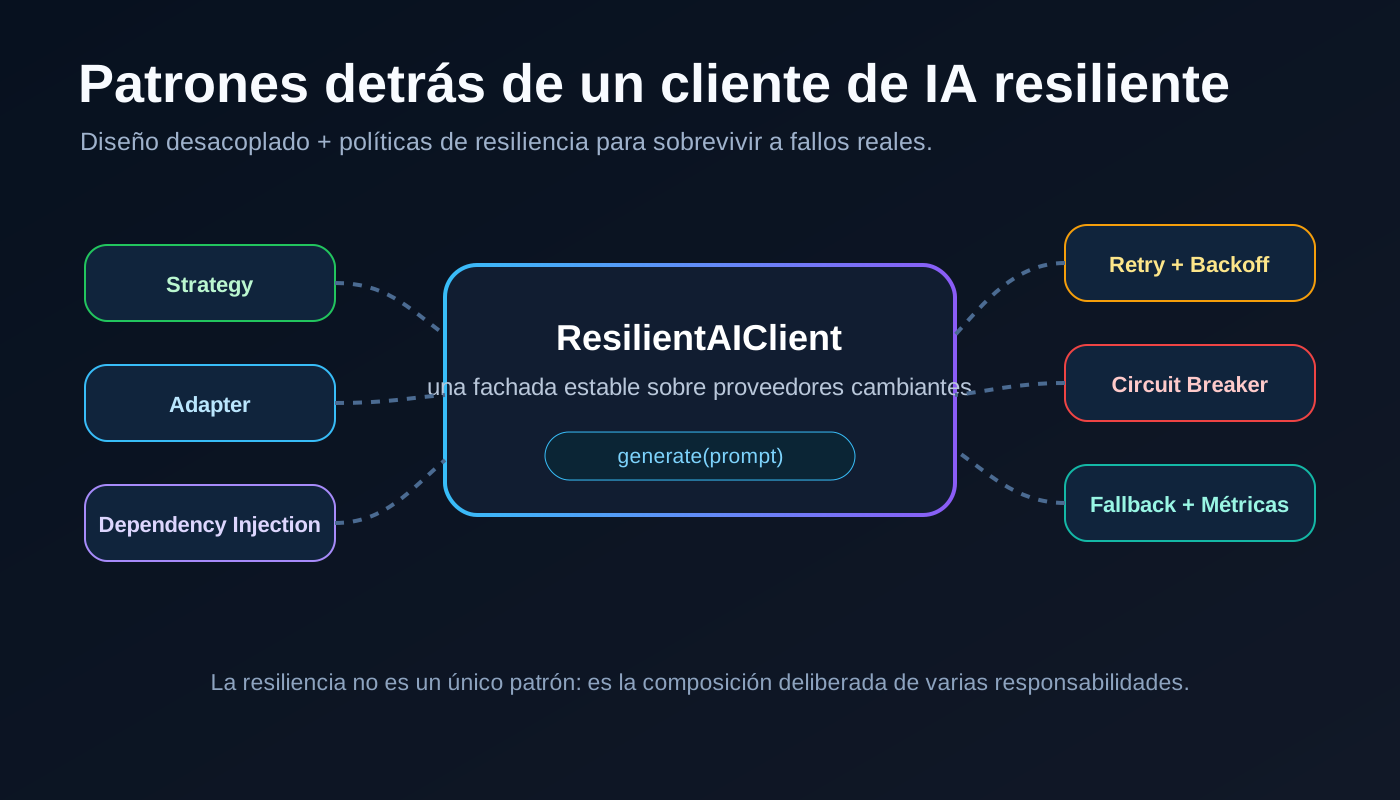
En este artículo vamos a desarmar un ejemplo concreto de cliente resiliente y ver qué patrones aparecen, por qué están ahí y cómo se relacionan entre sí.
El ejemplo de referencia puede consultarse en este Gist: Cliente de IA resiliente: timeout, retries, circuit breaker, fallback y métricas.
Este artículo baja esas ideas a la arquitectura del código. Para el marco más amplio —SRE, disponibilidad, SLOs, error budgets, checkpoints, idempotencia, recuperación y observabilidad— conviene empezar por Ingeniería de confiabilidad: cómo diseñar sistemas que fallen bien.
El mapa general
Los patrones principales son estos:
| Patrón | Papel dentro del cliente | Beneficio |
|---|---|---|
| Strategy | AIProvider y sus implementaciones | Cambiar proveedor sin tocar el cliente resiliente |
| Adapter | OpenAIProvider | Traducir el SDK real al contrato interno |
| Dependency Injection | El proveedor llega por constructor | Desacoplar creación y uso |
| Circuit Breaker | CircuitBreaker | Dejar de golpear temporalmente a una dependencia enferma |
| State machine | CLOSED, OPEN, HALF_OPEN | Cambiar comportamiento según el estado del circuito |
| Simple Factory | build_client() | Centralizar la construcción de la configuración |
| Facade | ResilientAIClient | Exponer una API sencilla sobre varias políticas internas |
A eso se suman patrones de resiliencia como timeout, retry, exponential backoff, jitter, fallback y observabilidad.
La idea importante es esta:
La resiliencia no suele venir de un único patrón. Viene de componer varias responsabilidades pequeñas alrededor de una operación crítica.
1. Strategy: elegir el proveedor sin cambiar el cliente
El patrón Strategy permite encapsular distintas formas de ejecutar una misma operación detrás de un contrato común.
En Python, un Protocol encaja muy bien para este propósito:
class AIProvider(Protocol):
    def generate(self, prompt: str, timeout: float) -> str:
        ...
La aplicación puede tener distintas implementaciones:
class DemoProvider:
    def generate(self, prompt: str, timeout: float) -> str:
        ...


class OpenAIProvider:
    def generate(self, prompt: str, timeout: float) -> str:
        ...
El cliente resiliente no necesita saber cuál está usando:
class ResilientAIClient:
    def __init__(self, provider: AIProvider):
        self.provider = provider

    def generate(self, prompt: str) -> str:
        return self.provider.generate(prompt, timeout=10)
Conceptualmente:
                 AIProvider
                     ▲
              ┌──────┴───────┐
              │              │
       DemoProvider    OpenAIProvider
              ▲              ▲
              └──────┬───────┘
                     │
            ResilientAIClient
El beneficio es enorme: la política de resiliencia deja de depender de OpenAI, Anthropic, un modelo local o cualquier otro proveedor concreto.
Eso reduce acoplamiento y facilita pruebas.
Strategy también ayuda a testear
Si ResilientAIClient recibiera directamente un SDK real, probar retries o circuit breaker requeriría llamadas de red o mocks mucho más intrusivos.
Con Strategy podemos inyectar un proveedor controlado:
class AlwaysFailProvider:
    def generate(self, prompt: str, timeout: float) -> str:
        raise RetryableAIError("temporary failure")
Y probar exactamente cómo reacciona la capa resiliente.
2. Dependency Injection: depender de abstracciones
Strategy funciona especialmente bien porque el proveedor se inyecta desde afuera:
client = ResilientAIClient(provider=OpenAIProvider())Eso es Dependency Injection.
El cliente no hace esto:
class ResilientAIClient:
    def __init__(self):
        self.provider = OpenAIProvider()
Si lo hiciera, quedaría acoplado a una implementación específica.
La versión inyectada respeta mejor el principio de inversión de dependencias:
alto nivel
ResilientAIClient
       │
       ▼
abstracción
AIProvider
       ▲
       │
bajo nivel
OpenAIProvider
El componente de alto nivel depende del contrato, no de los detalles del SDK.
3. Adapter: domesticar el SDK externo
OpenAIProvider cumple además otro papel: funciona como Adapter.
La aplicación quiere una interfaz simple:
provider.generate(prompt, timeout)El SDK externo, en cambio, puede trabajar con otra forma:
client.responses.create(
    model=model,
    input=prompt,
)
El adapter traduce entre ambos mundos:
ResilientAIClient
       │
       │ AIProvider.generate()
       ▼
 OpenAIProvider
       │
       │ adapta
       ▼
OpenAI SDK
Esto evita que las estructuras del SDK se filtren por toda la aplicación.
También permite traducir excepciones técnicas a errores propios del dominio:
RetryableAIError
NonRetryableAIError
Esa clasificación es muy importante porque el sistema necesita saber qué errores vale la pena reintentar y cuáles no.
4. Circuit Breaker: saber cuándo dejar de insistir
Uno de los patrones más importantes en sistemas distribuidos es Circuit Breaker.
Imagina que una API externa está completamente caída.
Sin circuit breaker:
request → falla
retry   → falla
request → falla
retry   → falla
request → falla
retry   → falla
El cliente sigue gastando conexiones, tiempo y recursos contra un servicio que claramente no está sano.
Con circuit breaker:
varios fallos
     ↓
abrir circuito
     ↓
rechazar llamadas temporalmente
     ↓
esperar recuperación
     ↓
probar una llamada
El circuito suele tener tres estados:
class CircuitState(str, Enum):
    CLOSED = "CLOSED"
    OPEN = "OPEN"
    HALF_OPEN = "HALF_OPEN"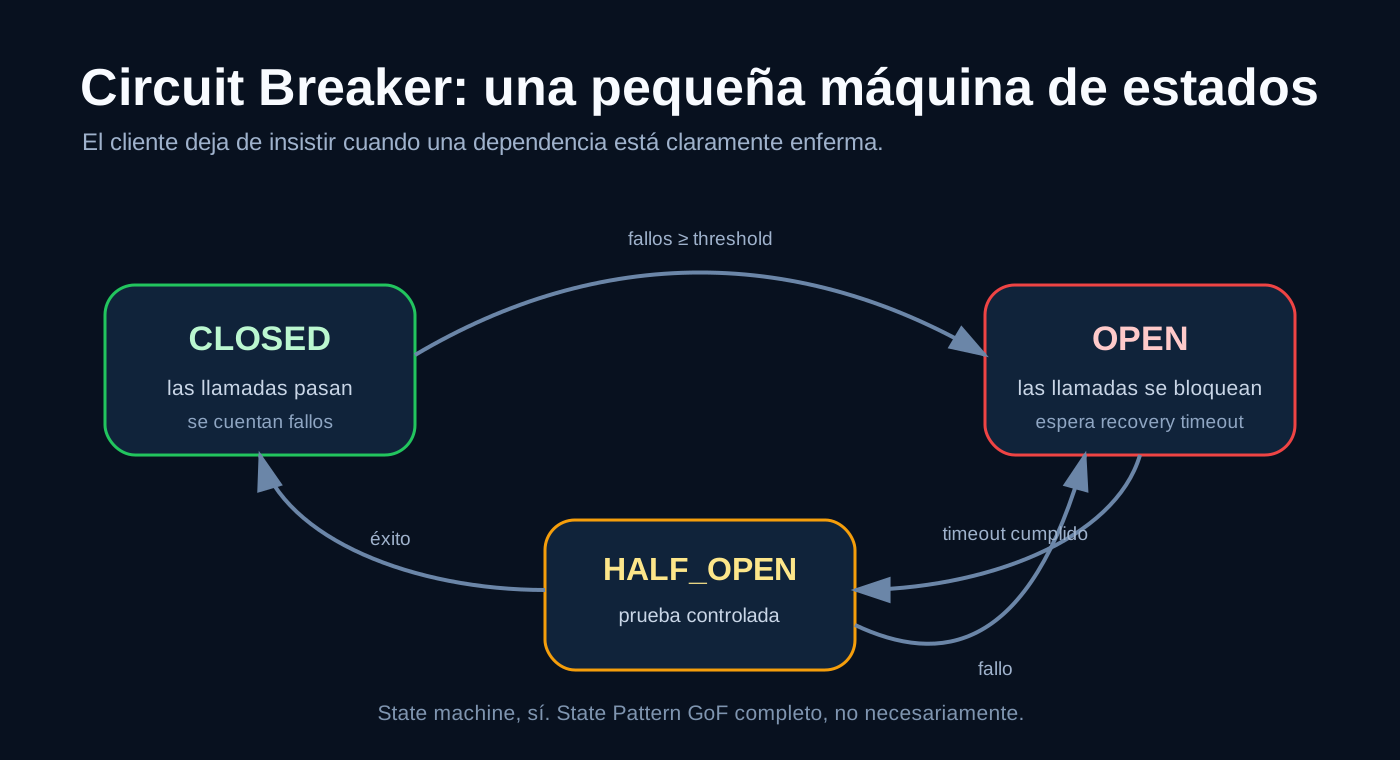
CLOSED
Las llamadas pasan normalmente. Si los fallos consecutivos superan un umbral, el circuito se abre.
OPEN
Las llamadas se bloquean temporalmente para no seguir castigando a la dependencia.
HALF_OPEN
Después de un tiempo de recuperación se permite una llamada de prueba.
Si funciona, el circuito vuelve a CLOSED.
Si falla, vuelve a OPEN.
¿Es también el patrón State?
Aquí conviene ser precisos.
Tenemos una máquina de estados, pero eso no significa necesariamente que estemos usando el patrón GoF State en su forma completa.
Una implementación clásica de State podría tener objetos separados:
ClosedState
OpenState
HalfOpenState
Cada estado encapsularía su comportamiento.
Si en cambio usamos un Enum y condicionales dentro de CircuitBreaker, lo más correcto es decir que existe una state machine simplificada.
La distinción es útil porque evita llamar “State Pattern” a cualquier código que tenga una variable state.
5. Simple Factory: centralizar la construcción
Supongamos que la aplicación tiene una función como esta:
def build_client(use_openai: bool) -> ResilientAIClient:
    if use_openai:
        provider = OpenAIProvider()
    else:
        provider = DemoProvider()

    return ResilientAIClient(provider=provider)
Esto centraliza la decisión sobre qué objetos crear.
Es una Simple Factory.
No hace falta convertir cada función constructora en una jerarquía formal de Factory Method. Muchas veces una simple función es suficiente.
La ventaja es que el resto de la aplicación puede pedir:
client = build_client(use_openai=True)sin conocer todos los detalles de construcción.
6. Facade: una sola puerta de entrada
Desde el punto de vista del consumidor, ResilientAIClient también actúa como una Facade.
El código llamador ve algo sencillo:
result = client.generate(prompt)Pero detrás pueden ocurrir muchas cosas:
request
   ↓
timeout
   ↓
retry
   ↓
backoff + jitter
   ↓
circuit breaker
   ↓
provider adapter
   ↓
fallback
   ↓
metrics + logs
Ese es precisamente el valor de una fachada: ocultar complejidad interna detrás de una interfaz estable y pequeña.
Los patrones de resiliencia no son necesariamente GoF
Aquí aparece una distinción importante.
Strategy, Adapter o Facade son patrones clásicos de diseño orientado a objetos.
En cambio, timeout, retry o circuit breaker pertenecen más al mundo de los patrones de resiliencia y sistemas distribuidos.
No son menos importantes por eso. De hecho, en servicios reales suelen ser más decisivos que muchos patrones GoF.
Timeout: poner un límite al tiempo
Sin timeout, una llamada puede quedarse esperando durante demasiado tiempo.
El timeout define un presupuesto:
"si en 10 segundos no hay respuesta útil,
considero este intento fallido"
Esto permite recuperar control y ejecutar la siguiente política: retry, fallback o error.
Un timeout no arregla la dependencia. Evita que esa dependencia monopolice indefinidamente nuestros recursos.
Retry: repetir solo cuando tiene sentido
Un error temporal puede desaparecer en el siguiente intento.
Por ejemplo:
HTTP 429
HTTP 502
HTTP 503
timeout transitorio
Pero otros errores no deberían reintentarse:
credencial inválida
request mal formado
modelo inexistente
violación de una regla de negocio
Por eso la clasificación en errores reintentables y no reintentables es parte fundamental del diseño.
Exponential Backoff
Reintentar inmediatamente puede empeorar una caída.
Una política típica espera cada vez más:
intento 1
  ↓ falla
esperar 0.5 s
intento 2
  ↓ falla
esperar 1 s
intento 3
  ↓ falla
esperar 2 s
intento 4
  ↓ falla
esperar 4 s
Eso es exponential backoff.
El sistema da más tiempo a la dependencia para recuperarse.
Jitter: evitar el thundering herd
Ahora imagina mil clientes que reciben el mismo fallo al mismo tiempo.
Si todos esperan exactamente 1 segundo, todos volverán a golpear el servidor exactamente 1 segundo después.
Eso puede crear una nueva ola de tráfico sincronizado.
El jitter añade una pequeña variación aleatoria:
cliente A → 1.08 s
cliente B → 0.91 s
cliente C → 1.17 s
cliente D → 0.96 s
La carga se distribuye mejor en el tiempo.
Fallback: degradar en vez de caer completamente
Cuando el proveedor principal no puede responder, podemos tener una alternativa.
Ejemplos:
modelo premium → modelo más barato
proveedor remoto → modelo local
respuesta generativa → respuesta cacheada
servicio completo → funcionalidad reducida
Esto es graceful degradation.
La clave está en que el fallback debe preservar una función útil sin ocultar silenciosamente errores importantes.
Métricas y logs: resiliencia observable
Un sistema resiliente que no produce señales operativas puede ser muy difícil de mantener.
Algunas métricas útiles:
ai_requests_total
ai_request_failures_total
ai_retries_total
ai_fallbacks_total
ai_circuit_open_total
ai_latency_seconds
Con ellas podemos responder preguntas reales:
- ¿el proveedor está degradado?;
- ¿los retries están salvando solicitudes o solo añadiendo latencia?;
- ¿el fallback se está usando demasiado?;
- ¿el circuit breaker se abre con frecuencia?;
- ¿qué porcentaje de llamadas termina correctamente en el primer intento?;
La observabilidad convierte un mecanismo de resiliencia en algo que puede ser operado y mejorado.
El patrón que encajaría muy bien: Decorator
Hay una mejora arquitectónica interesante.
Si ResilientAIClient contiene directamente timeout, retry, circuit breaker, fallback y métricas, con el tiempo puede convertirse en una clase demasiado grande.
Una alternativa es modelar cada responsabilidad como un Decorator:
MetricsDecorator
       ↓
FallbackDecorator
       ↓
CircuitBreakerDecorator
       ↓
RetryDecorator
       ↓
TimeoutDecorator
       ↓
OpenAIProvider
Cada capa implementa el mismo contrato:
class AIProvider(Protocol):
    def generate(self, prompt: str, timeout: float) -> str:
        ...
Entonces podemos componer políticas:
provider = OpenAIProvider()
provider = TimeoutDecorator(provider)
provider = RetryDecorator(provider)
provider = CircuitBreakerDecorator(provider)
provider = MetricsDecorator(provider)
Esto acerca el diseño a una arquitectura muy modular.
Pero también introduce más objetos y más abstracción.
La pregunta correcta no es “¿Decorator es más elegante?”.
La pregunta es:
¿la complejidad del sistema ya justifica separar cada política en una pieza independiente?
Cómo se relaciona todo con SOLID
Este diseño toca varios principios SOLID.
Single Responsibility Principle
El proveedor se ocupa de hablar con el SDK.
El circuit breaker se ocupa de proteger contra dependencias enfermas.
La factory se ocupa de construir objetos.
La capa de métricas se ocupa de observar.
Mientras más claras sean esas fronteras, más fácil será mantener el sistema.
Open/Closed Principle
Podemos agregar un nuevo proveedor sin reescribir el cliente resiliente:
class LocalLLMProvider:
    ...
El sistema está abierto a extensión y relativamente cerrado a modificación.
Dependency Inversion Principle
ResilientAIClient depende de AIProvider, no del SDK concreto.
Eso evita que la infraestructura domine el diseño de la aplicación.
Una lectura arquitectónica completa
Podemos resumir el sistema así:
                 aplicación
                     │
                     ▼
            ResilientAIClient
                 Facade
                     │
          ┌──────────┼──────────┐
          │          │          │
        Retry     Circuit    Metrics
          │        Breaker       │
          └──────────┼──────────┘
                     │
               AIProvider
                Strategy
                     │
             ┌───────┴────────┐
             │                │
       DemoProvider      OpenAIProvider
                              │
                            Adapter
                              │
                              ▼
                         OpenAI SDK
Alrededor de esa estructura aparecen timeout, backoff, jitter y fallback.
Qué conviene decir en una entrevista
Si tuvieras que describir este diseño de forma compacta, una buena respuesta sería:
El cliente usa Strategy para abstraer proveedores, Adapter para aislar el SDK externo, Dependency Injection para desacoplar construcción y uso, Simple Factory para crear la configuración, Facade para exponer una interfaz sencilla y Circuit Breaker como patrón de resiliencia. Alrededor de eso aplica timeout, retry con exponential backoff y jitter, fallback y métricas.
Y añadiría una precisión:
CLOSED,OPENyHALF_OPENforman una máquina de estados; solo hablaría de State Pattern GoF completo si cada estado encapsulara su comportamiento en objetos separados.
La lección más importante
El valor de este ejemplo no está en acumular nombres de patrones.
Está en ver cómo cada patrón elimina un tipo concreto de acoplamiento o fallo:
Strategy          → evita acoplarse a un proveedor
Adapter           → evita filtrar el SDK por la aplicación
Dependency Injection → facilita sustitución y pruebas
Circuit Breaker   → evita insistir contra una dependencia caída
Retry             → tolera fallos transitorios
Backoff + Jitter  → evita amplificar incidentes
Fallback          → conserva funcionalidad útil
Metrics           → hace observable el comportamiento
Facade            → mantiene simple la API pública
Eso es arquitectura práctica.
No se trata de introducir patrones porque aparecen en un libro. Se trata de reconocer una fuerza concreta del sistema —acoplamiento, latencia, fallos, saturación, variabilidad de proveedores— y usar la herramienta adecuada para contenerla.
Cuando un cliente de IA empieza a participar en procesos importantes, esa diferencia separa una demo que funciona de un componente que puede vivir en producción.