 Capital de Tokens
¿Qué debería hacer un sistema de inteligencia artificial cuando no está seguro de su respuesta?
La mayoría de los sistemas actuales tienen una solución bastante rudimentaria: generar igualmente una respuesta.
Podemos pedirles que “piensen más”, podemos aumentar el presupuesto de razonamiento o podemos poner varios agentes a revisar el resultado. Pero normalmente esa decisión viene definida desde fuera: por un prompt, por una configuración fija o por una arquitectura diseñada de antemano.
Un trabajo reciente sobre metacognición artificial propone una alternativa mucho más interesante: que el propio sistema produzca señales explícitas sobre su estado y utilice esas señales para decidir cómo debe procesar cada problema.
No se trata de convertir a un LLM en una máquina consciente.
Se trata de construir una capa de control alrededor del modelo.
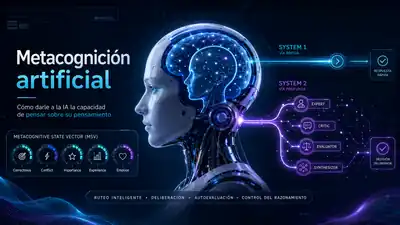
La idea apareció explicada para público general en el artículo “How to give AI the ability to ‘think’ about its ‘thinking’”, basado en el trabajo de Ricky J. Sethi, Charles Courchaine, Hefei Qiu y colaboradores. En agosto de 2026 el equipo publicó además una implementación explícita del framework para ensembles de LLMs, con routing entre procesamiento rápido y deliberativo y roles especializados dentro de un sistema multiagente.
La parte realmente importante del trabajo no es la palabra self-awareness.
Es esta arquitectura:
LLM
 ↓
monitorización
 ↓
señales de incertidumbre / conflicto / importancia
 ↓
política de control
 ↓
routing
 ↓
respuesta rápida / más razonamiento / otros agentes / humano
Eso se parece menos a “una IA pensando sobre sí misma” y mucho más a un runtime inteligente para reasoning.
Metacognición: pensar sobre el pensamiento
En psicología, la metacognición suele describirse como la capacidad de monitorizar y regular nuestros propios procesos cognitivos.
Un ejemplo cotidiano es leer una página y detectar que, aunque hemos llegado al final, realmente no entendimos nada.
Ese momento contiene dos operaciones diferentes:
- Monitorización: “No estoy entendiendo esto”.
- Control: “Debo releer, cambiar de estrategia o buscar otra explicación”.
El framework intenta trasladar esa separación a sistemas basados en LLMs.
No necesita afirmar que el modelo “siente” confusión en sentido humano. Solo necesita producir variables suficientemente útiles para que otro componente pueda actuar sobre ellas.
En ingeniería, esa distinción es fundamental.
Un termostato no necesita sentir frío para detectar una temperatura y activar la calefacción.
De la misma forma, un sistema agentic no necesita consciencia para detectar señales asociadas con incertidumbre o contradicción y gastar más recursos cuando la situación lo justifica.
La pieza central: Metacognitive State Vector
El framework introduce un Metacognitive State Vector, o MSV.
Es un vector de cinco dimensiones diseñado para cuantificar señales que describen el estado metacognitivo del sistema:
| Dimensión | Qué intenta medir |
|---|---|
| Emotional Response | Si la consulta tiene una carga emocional o sensible relevante |
| Correctness Evaluation | Qué tan fiable parece la respuesta o razonamiento actual |
| Experiential Match | Si el problema se parece a situaciones que el sistema reconoce bien |
| Conflicting Information | Si existen datos, premisas o conclusiones contradictorias |
| Problem Importance | Qué tan costoso o importante sería equivocarse |
Podemos imaginarlo de forma simplificada como:
msv = {
    "emotion": 0.2,
    "correctness": 0.43,
    "experience": 0.35,
    "conflict": 0.81,
    "importance": 0.92,
}
El valor no está en producir cinco números bonitos para un dashboard.
El valor aparece cuando esos números controlan la ejecución.
Por ejemplo:
if (
    msv["conflict"] > 0.7
    or msv["correctness"] < 0.5
    or msv["importance"] > 0.8
):
    route = "system_2"
else:
    route = "system_1"
Los umbrales reales pueden ser mucho más sofisticados. Pero el patrón arquitectónico es éste: observar primero, decidir después cuánto razonamiento comprar.
System 1 y System 2 como política de cómputo
Los investigadores utilizan la conocida distinción entre System 1 y System 2 como inspiración para dos modos de procesamiento.
System 1: la vía rápida
Una pregunta simple, familiar y de bajo riesgo puede resolverse con una ejecución barata.
consulta
  ↓
MSV
  ↓
baja complejidad / bajo conflicto
  ↓
LLM
  ↓
respuesta
No hace falta convocar cinco modelos, ejecutar tres críticas y sintetizar cuatro borradores para responder cuánto es 2 + 2.
Eso sería desperdiciar cómputo, tokens y latencia.
System 2: la vía deliberativa
Cuando aumentan el conflicto, la incertidumbre, la novedad o la importancia, el sistema puede activar una ruta más costosa.
consulta
  ↓
MSV
  ↓
incertidumbre / conflicto / alto riesgo
  ↓
System 2
  ↓
Expert
  ↓
Critic
  ↓
Evaluator
  ↓
Synthesizer
  ↓
respuesta deliberada
La implementación descrita por el equipo utiliza ensembles de LLMs y roles especializados como Domain Expert, Critic, Evaluator, Synthesizer y Generalist.
En su demo más reciente, el grupo muestra incluso asignación de roles basada en los estados metacognitivos de los agentes y una visualización de cómo cambia el MSV durante la deliberación.
Esto es más interesante como arquitectura de agentes que como filosofía
La palabra “metacognición” invita rápidamente a preguntas sobre conciencia, autoconciencia o mente artificial.
Pero desde el punto de vista de ingeniería hay una lectura más inmediata.
Imaginemos un agente de software tradicional:
Developer → Reviewer → QATodos los cambios pasan por todas las etapas.
Es seguro, pero potencialmente caro.
Ahora añadamos un controlador metacognitivo:
                         ┌───────────────► Developer
                         │                  tarea trivial
                         │
Task → Metacognitive ────┼───────────────► Developer → Reviewer
       Controller        │                  incertidumbre media
                         │
                         ├───────────────► Developer ↔ Critic → Reviewer
                         │                  conflicto alto
                         │
                         └───────────────► Developer → Reviewer → QA → Human
                                            riesgo alto
De repente el workflow deja de ser una cadena fija.
Se convierte en una política dinámica de escalado.
Eso tiene consecuencias enormes para agentes de larga duración.
Un agente que trabaja durante horas no debería utilizar su configuración de razonamiento más cara para cada decisión. Tampoco debería tratar todas las acciones como igualmente peligrosas.
Puede distinguir entre:
- leer un archivo;
- renombrar una variable;
- modificar autenticación;
- ejecutar una migración destructiva;
- desplegar a producción.
En vez de configurar un único nivel de reasoning para toda la sesión, podríamos asignarlo por decisión.
El MSV como control plane del reasoning
Esta es, para mí, la interpretación más poderosa del trabajo.
La arquitectura empieza a parecerse a un control plane.
En sistemas distribuidos, el control plane decide cómo debe comportarse la infraestructura. No procesa necesariamente cada paquete o cada request: mantiene políticas, observa estado y toma decisiones de coordinación.
Podemos trasladar la idea al reasoning:
                ┌──────────────────────┐
                │ Metacognitive Plane  │
                │                      │
input ─────────►│ uncertainty          │
                │ conflict             │
                │ importance           │
                │ experience           │
                │ emotional/safety     │
                └──────────┬───────────┘
                           │
             ┌─────────────┼─────────────┐
             ▼             ▼             ▼
         fast LLM      deep model    agent ensemble
             │             │             │
             └─────────────┼─────────────┘
                           ▼
                        output
La innovación entonces no consiste simplemente en conseguir un modelo que razone mejor.
Consiste en conseguir un sistema que decida cuándo necesita razonar mejor.
Y esa diferencia puede ser decisiva para la economía de los agentes.
Reasoning adaptativo en vez de reasoning máximo
Durante los últimos años, gran parte de la mejora en modelos de razonamiento se ha asociado con gastar más cómputo durante la inferencia.
Pero un sistema real tiene restricciones:
- latencia;
- tokens;
- GPU;
- dinero;
- límites de API;
- energía;
- disponibilidad de herramientas;
- intervención humana.
La pregunta deja de ser solamente:
¿Cuál es el modelo que razona mejor?
Y pasa a ser:
¿Cuál es la cantidad mínima de razonamiento necesaria para resolver correctamente esta decisión?
Ese cambio convierte el reasoning en un recurso que puede presupuestarse dinámicamente.
Una política hipotética podría funcionar así:
def choose_reasoning_budget(msv):
    risk = (
        0.35 * msv.importance
        + 0.30 * msv.conflict
        + 0.20 * (1 - msv.correctness)
        + 0.15 * (1 - msv.experience)
    )

    if risk < 0.25:
        return "fast"
    if risk < 0.55:
        return "standard"
    if risk < 0.80:
        return "deep"
    return "multi_agent_plus_human_gate"
El código es ilustrativo, no forma parte del paper.
Pero muestra por qué la idea es útil: la metacognición puede convertirse en un scheduler de inteligencia.
De workflows deterministas a workflows adaptativos
Hoy muchos sistemas multiagente todavía se diseñan así:
Planner
  ↓
Researcher
  ↓
Writer
  ↓
Critic
  ↓
Reviewer
Cada tarea ejecuta casi el mismo grafo.
Eso tiene ventajas: es fácil de entender, probar y observar.
Pero también tiene un problema: desperdicia trabajo cuando la tarea es sencilla y puede quedarse corto cuando la tarea es excepcionalmente difícil.
Un sistema metacognitivo permitiría transformar el grafo durante la ejecución.
simple
Task ──────────────► Worker ─────────► Done

uncertain
Task ─► Worker ─► Reviewer ──────────► Done

conflicted
Task ─► Expert ─► Critic ─► Evaluator ─► Synthesizer

high stakes
Task ─► Ensemble ─► Verification ─► Human approval ─► Action
Esto acerca los agentes a una propiedad que esperamos de buenos equipos humanos: no convocar una reunión de cinco personas para cada decisión, pero tampoco resolver una crisis crítica con una sola opinión improvisada.
Una distinción importante: autoconfianza no es calibración
Aquí aparece el problema técnico más importante.
Un LLM puede decir:
Estoy 92% seguro.Eso no implica que, de cada cien respuestas en las que declara 92% de confianza, aproximadamente 92 sean correctas.
Para que una señal de confianza sea útil como componente de control necesita estar calibrada contra resultados reales.
De lo contrario podemos construir un sofisticado controlador encima de una señal defectuosa.
El riesgo sería especialmente serio en decisiones de alto impacto:
modelo sobreconfiado
      ↓
MSV interpreta “alta corrección”
      ↓
System 1
      ↓
respuesta rápida
      ↓
error que merecía deliberación
Por eso el futuro de este tipo de sistemas probablemente requerirá combinar introspección del modelo con señales externas:
- verificadores;
- tests;
- retrieval;
- consistencia entre modelos;
- ejecución real de código;
- evidencia de herramientas;
- historial de errores;
- calibración empírica;
- aprobación humana cuando el riesgo lo requiera.
La metacognición no debería convertirse en otra forma de creerle al modelo porque el modelo dice que tiene razón.
Debe convertirse en telemetría que pueda ser contrastada.
Observabilidad del razonamiento
Hay otra consecuencia interesante.
Si el sistema genera un MSV antes y durante la ejecución, podemos observar no solo la respuesta final sino también por qué eligió una estrategia determinada.
Por ejemplo:
Query: "¿Debemos desplegar este cambio?"

Correctness: 0.58
Conflict:    0.76
Experience:  0.41
Importance:  0.93
Emotion:     0.05

Decision:
System 2 activated

Reason:
- high importance
- high conflict
- low experiential match
Eso es muy distinto de una caja negra que simplemente responde.
Para sistemas agentic, podríamos guardar esos estados junto con cada ejecución:
trace_id
prompt
model
MSV_before
routing_decision
roles_activated
tools_used
MSV_after
verification_result
final_action
Con suficientes trazas se vuelve posible preguntar cosas como:
- ¿Cuántas veces el sistema eligió System 1 y falló?
- ¿Qué señal predice mejor un error?
- ¿En qué dominios está sobreconfiado?
- ¿Cuándo activar un critic realmente mejora el resultado?
- ¿Cuánto cuesta cada punto adicional de fiabilidad?
Ahí la metacognición deja de ser una metáfora psicológica y empieza a parecerse a observabilidad operacional para agentes.
¿Y la conciencia?
El propio trabajo marca una frontera importante: este framework no demuestra conciencia ni autoconciencia humana en máquinas.
Lo que implementa es una arquitectura computacional de monitorización y regulación.
La diferencia importa.
Podemos llamar a una variable self_awareness, pero el nombre no cambia lo que hace el software.
Un MSV puede medir señales, activar políticas y reorganizar agentes sin que exista una experiencia subjetiva detrás.
Desde el punto de vista práctico, tampoco hace falta resolver primero el problema filosófico de la conciencia para que esta arquitectura sea útil.
Los sistemas autónomos necesitan urgentemente mecanismos para:
- reconocer incertidumbre;
- detectar contradicciones;
- escalar decisiones;
- asignar más cómputo cuando vale la pena;
- solicitar revisión externa;
- explicar por qué eligieron una ruta.
Eso ya sería un avance importante.
Lo siguiente: metareasoning
Los investigadores señalan como dirección futura el metareasoning: no solo evaluar el estado actual, sino razonar sobre la propia estrategia de razonamiento.
La diferencia puede entenderse así:
Reasoning:
"¿Cuál es la respuesta?"

Metacognition:
"¿Qué tan fiable parece mi proceso actual?"

Metareasoning:
"¿Cuál es la mejor estrategia para llegar a una respuesta fiable con los recursos disponibles?"
Un agente con metareasoning podría decidir entre:
buscar en la web
vs.
consultar documentación interna
vs.
ejecutar código
vs.
pedir otra opinión
vs.
crear una prueba
vs.
escalar a un humano
Y podría elegir no solo por capacidad, sino por coste esperado y reducción de incertidumbre.
Eso nos lleva hacia agentes mucho menos rígidos.
La idea que vale la pena recordar
El titular “darle a la IA la capacidad de pensar sobre su pensamiento” es atractivo.
Pero hay una interpretación técnica más útil:
hacer que el reasoning sea observable, medible y controlable.
Un LLM aislado produce una respuesta.
Un sistema metacognitivo intenta saber si esa respuesta merece confianza y decide qué recursos adicionales necesita antes de actuar.
La evolución podría verse así:
LLM
↓
LLM + tools
↓
agent
↓
agent + memory
↓
agent + verification
↓
agent + metacognitive controller
↓
adaptive reasoning system
Quizá uno de los grandes avances de los agentes no sea simplemente que los modelos aprendan a pensar más.
Puede ser que aprendamos a construir sistemas capaces de decidir cuándo pensar más, cómo hacerlo y cuándo dejar de confiar en sí mismos.
Ese problema parece mucho más cercano a la ingeniería que a la ciencia ficción.
Fuentes
- Artículo en MSN: “How to give AI the ability to ‘think’ about its ‘thinking’”
- Ricky J. Sethi / The Conversation: explicación de la metacognición artificial, republicada por Fast Company
- Courchaine, Sethi y Qiu: “Implementation of a Metacognition Framework for Self-Awareness and Self-Regulation in Ensembles of LLMs”
- Proyecto Metacognition Research
- Demo de arquitectura multiagente y asignación de roles
- Paper de The Web Conference 2026