 Capital de Tokens
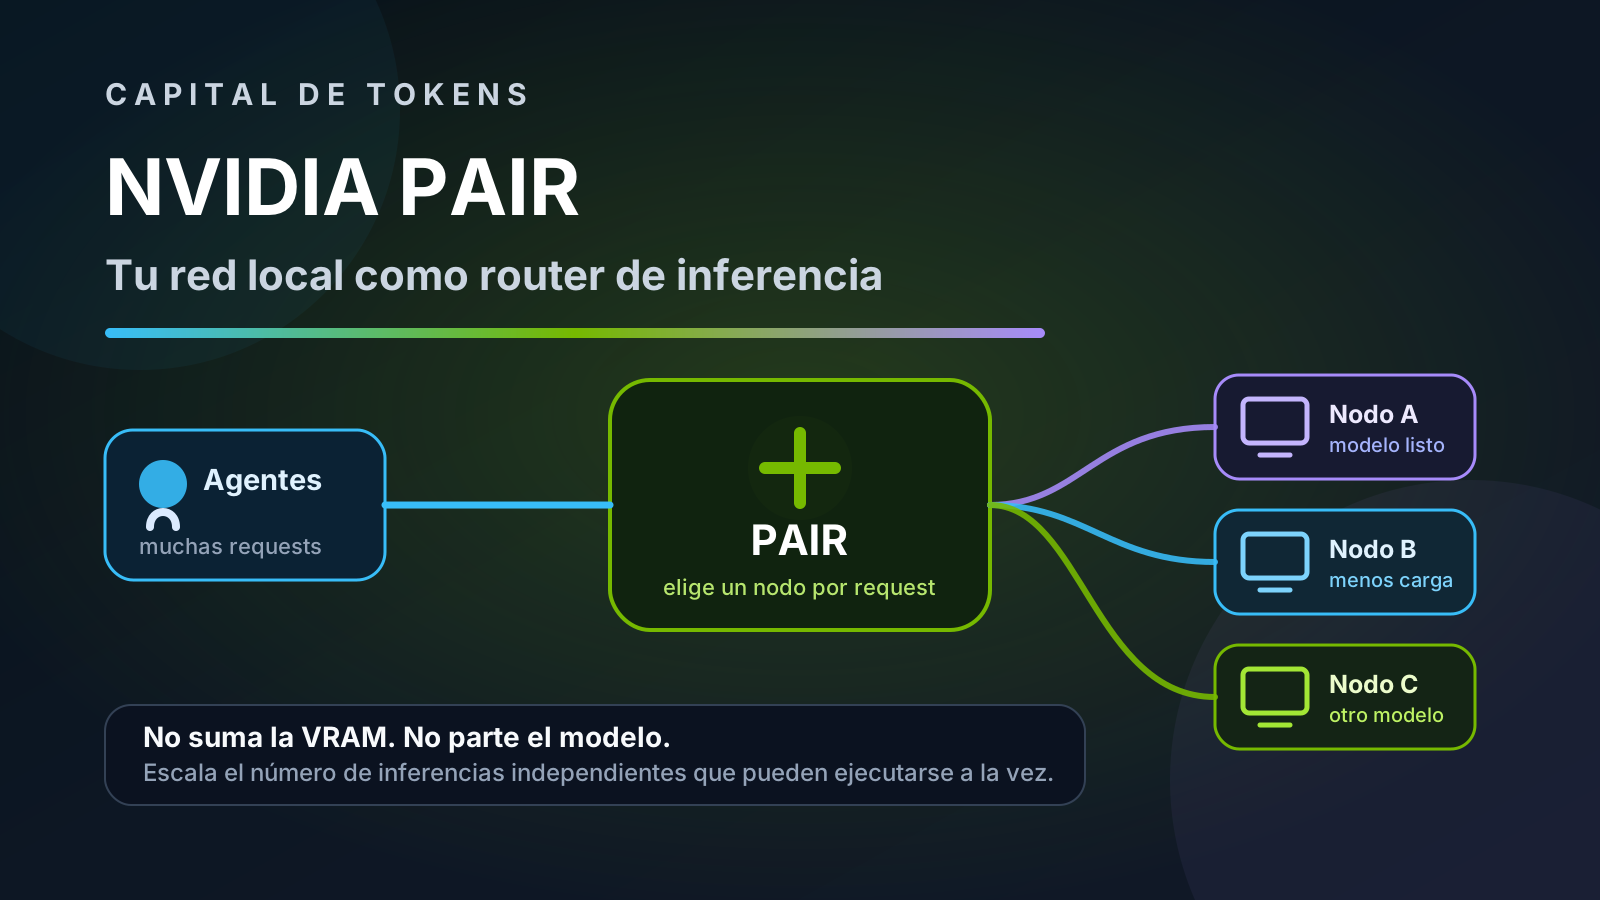
El titular es tentador: NVIDIA quiere convertir los PCs ociosos de tu casa en un pequeño centro de datos personal.
La idea tiene algo de cierto, pero también puede llevar a una interpretación equivocada. NVIDIA PAIR —Personal AI Router— no une varias GPUs para crear una GPU virtual gigantesca, ni reparte un único modelo entre varios equipos.
Lo que hace es más sencillo y, para la próxima generación de agentes, posiblemente más útil: convierte varios ordenadores de una red local en un pool de nodos entre los que puede repartir requests independientes de inferencia.
En otras palabras, PAIR no escala una inferencia individual. Escala cuántas inferencias independientes puedes ejecutar a la vez.
Y esa distinción es precisamente lo que hace interesante al proyecto.
El problema que PAIR intenta resolver
Los sistemas de IA locales suelen empezar con una arquitectura muy simple:
aplicación o agente
        ↓
     Ollama
        ↓
       GPU
Mientras existe una sola conversación o una sola tarea, esta arquitectura funciona bien.
El problema aparece cuando el software se vuelve multiagente.
Un agente principal puede dividir un objetivo en varios subproblemas:
agente principal
   ├── investigador
   ├── programador
   ├── verificador
   ├── crítico
   └── sintetizador
Desde el punto de vista del usuario sigue siendo una sola tarea. Desde el punto de vista de la infraestructura pueden ser decenas de llamadas al modelo compitiendo por la misma GPU.
La cola crece aunque en la misma casa haya otro PC, una workstation o un portátil con capacidad de inferencia disponible.
PAIR intenta resolver exactamente ese cuello de botella.
Según la documentación de NVIDIA, el sistema descubre equipos compatibles de la red local, conoce qué motores y modelos tiene disponibles cada nodo y enruta cada request hacia un nodo elegible.
La aplicación sigue viendo un único endpoint.
                    ┌── PC A → Ollama
agentes → PAIR ─────┼── PC B → Ollama
                    └── PC C → LM Studio
El harness del agente no necesita saber cuál de los tres equipos terminó haciendo la inferencia.
PAIR es un router, no un nuevo motor de inferencia
Este punto es importante.
PAIR no ejecuta los modelos directamente.
Los modelos siguen corriendo dentro de motores compatibles como:
- Ollama
- LM Studio
PAIR se coloca delante de ellos como un proxy y un scheduler.
NVIDIA expone endpoints compatibles con las interfaces que esas herramientas ya utilizan. En la práctica, una aplicación que permite configurar su base_url puede apuntar al proxy local de PAIR sin aprender una API de cluster completamente nueva.
La arquitectura queda así:
aplicación
    ↓
endpoint local
    ↓
proxy PAIR
    ↓
router / scheduler
    ↓
 nodo elegible
    ↓
Ollama o LM Studio
    ↓
   modelo
NVIDIA describe esta separación de responsabilidades de una forma especialmente útil:
- el agente decide qué trabajo quiere hacer;
- PAIR decide dónde debe ejecutarse.
Eso permite introducir distribución física sin reescribir la lógica del agente.
Cómo decide PAIR dónde mandar una petición
Un nodo no participa simplemente por estar encendido.
Para ejecutar una request debe poder satisfacerla.
PAIR mantiene información sobre factores como:
- si el nodo está conectado;
- si existe un motor compatible activo;
- si ese motor tiene el modelo solicitado;
- cuánta carga pendiente tiene el nodo;
- y señales de utilización de la GPU.
La implementación actual todavía es temprana. El propio repositorio de NVIDIA advierte que su política de scheduling no considera todavía señales más sofisticadas como el modelo exacto de GPU, memoria disponible, si el modelo está caliente en memoria o cuánto costará previsiblemente una request.
Eso importa porque PAIR debe entenderse como infraestructura emergente, no como un scheduler maduro de datacenter.
Pero el patrón arquitectónico ya es claro.
Lo que PAIR NO hace
Aquí está la limitación que evita malinterpretar el anuncio.
Supongamos que tienes:
PC A → 12 GB VRAM
PC B → 12 GB VRAM
PC C → 24 GB VRAM
PAIR no crea una GPU virtual de 48 GB.
Tampoco puede tomar un modelo que necesite 40 GB y repartir sus capas automáticamente entre esos tres equipos.
Cada request completa se ejecuta en un solo nodo.
request 1 → PC A
request 2 → PC B
request 3 → PC C
Lo que sí aumenta es la cantidad de trabajo independiente que puede procesarse simultáneamente.
Por eso PAIR encaja mucho mejor con cargas como:
- sistemas multiagente;
- múltiples sesiones simultáneas;
- pipelines con varias llamadas independientes al modelo;
- herramientas de programación que lanzan workers en paralelo;
- asistentes locales usados por varias aplicaciones.
La unidad de escalado es la request, no la GPU.
El demo de NVIDIA: cinco subagentes
NVIDIA mostró el concepto con Hermes Desktop creando un workload de cinco subagentes y Ollama ejecutando el modelo.
En la configuración descrita por la compañía, el mismo workload tardó aproximadamente:
| Configuración | Tiempo medio |
|---|---|
| Un RTX Spark laptop | 18 minutos |
| Cluster PAIR de tres dispositivos | 8 min 48 s |
El cluster estaba formado por un RTX Spark laptop, un DGX Spark y una RTX 5090.
Es una reducción grande del tiempo total, pero NVIDIA deja explícito que se trata de una demostración específica de configuración, no de un benchmark universal ni de una promesa de escalado lineal.
La mejora tampoco significa que cada inferencia sea el doble de rápida.
La explicación es otra:
una GPU
request A ──────────────┐
request B espera        │
request C espera        ├─ cola
request D espera        │
request E espera ───────┘

varios nodos
request A → nodo 1
request B → nodo 2
request C → nodo 3
request D → nodo 1
request E → nodo 2
La ganancia viene del paralelismo del workload.
Una API local que oculta la topología física
Una de las mejores decisiones de PAIR es que intenta mantener invisible la topología del cluster para las aplicaciones.
El programa conecta con un endpoint local como siempre.
Detrás de ese endpoint, PAIR decide qué nodo ejecuta el trabajo.
Esto recuerda a una abstracción clásica de infraestructura distribuida:
cliente
  ↓
endpoint estable
  ↓
router
  ↓
recursos variables
La diferencia es que aquí los recursos no son servidores homogéneos en un rack.
Pueden ser máquinas domésticas que entran y salen del pool:
- un PC gaming que deja de estar disponible mientras alguien juega;
- un portátil que entra en suspensión;
- una workstation que tiene un modelo que otros nodos no poseen;
- un equipo que se apaga por completo.
PAIR está diseñado alrededor de esa elasticidad doméstica.
NVIDIA usa descubrimiento local mediante mDNS y también permite añadir nodos por IP.
Seguridad: local no significa automáticamente seguro
PAIR está pensado para mantener el tráfico de inferencia dentro de la red local cuando todos los componentes utilizados también son locales.
El proceso de pairing requiere una aprobación explícita y un PIN de seis dígitos. Después del emparejamiento, el tráfico entre nodos utiliza mutual TLS (mTLS) con certificados generados para el cluster.
Pero NVIDIA hace una advertencia importante: el PIN es un mecanismo de bootstrap cómodo, no una credencial de alta entropía.
La recomendación es emparejar nodos únicamente en redes y equipos de confianza.
Esto encaja con una regla útil para toda infraestructura de IA local:
“local” reduce la superficie externa, pero no elimina la necesidad de diseñar límites de confianza.
Hardware y sistemas compatibles
En el anuncio de septiembre de 2026, NVIDIA menciona soporte para sistemas compatibles con:
- GeForce RTX 20 Series o posteriores;
- RTX PRO basadas en Turing o posteriores;
- DGX Spark;
- Apple Silicon M4+.
PAIR dispone de builds para Windows, Linux y macOS, además de una interfaz de terminal para sistemas sin entorno gráfico.
Aquí también conviene separar dos conceptos: que PAIR pueda ejecutarse en una máquina no garantiza que un motor y un modelo concretos puedan hacerlo. Ollama, LM Studio, los drivers y el propio modelo mantienen sus requisitos de hardware y memoria.
El detalle más interesante: agentes e infraestructura empiezan a desacoplarse
La lectura más importante de PAIR no es “NVIDIA inventó un datacenter doméstico”.
Es otra.
Los sistemas de agentes empiezan a necesitar una capa de scheduling de inferencia independiente del harness.
Hasta ahora muchos proyectos locales hacen algo parecido a esto:
agent.py
  ↓
http://localhost:11434
El código presupone que existe una máquina concreta detrás de esa URL.
Con un router como PAIR, la relación cambia:
agent.py
  ↓
endpoint estable
  ↓
capacidad disponible de la red
El agente deja de preocuparse por la infraestructura física.
Ese desacoplamiento es el mismo tipo de transformación que ocurrió en otras capas de computación distribuida: las aplicaciones dejan de seleccionar máquinas y delegan esa decisión a una capa especializada.
¿Un Kubernetes doméstico para GPUs?
No exactamente.
PAIR no ofrece la amplitud de un orquestador general como Kubernetes. Tampoco hace distributed training, sharding de modelos ni agregación de memoria GPU.
Una comparación más precisa sería:
un load balancer consciente de modelos y carga para inferencia local.
Esa definición parece menos espectacular que “datacenter en casa”, pero probablemente describe mejor por qué el proyecto importa.
Un futuro con decenas de agentes locales no necesita necesariamente una GPU monstruosa.
Puede necesitar muchas GPUs razonables detrás de un buen scheduler.
El hogar como una pequeña capa de compute
PAIR también apunta a una tendencia más amplia.
Durante años los dispositivos personales fueron tratados como clientes aislados:
PC
laptop
workstation
La IA local crea un incentivo para tratarlos colectivamente:
             capacidad disponible
                     ↓
PC ───────────────┐
laptop ───────────┼──► pool local de inferencia
workstation ──────┘
Eso no convierte literalmente una casa en un datacenter.
Pero sí introduce una idea de datacenter: separar la demanda de computación de la máquina concreta que termina ejecutándola.
Y para workloads agentic, esa abstracción puede ser mucho más importante que intentar sumar VRAM.
Conclusión
NVIDIA PAIR es interesante precisamente por lo que no intenta hacer.
No convierte tres GPUs pequeñas en una grande.
No acelera mágicamente una request individual.
No sustituye a Ollama ni a LM Studio.
Lo que introduce es una capa de routing que permite que varias máquinas de una LAN compartan la carga de inferencias independientes detrás de un endpoint estable.
Para un chatbot tradicional quizá sea una optimización menor.
Para un sistema con cinco, diez o cincuenta agentes lanzando trabajo en paralelo, puede convertirse en una pieza fundamental de infraestructura.
La revolución del “home AI datacenter” probablemente no empiece sumando GPUs.
Puede empezar con algo mucho más mundano:
un buen router.