 Capital de Tokens
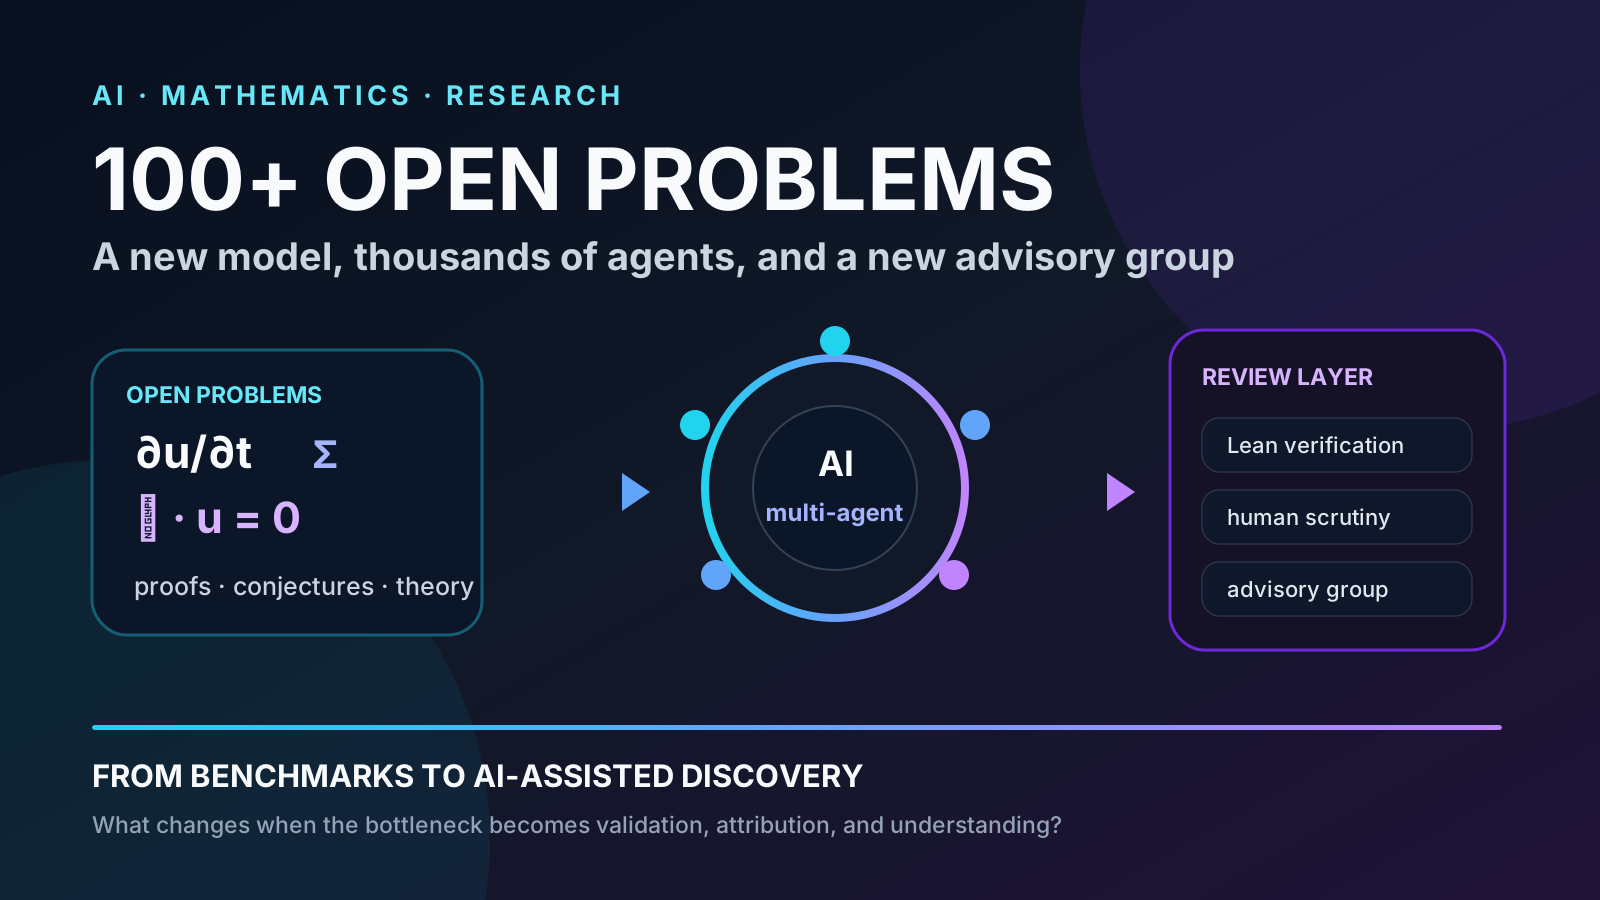
OpenAI acaba de hacer una afirmación extraordinaria: un modelo interno que comenzó a entrenarse el 28 de agosto de 2026 habría resuelto más de 100 problemas abiertos de larga duración en distintas áreas de las matemáticas.
La compañía no publicó todavía la lista completa de esos problemas.
Sí publicó, en cambio, una señal muy concreta de por qué está tomando el asunto en serio: la creación del Advisory Group on Mathematics and Artificial Intelligence, un grupo independiente de nueve matemáticos alojado en el Institute for Advanced Study de Princeton.
La noticia puede resumirse como “una IA resolvió 100 problemas”.
Pero lo interesante está debajo.
Estamos viendo un cambio en la arquitectura de la investigación asistida por IA:
problema abierto
      ↓
miles de agentes
      ↓
exploración paralela
      ↓
consolidación de ideas
      ↓
prueba matemática
      ↓
formalización / verificación
      ↓
revisión humana
      ↓
publicación
Si este patrón escala, el cuello de botella puede dejar de ser únicamente encontrar una demostración.
Puede pasar a ser verificarla, entenderla, atribuir correctamente las ideas y decidir cómo incorporarla al conocimiento humano.
Qué anunció exactamente OpenAI
El 21 de septiembre OpenAI publicó que el nuevo modelo interno que entrena desde el 28 de agosto:
ha resuelto más de 100 problemas abiertos de larga duración en la mayoría de las áreas de las matemáticas.
La propia compañía añade que el ritmo sorprendió incluso a sus matemáticos internos.
Hay que leer esa frase con precisión.
A fecha de publicación de este artículo, OpenAI no ha publicado la lista completa de los 100+ resultados ni todos sus manuscritos. Por tanto, no es correcto tratarlos todavía como 100 teoremas independientemente aceptados por la comunidad.
Lo verificable hoy es que OpenAI hace esa afirmación y que el grupo asesor independiente dice estar enfrentando específicamente el problema de cómo coordinar la publicación de “un gran número de resultados significativos” que OpenAI reporta haber obtenido con su modelo interno.
Eso ya es una señal importante.
El precedente: Navier–Stokes
La pieza de evidencia pública más espectacular apareció el 8 de septiembre.
OpenAI publicó una propuesta de solución al problema de existencia y regularidad de Navier–Stokes, uno de los siete Millennium Prize Problems del Clay Mathematics Institute.
Según OpenAI, su sistema encontró una construcción en la que una solución inicialmente suave desarrolla una singularidad en tiempo finito. La compañía publicó dos cosas:
- una demostración analítica;
- una formalización de la prueba en Lean.
Ese segundo punto importa mucho.
Lean es un asistente de demostración capaz de verificar de forma mecánica que una secuencia formal de pasos se deriva correctamente de los axiomas, definiciones y resultados disponibles.
No convierte automáticamente una investigación en verdad científica definitiva.
Pero sí cambia radicalmente la naturaleza de la comprobación.
Un texto generado por un LLM puede sonar convincente y contener un error escondido.
Una prueba formal correctamente verificada obliga a que una parte mucho mayor del argumento quede expresada con precisión suficiente para que una máquina la compruebe.
Cómo llegó OpenAI a Navier–Stokes
Los detalles operativos son quizá más importantes que el propio titular.
OpenAI dice que no se trató simplemente de preguntarle a un chatbot:
“Resuelve Navier–Stokes.”
La compañía desplegó un sistema coordinado de agentes.
Los agentes podían consultar una copia almacenada de Internet, ejecutar código y comunicarse dentro de grupos. Para Navier–Stokes, OpenAI afirma que el grupo que produjo la solución tuvo del orden de 10.000 agentes concurrentes.
También probaron variantes diferentes del problema en paralelo.
La secuencia descrita por OpenAI fue aproximadamente:
Millennium Problems + problemas relacionados
                  ↓
        múltiples grupos de agentes
                  ↓
     exploración de rutas distintas
                  ↓
       avance previo en Euler
                  ↓
reasignación de agentes a Navier–Stokes
                  ↓
 Codex consolida ideas prometedoras
                  ↓
            nueva búsqueda
                  ↓
              solución
OpenAI afirma que los agentes llegaron al resultado de Navier–Stokes aproximadamente 88 horas después de iniciar la búsqueda.
La formalización y verificación en Lean tomó otras 17 horas, utilizando GPT-6 Astra.
La escala computacional fue enorme
Aquí aparece una diferencia importante entre “un modelo es bueno en matemáticas” y “un sistema de IA puede hacer investigación”.
OpenAI reporta que, sumando los problemas intentados, los agentes intercambiaron alrededor de 4,9 millones de mensajes y produjeron aproximadamente 300.000 millones de tokens de salida.
Solo el esfuerzo relacionado con Navier–Stokes habría utilizado:
- unos 2,7 millones de mensajes;
- aproximadamente 130.000 millones de tokens de salida.
Esto se parece menos a una conversación con ChatGPT y más a una infraestructura de cómputo dedicada a investigación.
Podemos pensar en ella como una especie de laboratorio digital:
             coordinador
                 │
      ┌──────────┼──────────┐
      ▼          ▼          ▼
   agente A   agente B   agente C
      │          │          │
 hipótesis    cálculo     literatura
      │          │          │
      └─────► síntesis ◄────┘
                 │
                 ▼
         nuevas iteraciones
                 │
                 ▼
              prueba
El modelo individual importa.
Pero también importa el harness: coordinación, herramientas, memoria, paralelismo, selección de rutas y consolidación de resultados.
Es la misma lección que estamos viendo en ingeniería de software con agentes: mejorar el modelo no es la única forma de aumentar capacidad. Mejorar el sistema alrededor del modelo puede multiplicar lo que este consigue hacer.
Entonces, ¿Navier–Stokes está oficialmente resuelto?
Todavía no en el sentido institucional del Millennium Prize.
El Clay Mathematics Institute establece condiciones específicas antes de considerar una solución para el premio:
- debe publicarse en un medio que cumpla sus criterios;
- deben pasar al menos dos años desde esa publicación;
- la solución debe haber alcanzado aceptación general en la comunidad matemática mundial.
Además, OpenAI declaró expresamente que no pretende reclamar el Millennium Prize con este resultado.
Por eso es mejor hablar de una solución propuesta por OpenAI y acompañada por una formalización en Lean, no de un premio oficialmente adjudicado.
La diferencia no reduce lo interesante del resultado.
Simplemente separa el anuncio de una compañía del proceso normal de aceptación matemática.
El problema nuevo: producir resultados puede ser más rápido que absorberlos
Aquí aparece el motivo del nuevo grupo asesor.
Si un laboratorio puede generar un resultado importante ocasionalmente, la comunidad matemática puede revisarlo usando mecanismos conocidos.
Pero ¿qué ocurre si un sistema produce decenas o cientos?
La revisión humana no escala automáticamente.
capacidad de generación
        ████████████████████

capacidad de revisión humana
        ████
Cada resultado importante requiere trabajo que no desaparece porque la IA haya producido una prueba:
- verificar el argumento;
- entender qué idea es realmente nueva;
- compararlo con la literatura existente;
- identificar trabajo previo relevante;
- asignar crédito;
- simplificar la demostración;
- extraer métodos reutilizables;
- enseñarla;
- conectar el resultado con otras áreas.
Encontrar una prueba es una parte de la investigación matemática.
Convertir esa prueba en conocimiento compartido es otra.
El grupo asesor no pertenece a OpenAI
Este detalle merece atención.
OpenAI inicialmente contactó a algunos matemáticos para establecer un consejo externo.
Según el propio grupo, en acuerdo con OpenAI decidieron crear en su lugar una organización independiente de cualquier compañía de IA.
El grupo está alojado en el Institute for Advanced Study y sus nueve miembros iniciales son:
- François Charles;
- Camillo De Lellis;
- Timothy Gowers;
- Martin Hairer;
- Nikhil Srivastava;
- Ulrike Tillmann;
- Ravi Vakil;
- Edward Witten;
- Melanie Matchett Wood.
Sus miembros no reciben pago de OpenAI por este trabajo.
El grupo dice que podrá:
- aconsejar a OpenAI y a otras compañías;
- publicar sus recomendaciones;
- hacer recomendaciones incluso cuando una empresa no las solicite;
- comentar públicamente sobre el impacto de estas compañías en las matemáticas.
Pero hay un límite fundamental.
No tiene poder de decisión sobre OpenAI.
Tampoco tiene como función indicarle a la empresa a qué velocidad debe avanzar internamente.
Es un mecanismo de asesoría, no un regulador.
Por qué apareció ahora
El contexto importa.
Durante 2026 se ha intensificado el debate entre laboratorios de IA y matemáticos sobre qué significa usar problemas abiertos como benchmark.
En junio se publicó la Leiden Declaration on Artificial Intelligence and Mathematics, una iniciativa comunitaria respaldada por la International Mathematical Union. La declaración insiste en valores como verificabilidad, atribución, autonomía de la comunidad y preservación de la comprensión humana.
Después, el 11 de septiembre, 25 ganadores de la Medalla Fields, entre ellos Terence Tao, publicaron una carta titulada A Severe Misalignment of AI in Mathematics.
La crítica no consiste simplemente en decir “la IA no debería hacer matemáticas”.
El argumento es más interesante.
Los firmantes cuestionan que resolver problemas famosos se convierta en un benchmark competitivo para empresas de IA cuando el objetivo de la matemática como disciplina incluye cosas que un benchmark no mide bien:
- comprensión conceptual;
- creación de nuevos lenguajes y métodos;
- transmisión de ideas;
- formación de estudiantes;
- reconocimiento del trabajo previo.
También señalan problemas potenciales de atribución cuando un resultado se anuncia con extrema rapidez.
OpenAI cita expresamente esa carta en el anuncio del nuevo grupo asesor.
Por tanto, el consejo no aparece únicamente por el éxito técnico.
Aparece también porque la velocidad técnica está chocando con las instituciones que validan y transmiten conocimiento.
No todos los matemáticos interpretan el cambio igual
También hay una respuesta diferente dentro de la comunidad.
Algunos investigadores sostienen que las herramientas de IA pueden convertirse simplemente en la próxima extensión de una historia larga de mecanización matemática.
La matemática ya incorporó:
- cálculo simbólico;
- pruebas asistidas por computadora;
- búsqueda exhaustiva;
- software algebraico;
- verificadores formales.
Desde esa perspectiva, el hecho de que una prueba exceda lo que una sola persona puede descubrir o revisar manualmente no sería completamente nuevo.
El verdadero problema sería construir instituciones capaces de mantener:
- trazabilidad;
- verificación;
- atribución;
- acceso;
- comprensión.
Esa diferencia de enfoque es importante.
El debate no es simplemente:
humanos vs. IAPuede ser más útil verlo así:
generación extremadamente rápida
            vs.
instituciones diseñadas para un ritmo humano
Lean puede convertirse en infraestructura científica
La formalización de Navier–Stokes apunta a otra consecuencia.
Si los modelos empiezan a producir matemática a una escala superior a la capacidad de revisión manual, los proof assistants pueden dejar de ser una herramienta especializada y convertirse en infraestructura central.
El pipeline podría parecerse cada vez más a:
conjetura
   ↓
exploración con agentes
   ↓
prueba informal
   ↓
formalización automática
   ↓
kernel de verificación
   ↓
revisión conceptual humana
Eso separa dos preguntas que durante mucho tiempo estuvieron muy unidas:
- ¿Es formalmente correcto el argumento?
- ¿Lo entendemos y sabemos por qué importa?
La primera puede automatizarse en gran medida.
La segunda sigue siendo una cuestión científica y humana mucho más rica.
De los benchmarks a la investigación
En agosto OpenAI ya había publicado una selección de diez avances en matemáticas e informática teórica, cada uno resolviendo o avanzando problemas abiertos.
El salto a “más de 100” apenas unas semanas después, si resiste revisión independiente, sugiere que estamos dejando atrás una fase donde medíamos modelos principalmente con exámenes.
Los benchmarks clásicos preguntan:
¿puede resolver este problema cuya respuesta ya conocemos?La investigación pregunta:
¿puede producir conocimiento que todavía no teníamos?Ese cambio es enorme.
Una puntuación alta en una olimpiada demuestra capacidad.
Una contribución correcta a un problema abierto demuestra algo diferente: que el sistema puede entrar en un proceso de descubrimiento donde no existe una solución de referencia disponible para comprobar fácilmente el resultado.
La conexión con los agentes de software
Para quienes construimos sistemas agentic, esta historia también deja una lección de arquitectura.
El protagonista no parece ser únicamente un modelo gigantesco.
Es una combinación:
modelo
 +
muchos agentes
 +
herramientas
 +
paralelismo
 +
coordinación
 +
síntesis
 +
verificación
Ese patrón se puede reconocer en muchos dominios.
En desarrollo de software:
issue
 ↓
agentes exploran
 ↓
implementaciones
 ↓
tests
 ↓
review
 ↓
merge
En investigación matemática:
problema
 ↓
agentes exploran
 ↓
demostraciones candidatas
 ↓
formalización
 ↓
review
 ↓
publicación
La diferencia fundamental está en la naturaleza de la validación.
En software podemos tener tests ejecutables.
En matemáticas podemos tener proof assistants como Lean.
En ambos casos, el sistema se vuelve mucho más poderoso cuando generación y verificación están separadas.
Lo más importante todavía no es el número 100
“100+ problemas abiertos” es un titular impresionante.
Pero el número por sí solo dice poco sin conocer:
- cuáles son exactamente los problemas;
- qué tan importantes son;
- cuántos están completamente resueltos;
- cuáles son avances parciales;
- cuánto trabajo humano se necesitó;
- qué literatura utilizó el sistema;
- cuántos sobrevivirán revisión independiente.
Por eso el siguiente paso interesante no será otro número más grande.
Será observar el proceso de publicación.
Si OpenAI y el grupo asesor consiguen liberar los resultados con trazabilidad, revisión y suficiente contexto para que otros matemáticos puedan absorberlos, podríamos estar viendo el nacimiento de una nueva forma de investigación a escala.
Si no, también podríamos descubrir un límite inesperado:
la IA puede generar descubrimientos más rápido de lo que la ciencia puede convertirlos en conocimiento.
Ese cuello de botella quizá sea uno de los problemas más interesantes que dejan estos 100+ problemas.
Fuentes
- OpenAI — Advisory Group on Mathematics and Artificial Intelligence
- Advisory Group on Mathematics and Artificial Intelligence — sitio independiente
- Institute for Advanced Study — Advisory Group on Mathematics and Artificial Intelligence
- OpenAI — On the Navier–Stokes Millennium Prize Problem
- Clay Mathematics Institute — Rules for the Millennium Prize Problems
- Clay Mathematics Institute — Navier-Stokes Announcement
- OpenAI — Ten advances in mathematics and theoretical computer science
- Leiden Declaration on Artificial Intelligence and Mathematics
- Terence Tao — A Severe Misalignment of AI in Mathematics
- TechCrunch — OpenAI forms math advisory group as its AI resolves more than 100 open problems