 Capital de Tokens
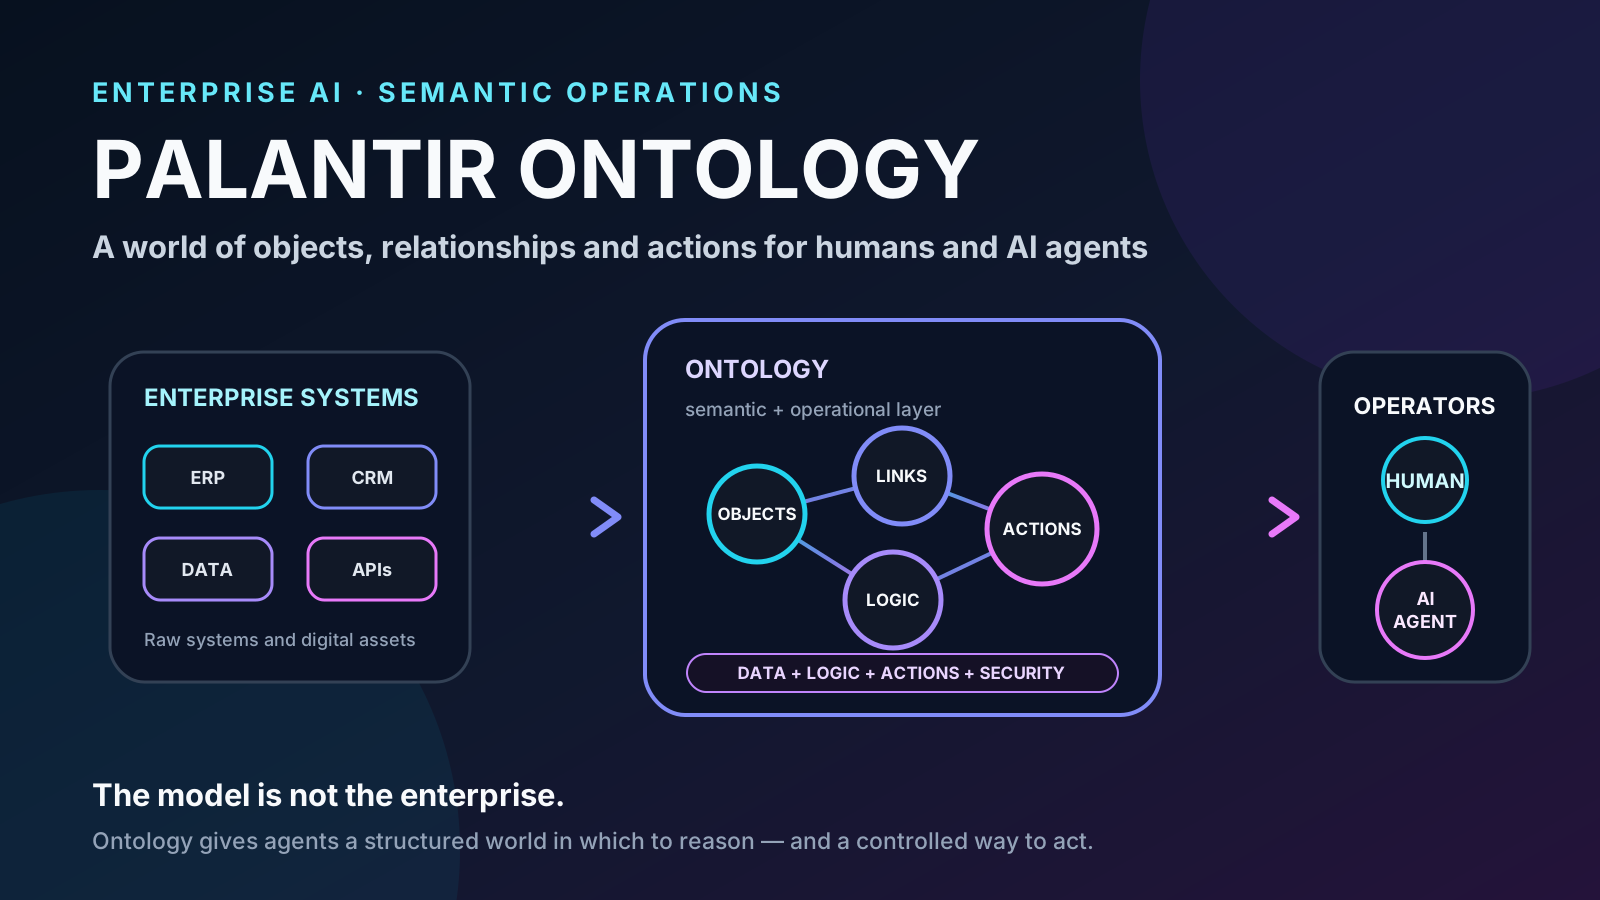
Cuando hablamos de agentes de IA dentro de una empresa, solemos pensar primero en el modelo.
¿GPT? ¿Claude? ¿Gemini? ¿Un modelo propietario?
Pero en organizaciones grandes aparece rápidamente otro problema: el modelo puede razonar muy bien y aun así no entender cómo funciona la compañía.
Puede ver tablas, APIs, documentos, dashboards y tickets, pero eso no significa que sepa automáticamente qué representa cada dato, cómo se relaciona con el resto o qué acciones están permitidas.
Ese es precisamente el problema que Palantir intenta resolver con Ontology.
La idea central es convertir los activos digitales de una organización en una representación coherente de su mundo operacional: objetos, propiedades, relaciones, lógica y acciones que pueden ser utilizadas tanto por personas como por aplicaciones y agentes de IA.
Palantir describe la Ontology como un digital twin de la organización y, en su arquitectura más reciente, como una capa que integra datos, lógica, acciones y políticas de seguridad en una representación utilizable por humanos y agentes.
Fuentes oficiales:
El problema de darle una base de datos a un agente
Imagina una empresa de transporte.
En sus sistemas podrían existir tablas como:
customers
drivers
vehicles
trips
maintenance_records
incidents
Para una base de datos eso es suficiente.
Para operar el negocio, no.
Una persona entiende conceptos como:
Driver
  └── drives → Vehicle
               └── has → Maintenance Record

Trip
  ├── requested_by → Customer
  ├── assigned_to → Driver
  └── uses → Vehicle
Y además entiende que sobre esos objetos existen operaciones reales:
AssignDriver()
CancelTrip()
ScheduleMaintenance()
EscalateIncident()
Un LLM conectado directamente a datos crudos tendría que reconstruir buena parte de ese significado.
Tendría que descubrir qué tabla corresponde a qué concepto, qué columnas son importantes, cómo se hacen los joins, qué sistema contiene la información actualizada, qué API modifica el estado y qué permisos debe respetar.
Ontology intenta mover todo ese conocimiento fuera del prompt y convertirlo en infraestructura persistente.
Objects, properties, links y actions
Palantir estructura la Ontology alrededor de varios conceptos básicos.
Un Object Type representa una entidad o evento del mundo real: un avión, una fábrica, un pedido, un empleado o una transacción.
Un Object es una instancia concreta de ese tipo.
Las Properties describen sus características.
Los Links representan relaciones entre objetos.
Y las Actions describen cambios que pueden ejecutarse sobre esos objetos.
Palantir muestra una analogía bastante útil con las bases de datos:
Dataset      → Object Type
Row          → Object
Column       → Property
Field value  → Property value
Join         → Link
Pero la diferencia importante aparece cuando añadimos las acciones.
Una Ontology no solo dice:
este vehículo pertenece a esta flota.
También puede representar que existe una operación autorizada para:
reasignar el vehículo, programar mantenimiento o modificar determinado estado.
Ahí deja de ser solamente una capa descriptiva.
Se convierte en una capa operacional.
Fuente: Palantir — Core concepts
Por qué no es simplemente un Knowledge Graph
A primera vista, Ontology se parece mucho a un Knowledge Graph.
Y existe una razón evidente: ambos representan entidades y relaciones.
Pero reducir Ontology a un grafo de conocimiento deja fuera una parte importante de su diseño.
Un Knowledge Graph clásico puede representar:
Factory A
  ├── produces → Product X
  └── located_in → Ohio
Eso describe conocimiento.
La Ontology de Palantir también pretende representar qué puede hacerse con ese conocimiento.
Por ejemplo:
Factory
  ├── ChangeProductionPlan()
  ├── ReallocateInventory()
  └── RunSupplySimulation()
Palantir describe esta distinción usando una metáfora sencilla: nouns + verbs.
Los objetos son los sustantivos de la organización.
Las acciones son los verbos.
Y alrededor de ellos pueden existir reglas de negocio, modelos de machine learning, optimizadores, funciones y controles de seguridad.
En otras palabras:
Knowledge Graph
≈ entities + relationships

Palantir Ontology
≈ entities + relationships
  + business logic
  + actions
  + permissions
  + operational workflows
No significa que todos los Knowledge Graphs sean puramente pasivos ni que Ontology sea la única arquitectura capaz de añadir operaciones. La diferencia relevante está en que Palantir diseña explícitamente esa combinación como el núcleo de su plataforma.
Fuente: Palantir — Architecture Center
La idea más importante para los agentes de IA
Aquí es donde Ontology se vuelve especialmente interesante en 2026.
Un patrón común de agentes empresariales puede representarse así:
LLM
 + prompt
 + tools
 + RAG
El modelo recibe una tarea, busca documentos, consulta bases de datos y utiliza herramientas.
Pero a medida que aumenta el número de sistemas, el agente necesita entender cada vez más detalles sobre la organización.
¿Qué herramienta contiene los pedidos?
¿Qué servicio es la fuente de verdad?
¿Qué significa exactamente “cliente activo”?
¿Qué relación existe entre una orden y una línea de producción?
¿Qué operación puede modificar un pedido?
¿Qué usuario está autorizado para ejecutarla?
Sin una capa adicional, gran parte de ese conocimiento termina disperso entre prompts, documentación, código de herramientas y reglas escritas a mano.
Ontology propone algo diferente:
Enterprise systems
        ↓
Data + models + business logic
        ↓
────────────────────────────
        ONTOLOGY
────────────────────────────
Objects + Links + Actions + Security
        ↓
Apps + Automations + AI Agents
El agente ya no tiene que aprender la empresa exclusivamente mediante documentación.
Puede operar contra una representación del negocio diseñada explícitamente para reflejar cómo funciona la organización.
De APIs técnicas a una API semántica del negocio
Una forma útil de entender Ontology es imaginarla como una API semántica de la empresa.
Una API tradicional podría exponer algo como:
POST /api/v2/maintenance/work-ordersPara usarla correctamente, el agente necesita saber:
- qué endpoint llamar;
- qué identificadores enviar;
- qué campos son obligatorios;
- qué sistema contiene el vehículo;
- qué reglas permiten crear la orden;
- qué efectos secundarios produce.
En una capa semántica el agente podría razonar en términos más cercanos al negocio:
Vehicle
  → ScheduleMaintenance()
Debajo pueden seguir existiendo APIs, bases de datos, sistemas ERP, funciones y workflows.
La diferencia es que el agente trabaja con una abstracción más estable y comprensible.
Ese desacoplamiento puede ser especialmente importante para agentes de larga duración, porque reduce la cantidad de conocimiento accidental sobre infraestructura que debe vivir dentro de prompts y skills.
Data + Logic + Actions
Palantir resume buena parte de su arquitectura alrededor de tres componentes:
Data: cuáles son los hechos relevantes.
Logic: qué reglas, modelos, predicciones u optimizadores deben aplicarse.
Actions: cómo una decisión produce un cambio real en sistemas de producción.
Ese último componente es crítico.
Muchos sistemas de IA empresariales funcionan bien para responder preguntas:
¿Qué órdenes están retrasadas?
Un sistema operacional intenta llegar al siguiente nivel:
Identifica las órdenes retrasadas, determina qué inventario puede reasignarse y ejecuta el cambio siguiendo las reglas autorizadas.
La distancia entre esas dos frases es enorme.
La primera requiere acceso a información.
La segunda requiere estado, reglas, acciones, permisos y trazabilidad.
Eso es precisamente el territorio donde Palantir posiciona Ontology.
Fuente: Palantir — Platform overview
Seguridad como parte del modelo
Permitir que un agente consulte información es una cosa.
Permitirle modificar operaciones reales es otra completamente distinta.
Por eso la Ontology también incorpora controles de acceso sobre recursos como object types, link types y action types, además de permisos sobre los propios objetos y relaciones.
Palantir presenta la seguridad como parte integral de esta capa, no como una característica añadida después.
Eso importa porque un agente puede necesitar ver un objeto sin tener autorización para ejecutar todas las acciones disponibles sobre él.
El objetivo no es simplemente:
Agent → Toolsino algo más parecido a:
Agent
  ↓
Ontology
  ↓
Objects + Actions
  ↓
Authorization / policy
  ↓
Operational systems
Fuente: Palantir — Object permissioning
Qué tiene que ver esto con Context Engineering
El concepto conecta directamente con una tendencia más amplia: Context Engineering.
Recientemente vimos cómo Uber construyó un AI Context Graph con millones de nodos y relaciones para evitar que sus agentes tengan que explorar a ciegas los sistemas internos.
El principio es parecido:
una parte importante del rendimiento de un agente depende de cómo está estructurado el mundo que puede consultar.
Pero Ontology lleva el concepto un paso más hacia la operación.
Un Context Graph puede ayudar al agente a responder:
¿qué servicio mantiene este dataset?
Una Ontology operacional busca además darle una forma controlada de expresar:
realiza esta acción sobre este objeto respetando estas reglas.
Es la diferencia entre comprender el contexto y actuar dentro de él.
Ontology no elimina los problemas de los datos
Hay una advertencia importante.
Crear una Ontology no convierte automáticamente datos malos en datos buenos.
Si las fuentes están desactualizadas, las relaciones están mal modeladas o las definiciones del negocio son ambiguas, el agente seguirá trabajando con una representación defectuosa.
También aparece un costo organizacional.
Alguien debe decidir:
- qué objetos representan realmente el negocio;
- qué relaciones son importantes;
- qué sistema es la fuente de verdad;
- qué acciones deben existir;
- qué reglas y permisos las controlan;
- cómo evoluciona el modelo cuando cambia la organización.
Por eso el valor no está únicamente en la tecnología.
Está también en realizar correctamente el trabajo de modelar la organización.
La infraestructura puede importar tanto como el modelo
Durante la primera etapa de la IA generativa la pregunta dominante fue:
¿qué modelo usamos?
En sistemas agentic empresariales la pregunta empieza a ampliarse:
¿qué mundo le estamos dando al modelo para que pueda razonar y actuar?
Un modelo más potente puede mejorar el razonamiento.
Pero si cada ejecución debe volver a descubrir qué significa cada tabla, quién posee cada sistema, qué reglas existen y cómo se ejecuta una operación, una parte enorme de esa inteligencia se desperdicia reconstruyendo contexto.
Palantir Ontology representa una respuesta muy concreta a ese problema:
convertir la empresa en un conjunto de objetos, relaciones, lógica y acciones que puedan ser entendidos y utilizados por software y agentes.
Quizá la arquitectura de los agentes empresariales termine pareciéndose menos a:
LLM + toolsy más a:
LLM
  ↓
semantic / operational layer
  ↓
enterprise systems
Si esa dirección se consolida, una de las ventajas competitivas más importantes no será solamente tener acceso al mejor modelo.
Será haber construido una representación correcta del mundo en el que ese modelo debe operar.