 Capital de Tokens
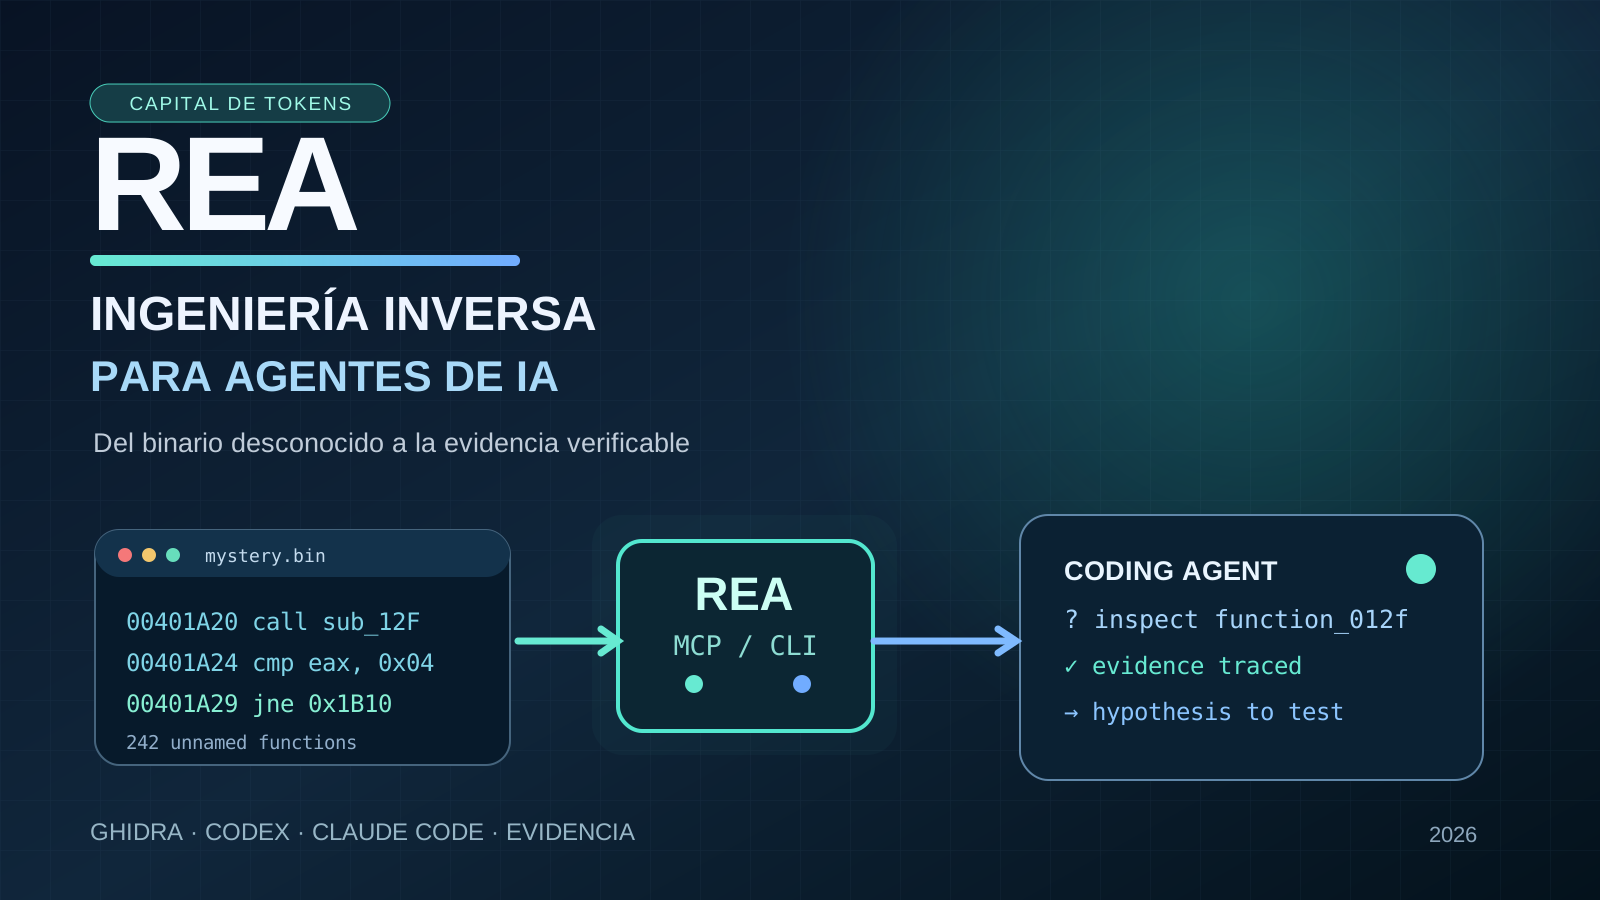
¿Qué sucede cuando un agente de programación necesita entender una aplicación, pero no tiene el repositorio ni el código fuente?
Hasta ahora, el procedimiento habitual requería a alguien con experiencia en desensambladores, depuradores y descompiladores. Esa persona examinaba el binario, identificaba funciones, seguía llamadas y contrastaba hipótesis. Las herramientas siguen siendo indispensables, pero REA (Reverse Engineer Anything) propone cambiar quién coordina la investigación.
REA es un proyecto abierto que conecta agentes como Codex, Claude Code o Cursor con herramientas de ingeniería inversa, usando una interfaz de línea de comandos y MCP (Model Context Protocol). El agente no adivina mágicamente el código perdido: consulta artefactos técnicos, interpreta sus resultados, identifica lagunas y decide qué investigar a continuación.
La distinción importa: un agente con acceso a evidencias no es lo mismo que un modelo que improvisa una explicación convincente.
El punto de partida de este artículo es el video de Jorge Marfil sobre REA, publicado el 13 de octubre de 2026. Contrastamos la descripción de la demostración con la documentación oficial del proyecto.
De leer código a investigar ejecutables
Un agente tradicional trabaja sobre un repositorio: abre archivos, busca símbolos, ejecuta tests y propone cambios. Pero, cuando solo tenemos una aplicación compilada, esas operaciones no bastan.
Un flujo con REA se parece a esto:
Pregunta: «¿Cómo funciona esta característica?»
                     |
                     v
         Agente (Codex / Claude)
                     |
                     v
             MCP / CLI de REA
                     |
           +---------+---------+
           |                   |
       Ghidra / IDA / Hopper   Análisis JS / Electron
           |                   |
           +---------+---------+
                     |
                     v
   Pseudocódigo, llamadas, cadenas, imports,
     referencias y evidencias del artefacto
                     |
                     v
      Hipótesis -> nueva inspección -> prueba
REA actúa como capa de integración y orquestación. Para analizar binarios nativos en profundidad necesita herramientas especializadas como Ghidra, Hopper o IDA. Para inspección estática de JavaScript y Electron tiene otros mecanismos y requisitos. Su catálogo también documenta análisis de ensamblados .NET, paquetes Android, firmware, capturas y otros formatos, pero no todas las capacidades están disponibles con una instalación mínima.
La diferencia frente a pedirle a un LLM «explícame este ejecutable» es que el agente puede anclar afirmaciones a funciones, instrucciones y relaciones observadas, además de reconocer cuándo no hay suficiente evidencia.
La demostración: una caja fuerte y 242 funciones sin nombre
Uno de los momentos centrales del video utiliza una aplicación de caja fuerte preparada por el propio presentador. Se retira el acceso al código fuente y se eliminan los nombres de 242 funciones; el desafío consiste en localizar la lógica que determina el código de desbloqueo.
¿Por qué es un ejemplo interesante?
Porque el agente no puede buscar una función llamada validar_contrasena y dar el trabajo por concluido. Necesita seguir referencias, entradas, comparaciones y rutas relevantes, apoyándose en resultados de Ghidra y REA.
La lección no es que una caja fuerte real o cualquier aplicación compleja sea trivial de analizar. Es que el agente puede contribuir al trabajo investigativo cuando los nombres y la estructura original ya no están disponibles.
El experimento es controlado: no mide, por sí solo, la fiabilidad de REA frente a protecciones sofisticadas, código ofuscado, dependencias externas o comportamientos que solo aparecen en ejecución. Tampoco permite deducir que el proyecto reconstituye el fuente original.
Descompilar no significa recuperar el proyecto
Conviene separar tres resultados que suelen confundirse:
| Resultado | Qué ofrece | Qué no garantiza |
|---|---|---|
| Desensamblado | Instrucciones de máquina interpretadas | Nombres o intención original |
| Pseudocódigo | Representación más legible de determinadas funciones | Código fuente exacto, comentarios o arquitectura original |
| Reconstrucción funcional | Nueva implementación inspirada en el comportamiento observado | Identidad de código, equivalencia completa o licencia para copiar |
Un binario compilado pierde información. La descompilación puede recuperar relaciones útiles, pero no inventar con certeza nombres, comentarios y decisiones de diseño que desaparecieron durante la compilación.
Por eso la afirmación correcta es «investigar y reconstruir comportamientos con evidencias», no «clonar cualquier aplicación con un prompt».
¿Para qué puede servir en el trabajo real?
1. Software heredado. Analizar una utilidad antigua cuyo equipo original y código fuente ya no están disponibles, para documentar formatos y comportamientos.
2. Interoperabilidad. Comprender interfaces o estructuras observables cuando hay una necesidad legítima de compatibilidad, con la debida revisión legal y técnica.
3. Investigación de seguridad. Inspeccionar programas propios, artefactos sospechosos o componentes autorizados; localizar rutas de ejecución y verificar hipótesis.
4. Migración o sustitución de funcionalidades. Estudiar cómo responde una función y diseñar una implementación nueva con sus propias pruebas, sin confundir similitud funcional con copia literal.
5. Análisis de aplicaciones de escritorio. Examinar módulos, imports y relaciones de IPC en aplicaciones JavaScript/Electron, en los escenarios compatibles con las herramientas.
Un beneficio especialmente valioso es reducir el costo de exploración. El especialista deja de dedicar todo su tiempo a abrir funciones sin contexto y puede revisar preguntas, trazas y evidencias priorizadas por el agente.
Cómo empezar sin confundir capacidades con garantías
El repositorio ofrece una configuración inicial para agentes compatibles:
npx rea-agents setupEste comando requiere un entorno Node.js compatible y modifica la configuración del agente seleccionado, por lo que conviene revisar los cambios y el paquete oficial antes de aprobarlos. Después, se reinicia el cliente correspondiente. Los motores para análisis nativo profundo deben instalarse o configurarse por separado según el proveedor.
La recomendación práctica es empezar por una aplicación de laboratorio propia, documentar una pregunta concreta y exigir al agente un informe reproducible:
- Qué artefacto analizó y con qué herramientas/versiones.
- Qué funciones, direcciones o módulos respaldan cada afirmación.
- Qué parte observó directamente y cuál es una inferencia.
- Qué casos siguen sin demostrar y cómo podrían verificarse.
- Qué tests contrastan la reconstrucción con el comportamiento real.
Sin este contrato de evidencia, solo habremos convertido una investigación técnica en una narración automática.
El lado delicado: seguridad, datos y permisos
REA dice que analiza el objetivo localmente, pero eso no significa que todo el proceso permanezca aislado: los resultados que recibe el agente pueden enviarse al proveedor del modelo bajo sus políticas de tratamiento de datos.
También hay otra frontera de confianza. Un programa desconocido, una página o una captura pueden contener contenido controlado por terceros. Si el agente interpreta datos del objetivo como instrucciones, aparece un riesgo de prompt injection indirecta. La defensa no es confiar ciegamente en el modelo, sino diseñar el entorno:
- usar artefactos propios o con autorización;
- aislar análisis dinámicos y minimizar permisos;
- evitar exponer secretos y credenciales al agente;
- tratar el contenido extraído como datos, no como órdenes;
- revisar salidas antes de ejecutar código derivado;
- respetar licencias de herramientas y condiciones de uso del software analizado.
La licencia MIT del código de REA no concede automáticamente derechos de uso de herramientas comerciales ni del software de terceros.
Conclusión: una nueva interfaz para una disciplina antigua
REA no inventa la ingeniería inversa, ni sustituye a Ghidra ni elimina la necesidad del análisis experto. Lo que aporta es una interfaz agéntica entre una pregunta humana y las herramientas que generan evidencia.
Eso abre una posibilidad poderosa: que un agente de desarrollo no solo escriba código a partir de especificaciones, sino que investigue cómo se comporta un sistema existente y someta sus hipótesis a comprobación.
El salto de calidad no estará en afirmar «la IA descifra cualquier binario», sino en hacer trazable este ciclo:
pregunta → observación → hipótesis → verificación → implementación probada.
Fuentes y referencias
- Jorge Marfil, video sobre REA (13 de octubre de 2026)
- 96ia, resumen independiente del video de Jorge Marfil (13 de octubre de 2026)
- Repositorio oficial: morluto/rea
- README: capacidades, requisitos y guía de instalación
- Uso responsable y condiciones
Nota editorial: los detalles sobre la demostración se contrastaron con el resumen independiente de 96ia; no se tuvo acceso a la transcripción íntegra del video. Las especificaciones de REA se verificaron con el repositorio oficial. No se presenta una auditoría independiente de sus resultados.