 Capital de Tokens
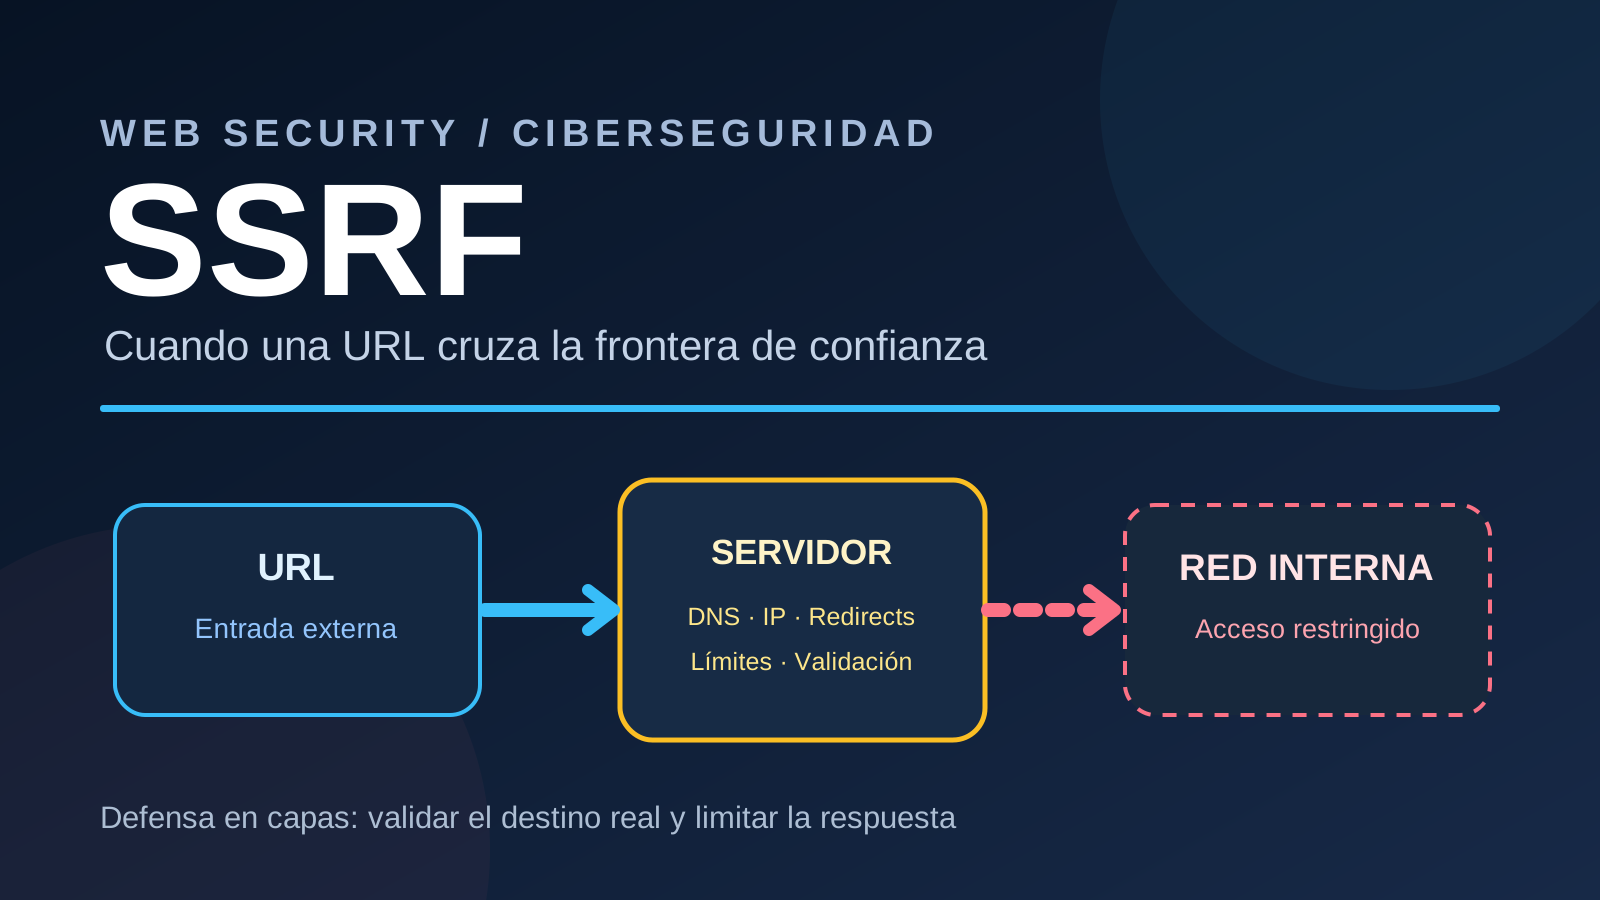
Una función aparentemente inocente puede convertirse en una puerta hacia lugares que nunca quisimos exponer: descargar una imagen a partir de una URL enviada por un usuario.
El problema no es descargar imágenes. Es permitir que una entrada externa decida, sin suficientes restricciones, a dónde se conecta nuestro servidor.
Ese es el núcleo de SSRF, siglas de Server-Side Request Forgery (falsificación de solicitudes del lado del servidor).
La diferencia entre una petición normal y una SSRF
Cuando abres una página en tu navegador, la petición sale de tu dispositivo. En SSRF, una aplicación recibe una dirección externa y hace la petición desde su propia infraestructura, posiblemente con acceso a redes y servicios que el visitante no puede alcanzar directamente.
Imagina un servicio genérico que genera miniaturas:
Usuario → aplicación → descarga de URL → miniaturaCon una dirección legítima, el resultado es el esperado:
https://images.example.org/foto.jpg
                 ↓
          imagen pública
Pero si se acepta cualquier destino, una entrada podría provocar una conexión hacia una interfaz local o un recurso de una red privada:
URL recibida
     ↓
servidor de la aplicación
     ↓
servicio interno que no estaba pensado para Internet
La aplicación se convierte en intermediaria involuntaria. No hace falta que el atacante tenga acceso directo a esa red; basta con lograr que el servidor solicite el recurso por él.
Esto no significa que toda SSRF permita leer secretos. El impacto depende de los destinos accesibles, los métodos HTTP permitidos, el tratamiento de las respuestas y los permisos de cada servicio.
¿Qué podría salir mal?
Entre los impactos posibles están:
- Acceso a servicios internos. Interfaces administrativas o APIs que confían en que las llamadas provienen de la red local.
- Exposición de metadatos de infraestructura. Algunas plataformas ofrecen endpoints internos con datos del entorno y, bajo determinadas configuraciones, credenciales temporales.
- Exploración de red. Códigos de error o diferencias de tiempo pueden revelar si existen determinados destinos.
- Acciones no deseadas. Si un servicio interno acepta operaciones sensibles sin autenticación adecuada, una petición inducida puede tener efectos más allá de leer información.
- Agotamiento de recursos. Descargas gigantes, respuestas interminables o muchos intentos concurrentes pueden saturar ancho de banda, memoria o almacenamiento.
El riesgo real no se deduce solo de encontrar una URL controlable. Hay que analizar qué puede alcanzar el proceso y qué hace con la respuesta.
El primer engaño: una redirección
Supongamos que el programa valida que la URL inicial apunte a una dirección pública.
1. Solicitud a https://images.example.org/foto.jpg
2. El servidor responde con una redirección HTTP
3. La nueva ubicación apunta a una dirección interna
4. El cliente HTTP sigue la redirección automáticamente
La validación del paso 1 no sirve para el destino del paso 4.
Por eso un descargador seguro no debería seguir redirecciones a ciegas. Puede prohibirlas o procesarlas manualmente, con un número máximo de saltos y aplicando las mismas comprobaciones a cada URL y destino efectivo.
El segundo engaño: DNS rebinding
Los dominios no son destinos de red fijos. Un nombre puede resolver a distintas direcciones IP a lo largo del tiempo.
Una defensa incompleta hace esto:
resolver dominio → comprobar que la IP es pública → conectar por nombreHay una ventana peligrosa entre comprobar la dirección y establecer la conexión. Si el cliente vuelve a resolver el nombre y obtiene una dirección interna, se habrá producido una diferencia entre la IP validada y la IP usada realmente.
Este patrón se conoce como DNS rebinding o, más generalmente, un problema de validación frente a uso (time of check / time of use).
La defensa sólida exige que la conexión se establezca a una dirección que ya se verificó. También debe conservar el nombre de host original donde corresponda para TLS y HTTP, sin permitir que un proxy, una librería o una reconexión rehagan la resolución de forma insegura.
No basta con comprobar el dominio una vez. Y tampoco basta con que «parezca público»: hay que evaluar correctamente las direcciones IPv4 e IPv6, incluidas variantes y representaciones especiales.
La tercera trampa: una respuesta demasiado grande
Incluso si la URL termina en una imagen pública legítima, una descarga sin límites puede causar problemas.
Por ejemplo, un servidor puede declarar un tamaño pequeño y enviar mucho más, omitir el encabezado de longitud o entregar contenido comprimido que se expande enormemente al procesarlo.
Un cliente que carga toda la respuesta en memoria antes de revisarla expone el proceso a una presión innecesaria.
Las precauciones son concretas:
- Leer la respuesta por fragmentos, no cargarla entera.
- Aplicar un límite real de bytes recibidos, incluso cuando exista Content-Length.
- Limitar redirecciones, tiempo de conexión, tiempo total y concurrencia.
- Comprobar el tipo y la firma del archivo cuando se esperan imágenes, y limitar también la decodificación y expansión.
- Limpiar archivos temporales y devolver errores controlados.
SSRF y agotamiento de memoria no son lo mismo, pero suelen coexistir en funciones que descargan contenido remoto sin restricciones.
Una política de descarga segura, paso a paso
La protección no debería depender de una sola expresión regular o de una lista corta de IPs bloqueadas.
| Capa | Control recomendado |
|---|---|
| Entrada | Aceptar solo los esquemas necesarios, normalmente HTTP/HTTPS; rechazar credenciales embebidas y URLs malformadas |
| Destino | Preferir una lista explícita de dominios confiables cuando el producto lo permita |
| DNS e IP | Resolver, clasificar todas las direcciones y bloquear loopback, privadas, link-local, reservadas y otros rangos no públicos |
| Conexión | Conectar únicamente a IPs validadas; controlar proxies y nuevas resoluciones |
| Redirecciones | Deshabilitar seguimiento automático; revisar cada salto y limitar su cantidad |
| Respuesta | Aplicar límites de tiempo, tamaño, streaming, concurrencia y validación de contenido |
| Infraestructura | Restringir tráfico saliente a redes internas y endpoints sensibles mediante controles de red |
| Pruebas | Probar URLs locales, IPs especiales, redirecciones internas, cambios de DNS y respuestas enormes sin depender de Internet |
Cuando es viable, una allowlist de destinos es más fuerte que permitir toda Internet y tratar de adivinar cada caso que debe bloquearse.
Los controles de red también importan: aunque falle una validación en la aplicación, un proceso de descarga no debería poder hablar libremente con todos los servicios internos.
¿Y si solo pueden usar la función usuarios autorizados?
La autenticación y la autorización son necesarias, pero resuelven otra pregunta: quién puede enviar una solicitud.
La protección SSRF responde a una distinta: a qué recursos puede conectarse el servidor como consecuencia de esa solicitud.
Una cuenta legítima puede equivocarse, ser comprometida o enviar contenido externo que termina procesándose de manera automática. La autorización de usuarios no sustituye la validación de destinos.
La idea que conviene recordar
El límite de confianza no acaba cuando una URL supera un filtro de texto.
Sigue en la resolución DNS, en la IP real de la conexión, en cada redirección y en los bytes que llegan después. Una función de descarga segura trata todas esas etapas como superficies distintas que necesitan controles.
Una URL es una instrucción para conectar. Cuando una aplicación acepta instrucciones de terceros, debe decidir explícitamente qué destinos, conexiones y respuestas está dispuesta a permitir.