 Capital de Tokens
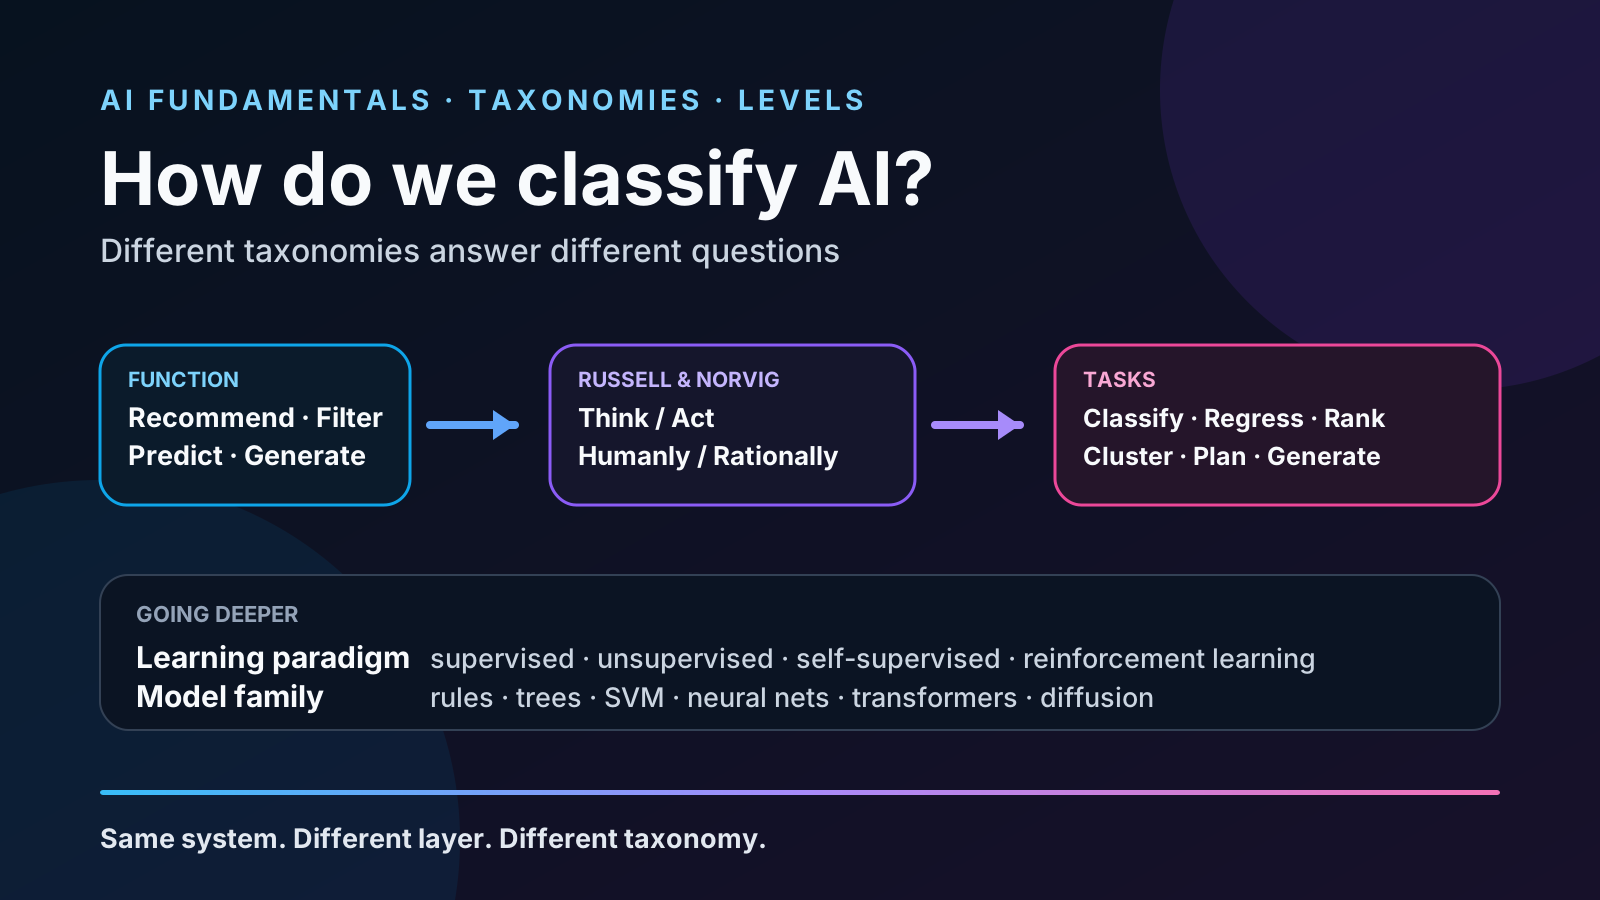
Cuando empezamos a estudiar inteligencia artificial es fácil encontrarse con clasificaciones que parecen contradecirse.
Un curso puede decir que la IA sirve para cuatro cosas:
- recomendar;
- filtrar;
- predecir;
- generar.
Un libro clásico como Artificial Intelligence: A Modern Approach, de Stuart Russell y Peter Norvig, organiza la disciplina de otra manera:
- pensar como humanos;
- actuar como humanos;
- pensar racionalmente;
- actuar racionalmente.
Y cuando bajamos a machine learning aparecen todavía más categorías:
- clasificación;
- regresión;
- ranking;
- clustering;
- detección de anomalías;
- forecasting;
- generación;
- reinforcement learning.
No hay una contradicción. Lo que cambia es el nivel de abstracción y la pregunta que estamos haciendo.
La forma más útil de ordenar todo esto es pensar en capas.
IA
│
├── ¿Para qué la usamos?
│     recomendar · filtrar · predecir · generar
│
├── ¿Qué significa construir inteligencia?
│     pensar/actuar · humano/racional
│
├── ¿Qué tarea matemática resuelve?
│     clasificación · regresión · ranking · clustering...
│
├── ¿Cómo aprende?
│     supervisado · no supervisado · self-supervised · RL
│
└── ¿Con qué técnica se implementa?
      reglas · árboles · SVM · redes neuronales · transformers...
Cada taxonomía describe una dimensión distinta.
Recomendar, filtrar, predecir y generar: una taxonomía funcional
Esta primera clasificación es especialmente útil para explicar IA a nivel de producto.
No intenta definir qué es la inteligencia. Describe qué trabajo realiza el sistema para el usuario.
1. Recomendar
El sistema selecciona o prioriza opciones que probablemente sean relevantes.
Ejemplos:
- películas;
- música;
- productos;
- noticias;
- personas a seguir;
- resultados de búsqueda.
Los sistemas de recomendación reales suelen dividir el problema en varias etapas. Google describe una arquitectura común con generación de candidatos, scoring y re-ranking.
millones de opciones
        ↓
generación de candidatos
        ↓
cientos de opciones
        ↓
scoring
        ↓
ranking
        ↓
re-ranking
        ↓
recomendaciones finales
Por tanto, “recomendar” es una función de producto que internamente puede utilizar ranking, embeddings, clasificación, modelos de similitud y otras técnicas.
2. Filtrar
Filtrar significa decidir qué información pasa y cuál se descarta, bloquea o reduce de prioridad.
Ejemplos:
- spam frente a correo legítimo;
- fraude frente a transacción normal;
- contenido permitido frente a contenido no permitido;
- alertas importantes frente a ruido;
- resultados relevantes frente a irrelevantes.
Aquí aparece una idea importante: filtrar no suele ser una tarea matemática única.
Puede implementarse mediante:
- clasificación;
- reglas;
- detección de anomalías;
- ranking;
- modelos de riesgo.
Un filtro de spam, por ejemplo, puede formularse como clasificación binaria:
email
  ↓
modelo
  ↓
spam / no spam
Google define precisamente la clasificación como la tarea de predecir a qué clase pertenece un ejemplo.
3. Predecir
Predecir significa estimar un resultado desconocido a partir de información disponible.
La palabra es muy amplia.
Podemos predecir una categoría:
transacción → fraude / legítimao un valor continuo:
casa → precio estimadoo una variable que cambia con el tiempo:
ventas históricas → ventas del próximo mesPor eso dentro de “predecir” caben tareas más técnicas como:
- clasificación;
- regresión;
- forecasting;
- estimación probabilística.
Scikit-learn, por ejemplo, separa explícitamente clasificación y regresión dentro del aprendizaje supervisado.
4. Generar
Generar significa producir una salida nueva en lugar de limitarse a elegir entre opciones o estimar un valor.
Puede ser:
- texto;
- código;
- imágenes;
- audio;
- música;
- video;
- estructuras moleculares;
- datos sintéticos.
prompt
   ↓
modelo generativo
   ↓
contenido nuevo
Google define la IA generativa alrededor de modelos capaces de producir contenido complejo, coherente y original.
Esta categoría se volvió especialmente visible con los LLM y los modelos de difusión, pero la generación no nació con ChatGPT: modelos anteriores, como RNN y LSTM, ya podían generar secuencias.
Esta primera taxonomía no es universal
“Recomendar, filtrar, predecir y generar” es una manera muy útil de enseñar las capacidades de los sistemas de IA.
Pero no es una clasificación única y canónica de toda la disciplina.
Dependiendo del curso podrían añadirse funciones como:
- optimizar;
- detectar;
- controlar;
- planificar;
- buscar;
- decidir.
Eso explica por qué otras fuentes usan divisiones diferentes.
La clasificación de Russell y Norvig pregunta otra cosa
Russell y Norvig no parten de la pregunta:
¿qué servicio presta la IA?
Su pregunta es más fundamental:
¿qué significa que una máquina sea inteligente?
En Artificial Intelligence: A Modern Approach presentan cuatro enfoques históricos.
Pensar como humanos
Aquí el objetivo es modelar cómo piensan realmente las personas.
La pregunta es:
¿podemos construir una máquina cuyo proceso cognitivo se parezca al humano?
Este enfoque conecta IA con psicología cognitiva y neurociencia.
No basta con obtener la respuesta correcta. Importa cómo se llega a ella.
Actuar como humanos
Aquí no es necesario replicar el mecanismo mental humano.
Lo importante es que el comportamiento observable sea humano.
El ejemplo clásico es el Test de Turing.
humano ← conversación → máquina

¿podemos distinguirlos por su comportamiento?
Este enfoque mide inteligencia desde fuera.
Pensar racionalmente
Esta tradición intenta formalizar el razonamiento correcto.
Se relaciona con las llamadas leyes del pensamiento: lógica, inferencia y deducción.
Si tenemos:
A implica B
A es verdadero
---------------
B es verdadero
el sistema debería ser capaz de llegar correctamente a la conclusión.
El problema es que el mundo real suele incluir información incompleta, incertidumbre y recursos computacionales limitados.
Actuar racionalmente
Este es el enfoque de los agentes racionales.
Un agente:
- percibe su entorno;
- considera posibles acciones;
- elige una acción orientada a sus objetivos.
entorno
   ↓
percepción
   ↓
 AGENTE
   ↓
acción
   ↓
entorno
La racionalidad no significa saberlo todo. Significa seleccionar una acción razonable usando la información y los recursos disponibles.
Este enfoque ocupa un lugar central en la organización moderna del libro de Russell y Norvig.
Las dos taxonomías no compiten
Podemos ponerlas una al lado de la otra:
| Pregunta | Ejemplo de taxonomía |
|---|---|
| ¿Qué hace el sistema para el usuario? | recomendar, filtrar, predecir, generar |
| ¿Qué significa comportamiento inteligente? | pensar/actuar, humano/racional |
| ¿Qué problema matemático resuelve? | clasificación, regresión, clustering, ranking |
| ¿Cómo aprende? | supervisado, no supervisado, self-supervised, reinforcement learning |
| ¿Cómo está construido? | árboles, SVM, redes neuronales, transformers, reglas |
Un mismo sistema puede ocupar simultáneamente una categoría en cada fila.
Bajando un nivel: taxonomía por tareas
Para ingeniería de machine learning suele ser más útil hablar de tareas.
Clasificación
Asignar una categoría.
imagen → gato
email → spam
transacción → fraude
Regresión
Predecir un número continuo.
casa → $425,000
sensor → 72.4 °C
cliente → $183 de gasto esperado
Ranking
Ordenar candidatos por relevancia.
documentos
   ↓
modelo
   ↓
1. resultado A
2. resultado C
3. resultado B
Es fundamental en buscadores y sistemas de recomendación.
Clustering
Agrupar ejemplos similares cuando no disponemos necesariamente de etiquetas.
Google lo describe como una técnica de aprendizaje no supervisado que agrupa datos no etiquetados según una medida de similitud.
datos sin etiquetas
       ↓
clustering
       ↓
grupo A · grupo B · grupo C
Detección de anomalías
Encontrar observaciones que se alejan del comportamiento habitual.
Ejemplos:
- fraude;
- fallos industriales;
- tráfico extraño;
- comportamiento inusual de una cuenta.
Forecasting
Predecir cómo evolucionará una variable en el tiempo.
Ejemplos:
- demanda;
- ventas;
- tráfico;
- consumo eléctrico.
Generación
Crear nuevas muestras o secuencias.
Con LLM:
tokens anteriores
      ↓
modelo
      ↓
probabilidad del próximo token
      ↓
nuevo token
El proceso se repite hasta construir una respuesta.
Planificación y control
Elegir acciones para alcanzar un objetivo.
Esta categoría conecta directamente con el concepto de agente racional.
estado actual
    ↓
acciones posibles
    ↓
evaluación
    ↓
acción
    ↓
nuevo estado
Otro nivel: cómo aprende el sistema
Una tarea no determina necesariamente el método de aprendizaje.
Podemos clasificar también por el tipo de señal utilizada durante el entrenamiento.
Aprendizaje supervisado
Disponemos de ejemplos con una respuesta conocida.
entrada + etiqueta
       ↓
entrenamiento
       ↓
modelo
Clasificación y regresión son casos típicos.
Aprendizaje no supervisado
No existe una etiqueta objetivo explícita.
El sistema intenta descubrir estructura en los datos.
Clustering es un ejemplo clásico.
Self-supervised learning
Los propios datos proporcionan la señal de entrenamiento.
Los modelos de lenguaje ofrecen un ejemplo especialmente importante: una secuencia contiene los tokens que el modelo intentará predecir.
Reinforcement learning
Un agente toma acciones y recibe señales de recompensa.
estado → acción → recompensa → nuevo estadoEl objetivo pasa a ser aprender una política que produzca buenas decisiones a lo largo del tiempo.
Y todavía podemos bajar otro nivel: la familia de modelos
Finalmente llegamos a las técnicas concretas.
Un problema de clasificación podría resolverse con:
- regresión logística;
- árboles de decisión;
- random forests;
- gradient boosting;
- SVM;
- redes neuronales;
- transformers.
Un sistema de planificación podría usar:
- búsqueda;
- programación dinámica;
- constraint solving;
- planificación simbólica;
- reinforcement learning;
- un LLM dentro de un harness agentic.
Por eso frases como:
“Esto es IA generativa”
y
“Esto usa un transformer”
describen cosas distintas.
La primera habla de la función o comportamiento.
La segunda habla de una arquitectura posible.
Un ejemplo completo: un recomendador de videos
Veamos todas las capas en un mismo sistema.
PROPÓSITO
recomendar videos

        ↓

TAREAS
candidate generation
ranking
clasificación

        ↓

APRENDIZAJE
supervisado + self-supervised

        ↓

REPRESENTACIÓN
embeddings

        ↓

MODELOS
redes neuronales / transformers

        ↓

SISTEMA
candidate generation → scoring → re-ranking
Decir únicamente “es una IA que recomienda” es correcto.
Pero es una descripción de alto nivel.
Otro ejemplo: ChatGPT
También podemos describir un asistente generativo en varias capas.
PROPÓSITO
generar / asistir

        ↓

TAREA BASE
modelado de lenguaje

        ↓

ENTRENAMIENTO
self-supervised + post-training

        ↓

ARQUITECTURA
transformer

        ↓

SISTEMA
modelo + herramientas + memoria/contexto + políticas
Y si ese sistema empieza a percibir un entorno, utilizar herramientas y elegir acciones para completar objetivos, también podemos analizarlo desde la perspectiva de agentes racionales.
La idea clave: antes de discutir una taxonomía, pregunta qué está clasificando
Muchas discusiones sobre IA parecen confusas porque dos personas usan categorías de niveles diferentes.
Una habla del producto:
“Esta IA recomienda.”
Otra habla de la tarea:
“Eso es ranking.”
Otra habla del aprendizaje:
“Está entrenado de forma supervisada.”
Otra habla de la arquitectura:
“Usa un transformer.”
Las cuatro afirmaciones pueden ser ciertas simultáneamente.
Una jerarquía mental útil es:
¿PARA QUÉ?
recomendar · filtrar · predecir · generar

        ↓

¿QUÉ TAREA?
clasificación · regresión · ranking · clustering · planificación...

        ↓

¿CÓMO APRENDE?
supervisado · no supervisado · self-supervised · RL

        ↓

¿CON QUÉ MODELO?
árbol · SVM · red neuronal · transformer · difusión...

        ↓

¿CÓMO SE INTEGRA?
pipeline · servicio · agente · herramientas · memoria
Con esta jerarquía desaparece gran parte de la aparente contradicción entre las distintas formas de clasificar la inteligencia artificial.
No existe una sola taxonomía correcta para todos los propósitos.
La pregunta correcta es:
¿qué dimensión de la IA estamos intentando describir?
Fuentes
- Artificial Intelligence: A Modern Approach — Table of Contents
- Artificial Intelligence: A Modern Approach, 4th edition
- Scikit-learn User Guide
- Google Machine Learning: Recommendation systems overview
- Google Machine Learning: Classification
- Google Machine Learning: What is clustering?
- Google Machine Learning Glossary: Generative AI