 Capital de Tokens
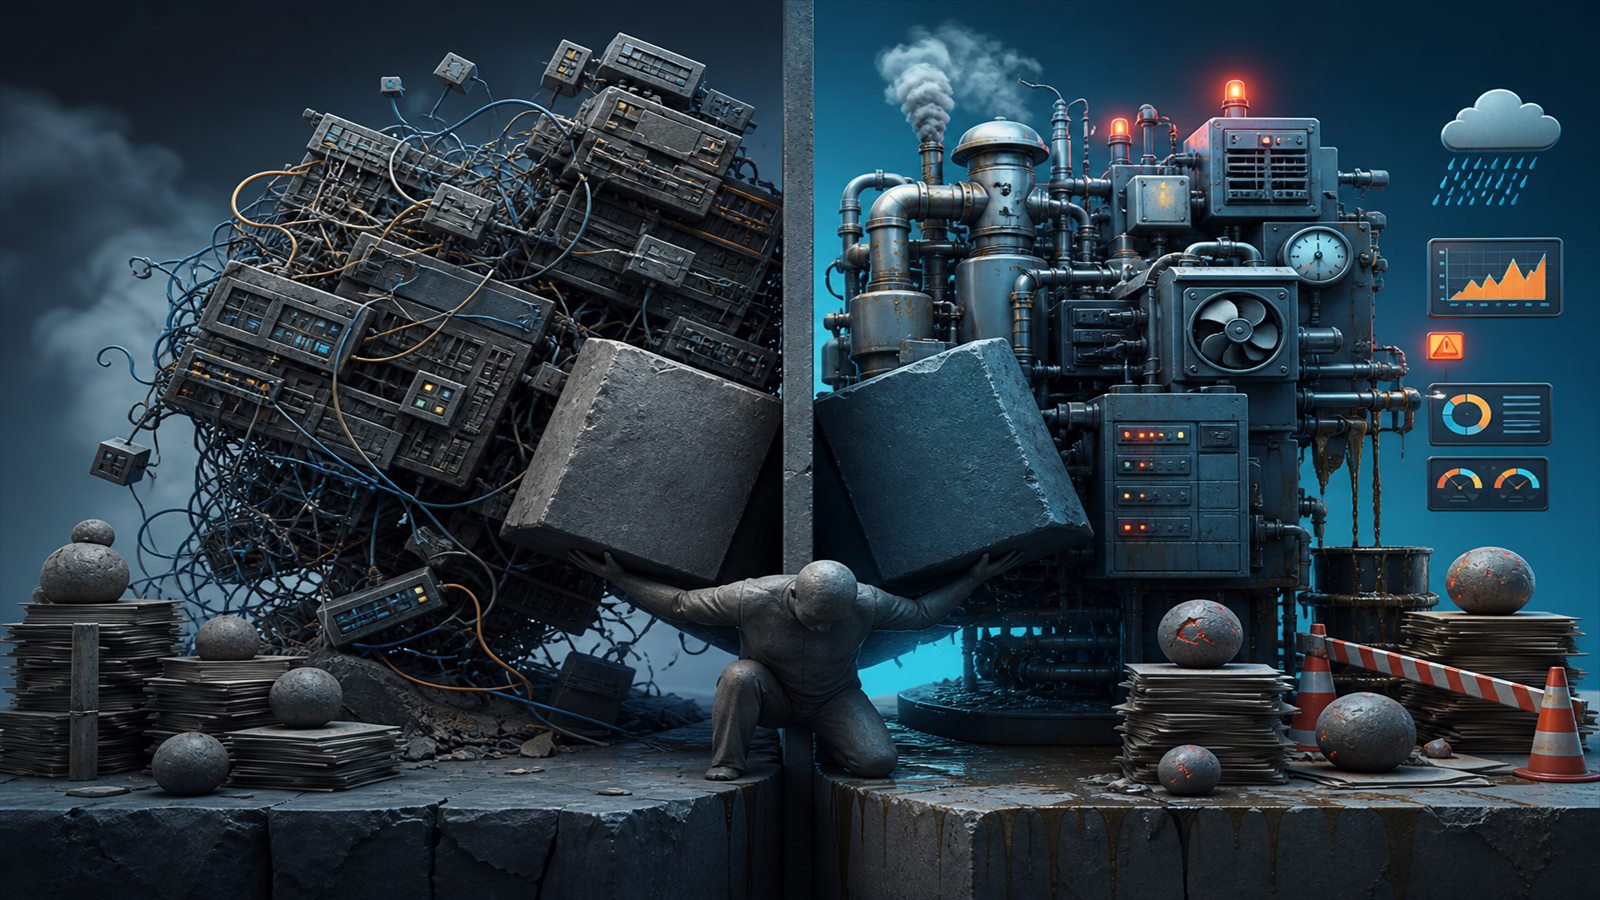
Technical debt vs operational debt: dos formas distintas de pagar intereses
En ingeniería de software hablamos constantemente de technical debt.
Código duplicado.
Arquitecturas difíciles de modificar.
Dependencias obsoletas.
Tests insuficientes.
APIs internas que nadie quiere tocar.
Pero existe otra deuda que suele recibir menos atención y que, en sistemas reales, puede ser igual o más costosa: operational debt.
La forma más sencilla de distinguirlas es ésta:
Technical debt = qué tan difícil es cambiar el sistema.
Operational debt = qué tan difícil es mantener el sistema funcionando.
Ambas generan intereses.
La diferencia está en dónde los pagamos.
Technical debt: pagar más cada vez que cambiamos el software
Technical debt aparece cuando una decisión de diseño, arquitectura o implementación hace que el sistema sea más difícil de evolucionar.
Por ejemplo:
Nueva feature
   ↓
hay que modificar 7 módulos
   ↓
nadie sabe qué puede romperse
   ↓
3 días de regresión
El problema no es necesariamente que el software esté caído.
Puede funcionar perfectamente en producción.
El problema aparece cuando intentamos modificarlo.
Algunos ejemplos clásicos:
- código duplicado;
- módulos altamente acoplados;
- falta de tests;
- interfaces internas inconsistentes;
- dependencias legacy;
- workarounds convertidos en arquitectura permanente;
- configuraciones hardcodeadas;
- modelos de datos difíciles de extender;
- una base de código donde sólo una persona entiende ciertas áreas.
Podemos pensar la technical debt como un impuesto sobre el desarrollo futuro.
cambio simple
   ↓
complejidad acumulada
   ↓
más tiempo
   ↓
más riesgo
   ↓
más testing
   ↓
más coste
El “interés” se paga cada vez que tocamos el sistema.
Operational debt: pagar más cada vez que operamos el sistema
Operational debt aparece cuando el sistema puede estar bien construido, pero operarlo requiere demasiado trabajo manual, conocimiento tribal o procedimientos frágiles.
Por ejemplo:
Deploy
   ↓
SSH al servidor
   ↓
editar config
   ↓
copiar archivos
   ↓
reiniciar servicio
   ↓
mirar logs manualmente
El código puede ser limpio.
Los tests pueden ser excelentes.
La arquitectura puede estar bien modularizada.
Pero si desplegar, recuperar, monitorear o diagnosticar el sistema requiere rituales manuales, existe operational debt.
Ejemplos frecuentes:
- deploys manuales;
- servidores configurados a mano;
- infraestructura que no está en IaC;
- secretos copiados manualmente;
- certificados que alguien tiene que recordar renovar;
- alertas llenas de falsos positivos;
- dashboards que nadie sabe interpretar;
- ausencia de runbooks;
- backups que existen pero nunca se han probado;
- disaster recovery que sólo vive en un documento antiguo;
- procesos de rollback lentos o desconocidos;
- conocimiento operacional que sólo posee una persona;
- observabilidad insuficiente.
Aquí el interés no se paga al implementar una feature.
Se paga durante:
deploys
incidentes
migraciones
on-call
recuperaciones
cambios de infraestructura
La diferencia en una tabla
| Technical debt | Operational debt | |
|---|---|---|
| Se acumula principalmente en | código, arquitectura, diseño | operación, infraestructura, procesos |
| Hace más difícil | cambiar el sistema | mantenerlo funcionando |
| El interés aparece durante | desarrollo y mantenimiento | despliegues, incidentes y operación |
| Ejemplo | cambiar una feature rompe cinco módulos | cada deploy requiere diez pasos manuales |
| Síntoma típico | ”nadie quiere tocar esa parte" | "sólo Juan sabe hacer ese procedimiento” |
Una pregunta útil para distinguirlas es:
¿El dolor aparece cuando intento cambiar el software?
→ probablemente technical debt

¿El dolor aparece cuando intento operarlo?
→ probablemente operational debt
Un sistema puede tener poca technical debt y mucha operational debt
Imaginemos una API bastante bien diseñada:
API
├── módulos claros
├── buenos tests
├── dependencias actualizadas
└── arquitectura razonable
Pero producción funciona así:
release
  ↓
compilar manualmente
  ↓
subir artifact
  ↓
entrar al servidor
  ↓
actualizar variables
  ↓
reiniciar servicio
  ↓
comprobar logs
La base de código puede ser saludable.
La operación no.
Eso es operational debt.
También puede ocurrir lo contrario
Un equipo puede haber automatizado muy bien la operación:
commit
  ↓
CI
  ↓
tests
  ↓
artifact
  ↓
deploy
  ↓
health checks
  ↓
rollback automático
Pero debajo puede existir una arquitectura monolítica, altamente acoplada y difícil de modificar.
La plataforma operacional es excelente.
El producto acumula technical debt.
El caso más peligroso: cuando ambas deudas se alimentan
En producción, technical debt y operational debt rara vez permanecen completamente separadas.
Una puede producir la otra.
Por ejemplo:
aplicación sin health checks claros
            ↓
no existe señal fiable de salud
            ↓
operaciones mira logs manualmente
            ↓
se crea un procedimiento manual
            ↓
operational debt
El origen fue técnico.
El coste termina siendo operacional.
Otro ejemplo:
infraestructura configurada manualmente
            ↓
nadie sabe exactamente qué existe
            ↓
los desarrolladores temen cambiarla
            ↓
se acumulan workarounds
            ↓
technical debt
Aquí la deuda operacional acaba creando deuda técnica.
El ciclo puede volverse autosostenido:
technical debt
      ↓
más dificultad para automatizar
      ↓
operational debt
      ↓
más miedo a cambiar
      ↓
más workarounds
      ↓
más technical debt
Observabilidad es un lugar donde las dos se mezclan mucho
Los sistemas de monitoreo son un ejemplo perfecto.
Supongamos que tenemos:
20 health checks
30 alert rules
varios dashboards
Action Groups
scripts de mantenimiento
La technical debt puede aparecer como:
- recursos legacy;
- configuraciones duplicadas;
- nombres inconsistentes;
- APIs antiguas;
- reglas difíciles de reutilizar;
- templates que nadie quiere tocar.
La operational debt puede aparecer como:
- alertas que nadie sabe a qué servicio pertenecen;
- falta de ownership;
- cambios manuales en el portal;
- ausencia de runbook;
- notificaciones que nunca se prueban;
- dashboards que muestran verde aunque el canal de alerta esté roto.
Y aquí aparece una propiedad importante:
Un sistema de observabilidad puede “funcionar” técnicamente y aun así estar operacionalmente endeudado.
El ejemplo real: Azure URL Ping Tests → Standard Tests
Un caso reciente que documentamos en Capital de Tokens muestra muy bien esta intersección.
Microsoft está retirando los URL Ping Tests clásicos de Application Insights, lo que obliga a migrarlos a Standard Tests.
El análisis completo está aquí:
Migrando Azure Application Insights URL Ping Tests a Standard Tests sin perder alertas
A primera vista parece una migración puramente técnica:
legacy webtest
     ↓
standard webtest
Eso sería la parte más visible de la technical debt: existe una tecnología legacy que debe reemplazarse.
Pero la migración mostró que el problema real era bastante más amplio.
También había que preservar:
alert rules
Action Groups
notificaciones
secret handling
telemetría
rollback
runbook
Ahí aparece la operational debt.
Porque crear el nuevo Standard Test no garantiza que:
- la alerta apunte al recurso correcto;
- el scope de Azure Monitor sea coherente;
- el Action Group continúe conectado;
- alguien reciba realmente un email cuando falle;
- exista una ruta rápida de rollback.
Por eso el procedimiento terminó pareciéndose a esto:
DISCOVER
   ↓
INVENTORY
   ↓
WHAT-IF
   ↓
DEPLOY DISABLED
   ↓
VERIFY
   ↓
ENABLE
   ↓
MOVE ALERTS
   ↓
TEST FAILURE PATH
   ↓
KEEP ROLLBACK
La sustitución del recurso era technical debt.
La necesidad de hacer explícito y verificable todo el procedimiento era operational debt.
Una alerta que nunca se prueba también es deuda
Existe una forma particularmente silenciosa de operational debt: configuración que asumimos correcta porque nunca ha fallado.
Por ejemplo:
Availability Test ✅
Alert Rule        ✅
Action Group      ✅
Todo aparece configurado.
Pero nunca hemos forzado una condición de fallo.
Entonces realmente no sabemos si:
endpoint falla
   ↓
test detecta fallo
   ↓
alert rule dispara
   ↓
Action Group ejecuta
   ↓
operador recibe notificación
En la migración de Standard Tests, la solución fue realizar un fallo sintético controlado y comprobar la cadena completa.
Ese tipo de prueba reduce operational debt porque convierte conocimiento supuesto en conocimiento demostrado.
IaC reduce operational debt, pero no necesariamente technical debt
Infrastructure as Code suele ser una de las mejores herramientas contra deuda operacional.
En vez de:
"entra al portal y cambia estas seis cosas"podemos tener:
repo
  ↓
template
  ↓
What-If
  ↓
review
  ↓
deploy
Eso mejora:
- reproducibilidad;
- auditoría;
- rollback;
- revisión;
- automatización;
- transferencia de conocimiento.
Pero IaC mal diseñada también puede acumular technical debt.
Un template gigante de 8.000 líneas con lógica duplicada puede ser perfectamente reproducible y al mismo tiempo dificilísimo de mantener.
La automatización no elimina automáticamente la deuda técnica.
Runbooks son código operacional
Una forma útil de pensar los runbooks es tratarlos como parte del producto.
Si un incidente crítico depende de que alguien recuerde:
primero ejecuta A
luego cambia B
si aparece C haz D
pero sólo en producción oeste
tenemos deuda operacional.
Un buen runbook transforma memoria tribal en un procedimiento explícito:
trigger
  ↓
diagnóstico
  ↓
acción
  ↓
verificación
  ↓
rollback
Y el siguiente paso natural es automatizar aquello que sea seguro automatizar.
Podemos pensar la evolución así:
conocimiento tribal
      ↓
documentación
      ↓
runbook
      ↓
script
      ↓
pipeline
      ↓
policy / automation
Cada paso reduce la dependencia de memoria humana.
Cómo detectar technical debt
Algunas preguntas útiles:
- ¿un cambio pequeño requiere modificar demasiadas partes?
- ¿hay módulos que nadie quiere tocar?
- ¿los tests son demasiado frágiles para refactorizar?
- ¿existen dependencias que bloquean upgrades?
- ¿hay lógica duplicada por todas partes?
- ¿el diseño actual obliga a introducir workarounds regularmente?
Si la respuesta es sí, probablemente estamos pagando intereses técnicos.
Cómo detectar operational debt
Otras preguntas:
- ¿cuántos pasos manuales tiene un deploy?
- ¿cuántos procedimientos dependen de una persona concreta?
- ¿podemos reconstruir producción desde código?
- ¿hemos probado recientemente nuestros backups?
- ¿hemos probado nuestras alertas end-to-end?
- ¿existe rollback conocido y probado?
- ¿podemos explicar quién es owner de cada alerta?
- ¿sabemos exactamente qué hacer durante un incidente a las 3 AM?
Si muchas respuestas son “no”, probablemente existe operational debt.
No toda deuda es mala
La palabra deuda puede dar la impresión de que cualquier shortcut es incorrecto.
No necesariamente.
Una startup puede decidir conscientemente:
hoy: deploy parcialmente manual
porque:
necesitamos validar producto
antes de invertir una semana en automatización
Eso puede ser perfectamente racional.
La analogía financiera funciona bien aquí.
Tomar deuda no es necesariamente malo.
Lo peligroso es:
contraer deuda
   +
no medirla
   +
no pagarla
   +
seguir acumulando intereses
La pregunta importante es si la deuda es deliberada y visible.
Una forma práctica de gestionarlas juntas
Podemos mantener dos backlogs separados.
Technical debt backlog
refactors
upgrades
arquitectura
interfaces
simplificación
tests
Operational debt backlog
deploy automation
IaC
runbooks
alert quality
backup verification
rollback
incident tooling
ownership
Separarlas evita que operational debt desaparezca dentro de una categoría genérica de “cosas técnicas”.
También ayuda a priorizar mejor.
Un refactor puede reducir el coste de desarrollo durante los próximos seis meses.
Automatizar rollback puede reducir el impacto de un incidente mañana.
Ambos son importantes, pero optimizan riesgos diferentes.
La idea que conviene recordar
Cuando alguien diga que un sistema tiene mucha deuda, vale la pena preguntar:
¿deuda para cambiarlo?
      o
¿deuda para operarlo?
Porque son problemas distintos.
Podemos resumirlos así:
TECHNICAL DEBT
"cada cambio cuesta demasiado"

OPERATIONAL DEBT
"cada operación cuesta demasiado"
Y en sistemas maduros probablemente necesitemos vigilar ambas como métricas de salud de ingeniería.
El mejor software no es solamente aquel que funciona hoy.
También debe ser razonablemente fácil de cambiar mañana y de mantener funcionando mientras tanto.
Ahí está la diferencia entre pagar intereses técnicos y pagar intereses operacionales.