 Capital de Tokens
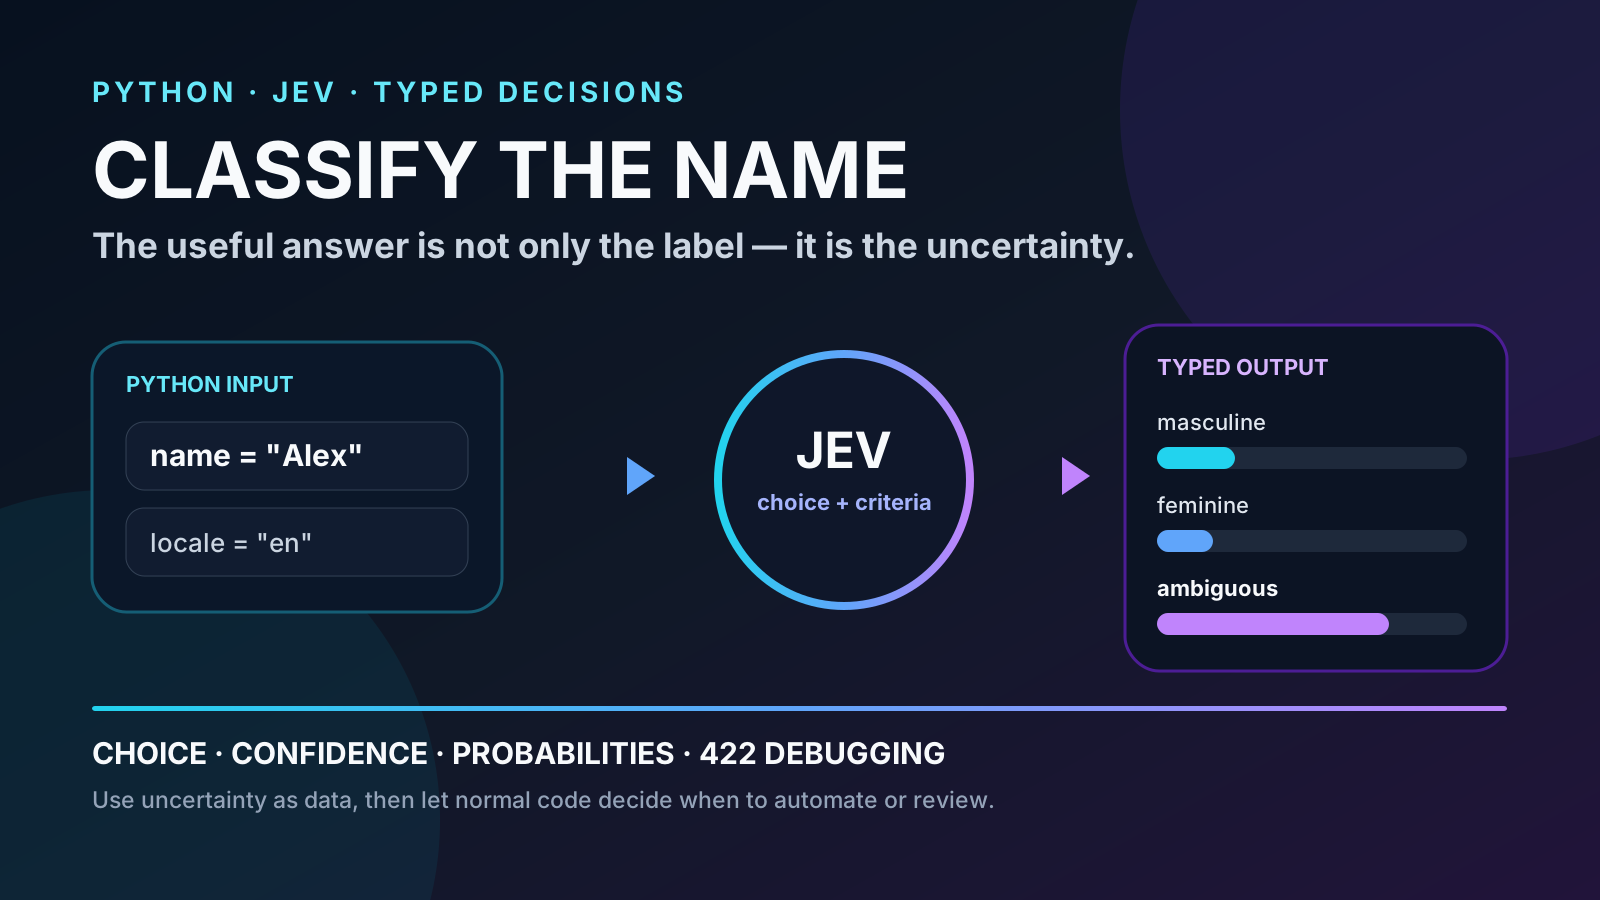
Los modelos generativos son muy buenos escribiendo respuestas.
Pero a veces nuestro programa no necesita un párrafo.
Necesita esto:
masculino
femenino
ambiguo
Y, todavía mejor, necesita saber qué tan segura es esa decisión.
Ese tipo de problema encaja muy bien con Jev, el primer System One Model de TypeSafe AI. En lugar de generar texto libre, Jev recibe un estado, una o más preguntas tipadas y devuelve decisiones estructuradas con probabilidades.
Vamos a construir un ejemplo pequeño pero completo:
recibir un nombre y clasificar su uso habitual como masculino, femenino o ambiguo.
La precisión de esa frase importa. No estamos intentando inferir la identidad de género de una persona. Estamos clasificando el uso lingüístico habitual de un nombre, que puede variar según país, idioma y cultura.
El objetivo
Queremos terminar con una función así:
result = classify_name("Alex")

print(result["choice"])
print(result["confidence"])
print(result["probabilities"])
Y obtener una estructura equivalente a:
choice: ambiguo
confidence: ...
probabilities:
  masculino: ...
  femenino: ...
  ambiguo: ...
Los números dependen de la respuesta real del modelo. Lo importante es que nuestro programa recibe una decisión tipada, no una explicación que luego tengamos que parsear.
Instalar las dependencias
Necesitamos requests y python-dotenv:
pip install requests python-dotenvCreamos un archivo .env:
TYPESAFE_API_KEY=tu_api_keyY evitamos subirlo a Git:
.envEl request mínimo
El endpoint actual es:
POST https://api.typesafe.ai/v1/systemoneEl request contiene tres piezas principales:
{
    "model": "jev-latest",
    "state": {...},
    "questions": {...}
}
state describe aquello sobre lo que Jev debe decidir.
questions define las decisiones que queremos obtener.
Para una clasificación con varias opciones usamos una pregunta de tipo choice.
El detalle que provoca muchos 422
Una pregunta choice no usa una lista llamada choices.
La API actual espera un objeto llamado criteria.
Esto está mal:
"choices": [
    "masculino",
    "femenino",
    "ambiguo",
]
Esto es lo correcto:
"criteria": {
    "masculino": "El nombre se usa predominantemente como nombre masculino.",
    "femenino": "El nombre se usa predominantemente como nombre femenino.",
    "ambiguo": "El nombre se usa de forma relevante para más de un género o su uso depende fuertemente del contexto cultural.",
}
En el esquema OpenAPI de TypeSafe, criteria es obligatorio para choice. Si falta o la estructura del request no coincide con el esquema, el servidor responde con HTTP 422 Unprocessable Entity.
Ese error no significa que Jev haya “razonado mal”.
Significa que nuestro JSON no pasó la validación de entrada.
Script completo
Este ejemplo recibe el nombre por consola, llama a Jev y muestra la decisión, la confianza y todas las probabilidades.
import os
import sys

import requests
from dotenv import load_dotenv


API_URL = "https://api.typesafe.ai/v1/systemone"


def classify_name(name: str, locale: str | None = None) -> dict:
    load_dotenv()

    api_key = os.getenv("TYPESAFE_API_KEY")
    if not api_key:
        raise RuntimeError(
            "Falta TYPESAFE_API_KEY. Añádela al entorno o a un archivo .env."
        )

    state = {
        "name": name,
    }

    if locale:
        state["locale"] = locale

    payload = {
        "model": "jev-latest",
        "state": state,
        "questions": {
            "name_usage": {
                "type": "choice",
                "instructions": (
                    "Clasifica el uso habitual del nombre indicado. "
                    "No infieras la identidad de género de una persona. "
                    "Usa el contexto cultural o lingüístico si se proporciona."
                ),
                "criteria": {
                    "masculino": (
                        "El nombre se usa predominantemente como nombre masculino "
                        "en el contexto indicado."
                    ),
                    "femenino": (
                        "El nombre se usa predominantemente como nombre femenino "
                        "en el contexto indicado."
                    ),
                    "ambiguo": (
                        "El nombre se usa de manera relevante para más de un género, "
                        "es unisex, o cambia de forma importante según cultura o idioma."
                    ),
                },
            }
        },
    }

    response = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {api_key}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=30,
    )

    if response.status_code == 422:
        print("Jev rechazó el esquema del request:", file=sys.stderr)

        try:
            error = response.json()
        except ValueError:
            print(response.text, file=sys.stderr)
        else:
            print(error, file=sys.stderr)

        response.raise_for_status()

    response.raise_for_status()

    data = response.json()
    answer = data["answers"]["name_usage"]

    return {
        "choice": answer["choice"],
        "confidence": answer["confidence"],
        "probabilities": answer["probabilities"],
        "model": data["model"],
        "usage": data["usage"],
    }


def main() -> None:
    name = input("Nombre: ").strip()

    if not name:
        raise SystemExit("Debes escribir un nombre.")

    locale = input(
        "Contexto cultural opcional (ej. es, en, it; Enter para omitir): "
    ).strip()

    result = classify_name(name, locale or None)

    print()
    print(f"Nombre: {name}")
    print(f"Clasificación: {result['choice']}")
    print(f"Confianza: {result['confidence']:.2%}")
    print("Probabilidades:")

    for label, probability in result["probabilities"].items():
        print(f"  {label}: {probability:.2%}")

    print(f"Modelo: {result['model']}")
    print(f"Uso: {result['usage']}")


if __name__ == "__main__":
    main()
Qué devuelve realmente Jev
Según el esquema actual de la API, una respuesta de tipo choice contiene:
choice: la opción con mayor probabilidad;confidence: confianza en la opción seleccionada, entre 0 y 1;probabilities: probabilidad asignada a cada alternativa;type:choice.
Conceptualmente:
{
  "type": "choice",
  "choice": "ambiguo",
  "confidence": 0.78,
  "probabilities": {
    "masculino": 0.16,
    "femenino": 0.12,
    "ambiguo": 0.72
  }
}
Ese JSON es ilustrativo; no representa una ejecución concreta.
La diferencia con pedirle a un LLM “responde masculino o femenino” es importante.
Con una salida de texto podríamos recibir:
Probablemente masculino, aunque depende del país.Ahora nuestro código tiene que interpretar esa frase.
Con Jev, las posibilidades ya estaban definidas antes de ejecutar el modelo.
La incertidumbre también es una salida útil
Supongamos que nuestro sistema no quiere actuar automáticamente cuando Jev no está suficientemente seguro.
Podemos añadir un gate:
result = classify_name("Robin", "en")

if result["confidence"] < 0.80:
    print("Revisión manual")
else:
    print(result["choice"])
La arquitectura pasa a ser:
nombre
  │
  ▼
Jev
  │
  ├── choice
  ├── confidence
  └── probabilities
         │
         ▼
    regla de negocio
         │
    ┌────┴─────┐
    │          │
 alta        baja
 confianza   confianza
    │          │
 actuar      revisar
El modelo produce incertidumbre.
El código decide qué hacer con ella.
Ese es uno de los puntos más interesantes de los System One Models: la decisión probabilística puede formar parte de un workflow normal de software.
Un nombre puede cambiar según el contexto
Este ejemplo también enseña por qué state no debería limitarse siempre a una cadena.
Consideremos Andrea.
En muchos contextos hispanohablantes se interpreta principalmente como nombre femenino.
En Italia también es un nombre masculino muy común.
Por eso podemos enviar:
state = {
    "name": "Andrea",
    "locale": "es"
}
o:
state = {
    "name": "Andrea",
    "locale": "it"
}
La pregunta no cambió.
Cambió el estado sobre el que debe tomarse la decisión.
Esto se parece mucho más a una función:
decision = f(state)que a un chatbot tradicional.
Buenos nombres para probar
Para comprobar cómo se comporta el modelo ante casos menos obvios, podemos probar:
Alex
Andrea
Ariel
Charlie
Chris
Dominique
Jamie
Jordan
Leslie
Morgan
Robin
Sam
Sasha
Taylor
No todos son igualmente ambiguos en todas las culturas.
Precisamente ese es el experimento interesante.
Podemos ejecutar el mismo nombre con contextos distintos y comparar cómo se mueve la distribución de probabilidades.
Hacer pruebas en lote
Podemos automatizar el experimento:
names = [
    "Frank",
    "Maria",
    "Alex",
    "Andrea",
    "Robin",
    "Sasha",
]

for name in names:
    result = classify_name(name)

    probs = result["probabilities"]

    print(
        f"{name:10} "
        f"{result['choice']:10} "
        f"conf={result['confidence']:.2%} "
        f"M={probs.get('masculino', 0):.2%} "
        f"F={probs.get('femenino', 0):.2%} "
        f"A={probs.get('ambiguo', 0):.2%}"
    )
Esto convierte un juguete de consola en el principio de un pequeño benchmark.
Podemos preguntar:
- ¿qué nombres generan mayor incertidumbre?;
- ¿cambia el resultado al proporcionar contexto cultural?;
- ¿qué tan estable es la distribución entre ejecuciones?;
- ¿en qué casos nuestro threshold manda la decisión a revisión?;
- ¿qué criterios necesitan una definición más precisa?
Cómo diagnosticar bien un 422
Durante el desarrollo es tentador escribir solamente:
response.raise_for_status()Pero entonces vemos:
requests.exceptions.HTTPError:
422 Client Error: Unprocessable Entity
y perdemos la parte más útil.
Mientras desarrollamos, conviene imprimir la respuesta:
if not response.ok:
    print("HTTP:", response.status_code)
    print(response.text)

response.raise_for_status()
El esquema de error de TypeSafe incluye una lista detail con campos como:
loc
msg
type
loc nos dice dónde está el valor inválido.
Por ejemplo, si el problema está en:
body → questions → name_usage → criteriaya sabemos que debemos revisar esa parte del payload.
Un 422 bien leído puede ahorrarnos bastante debugging.
No hardcodees eternamente el nombre del modelo
La API también expone:
GET /v1/modelspara descubrir los modelos y aliases disponibles en la cuenta autenticada.
Podemos consultarlo así:
response = requests.get(
    "https://api.typesafe.ai/v1/models",
    headers={
        "Authorization": f"Bearer {api_key}",
    },
    timeout=30,
)

response.raise_for_status()

for model in response.json()["models"]:
    print(model["name"], model["release_date"])
Para demos está bien usar jev-latest.
En producción conviene decidir explícitamente cómo queremos manejar aliases y nuevas versiones.
El verdadero ejemplo no es “adivinar género”
El ejemplo parece tratar de nombres.
Pero el patrón es mucho más general.
Podemos reemplazar los criterios por:
fraude / legítimo / revisar
bug / feature / pregunta
urgente / normal / baja prioridad
permitir / bloquear / escalar
ventas / soporte / facturación
aprobado / rechazado / revisión manual
La estructura sigue siendo la misma:
estado
  +
pregunta tipada
  +
criterios definidos por el programa
  ↓
decisión probabilística
  ↓
código normal
Ese es el punto importante.
Jev no tiene que escribir una respuesta bonita.
Tiene que producir una señal que nuestro software pueda usar.
Un detalle que no debemos perder
TypeSafe describe Jev como un modelo orientado a decisiones rápidas, tipadas y calibradas. La compañía también afirma que eliminar la generación libre evita errores de tipo en la salida y permite integrar las respuestas directamente en workflows.
Eso no significa que cada clasificación semántica sea correcta.
Una salida puede respetar perfectamente el esquema y aun así asignar una probabilidad equivocada.
La ventaja es otra: el contrato de salida está acotado y la incertidumbre está expuesta al programa.
Eso permite escribir sistemas como:
if confidence >= 0.90:
    automate()
elif confidence >= 0.70:
    ask_for_review()
else:
    fallback()
En un chatbot, la incertidumbre suele quedar escondida dentro del lenguaje.
En un decision model, puede convertirse en una variable de nuestro programa.