 Capital de Tokens
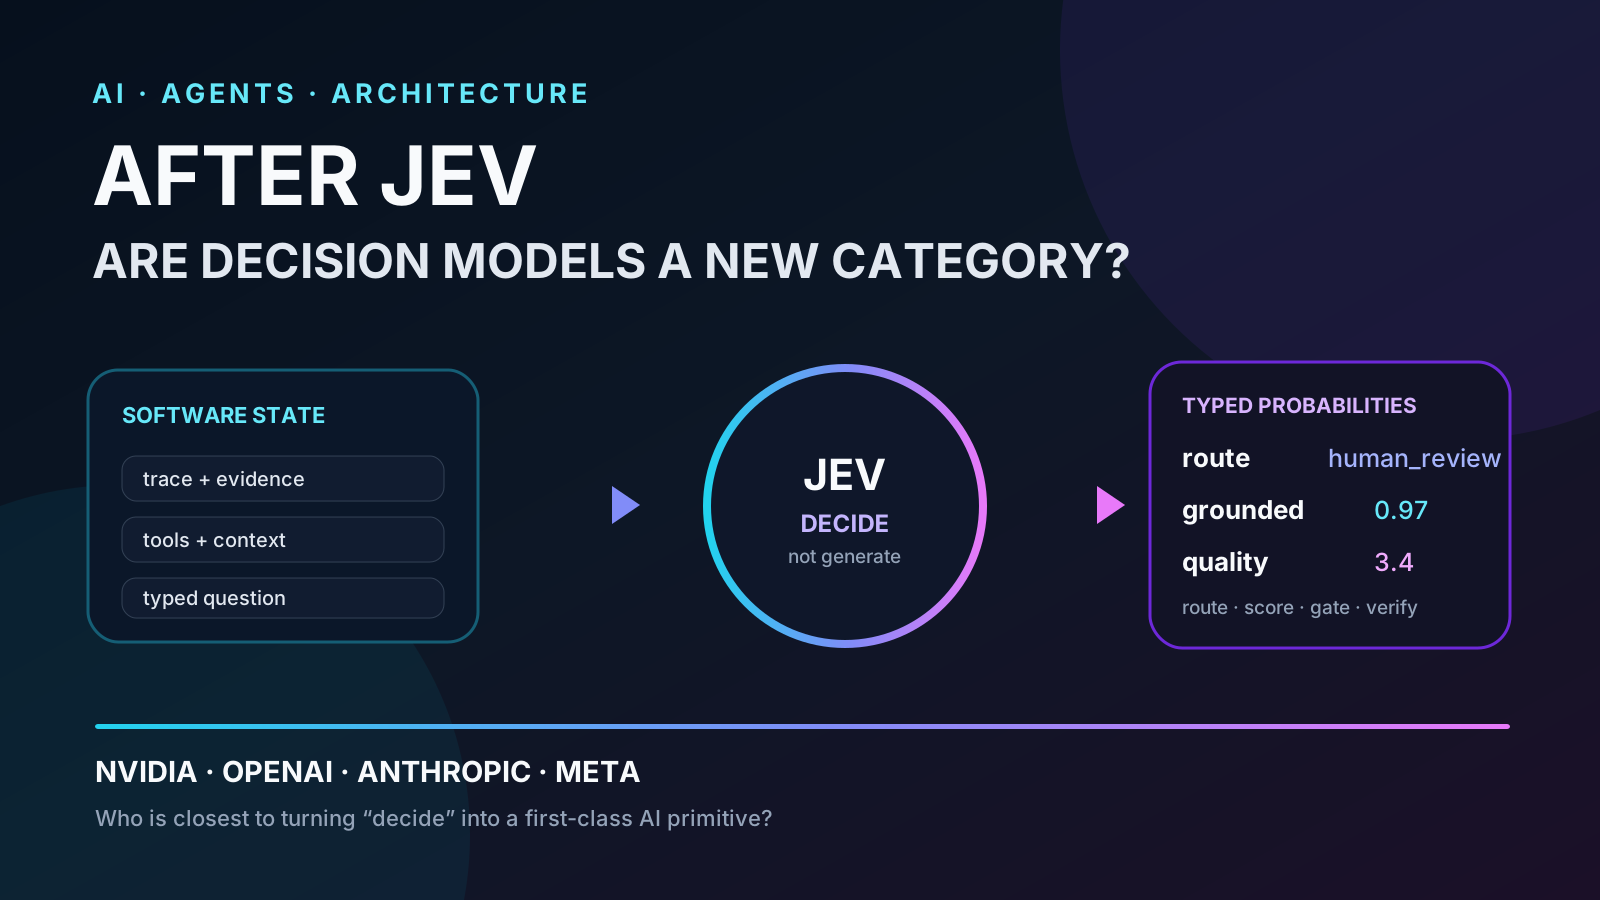
Jev plantea una idea aparentemente pequeña, pero con consecuencias arquitectónicas bastante grandes:
no toda tarea de inteligencia artificial necesita un modelo que genere texto.
En muchos sistemas el software no necesita un párrafo. Necesita una decisión.
¿La respuesta está respaldada por la evidencia?
¿qué tool debe ejecutarse?
¿esta ejecución merece revisión humana?
¿qué ruta debe seguir el workflow?
¿qué tan buena es esta salida?
Un LLM convencional puede responder esas preguntas. Pero hacerlo implica utilizar una arquitectura optimizada para generar secuencias de tokens incluso cuando el resultado útil termina siendo algo como:
grounded = 0.97
route = "human_review"
quality = 3.4
TypeSafe AI está intentando convertir ese patrón en una categoría propia.
Su primer modelo público, Jev, forma parte de lo que la compañía llama System One Models: modelos diseñados para recibir estado no estructurado y devolver decisiones estructuradas, tipadas y acompañadas por probabilidades.
La pregunta interesante ya no es solamente si Jev funciona.
Es esta:
Si esta arquitectura demuestra que existe un mercado real, ¿cuánto tardarán los grandes laboratorios en ofrecer algo parecido?
Primero: qué significa aquí “decision model”
No estoy usando el término como sinónimo de clasificador tradicional.
Un clasificador convencional suele estar entrenado para una tarea relativamente fija:
spam / no spam
fraude / legítimo
positivo / negativo
Jev intenta ocupar un espacio mucho más general.
La aplicación envía un estado arbitrario y define en tiempo de ejecución qué quiere decidir.
Por ejemplo:
questions = {
    "grounded": {
        "type": "noul",
        "instructions": "¿La respuesta está respaldada por la evidencia?"
    },
    "route": {
        "type": "choice",
        "options": [
            "fast_model",
            "reasoning_model",
            "human_review"
        ]
    },
    "quality": {
        "type": "score",
        "criteria": [
            "poor",
            "acceptable",
            "good",
            "excellent"
        ]
    }
}
El modelo no tiene que redactar una explicación para después convertirla otra vez en JSON.
El contrato ya está definido.
estado
  │
  ▼
decision model
  │
  ├── probabilidad
  ├── categoría
  ├── score
  └── confianza
TypeSafe describe a Jev como un modelo para “decisions, not strings” y afirma que sus System One Models utilizan una arquitectura, sampler y método de entrenamiento orientados a decisiones calibradas.
Es importante separar dos cosas.
Las cifras de velocidad, coste y rendimiento publicadas por TypeSafe son claims del fabricante, aunque la compañía publica metodología y matices sobre sus benchmarks. Lo verdaderamente interesante para esta discusión es la forma del producto: una API de inteligencia diseñada específicamente para que el software tome decisiones.
Ya vimos la mecánica de Jev en Jev después del lanzamiento: qué está diciendo la comunidad técnica y cómo puede utilizarse como juez en Qué es un agent evaluator.
Aquí quiero mirar el siguiente paso.
La categoría que podría aparecer entre reglas y LLMs
Hoy muchos sistemas tienen dos extremos.
reglas deterministas
        │
        │  baratas, rápidas, rígidas
        ▼
     software
        ▲
        │  flexible, semántico, más caro
        │
       LLM
Pero existe una enorme cantidad de decisiones donde ninguno de los dos extremos es ideal.
Por ejemplo:
¿esta tool call parece coherente con la intención?
¿cuál de cinco handlers debe recibir este ticket?
¿este resultado es suficientemente bueno para continuar?
¿la nueva respuesta contradice el estado anterior?
¿debo escalar al modelo caro?
¿esta trace tiene señales de error?
Una regla escrita a mano puede ser demasiado frágil.
Un modelo generativo grande puede ser excesivo.
Ahí aparece una tercera capa:
reglas
   ↓
decision model
   ↓
LLM / agente
o incluso:
             ┌──────────────┐
caso simple ─► decision model├──► acción
             └──────┬───────┘
                    │ baja confianza
                    ▼
              modelo grande
                    │
                    ▼
              revisión humana
Si esto funciona bien, no sustituye a los LLMs.
Los convierte en el slow path.
Por qué esto recuerda a embeddings y rerankers
Hubo un momento en el que muchas tareas semánticas podían resolverse enviando texto directamente a un LLM.
Pero con el tiempo aparecieron categorías especializadas.
LLMs        → generar y razonar
embeddings  → representar significado
rerankers   → ordenar candidatos
moderation  → detectar riesgos
Cada categoría existe porque una arquitectura o interfaz más especializada puede ofrecer una mejor combinación de:
- coste;
- latencia;
- consistencia;
- capacidad;
- facilidad de integración.
La hipótesis detrás de Jev es que decidir dentro del software merece otra categoría:
decision models → clasificar, puntuar, enrutar, verificar y decidirTodavía es demasiado pronto para saber si el nombre quedará.
Pero el problema que intenta resolver es real.
Las cuatro compañías que miraría
Si Jev consigue adopción importante, hay cuatro actores especialmente interesantes porque ya poseen partes de la tecnología necesaria.
Mi estimación, basada únicamente en productos y documentación pública disponibles al 22 de septiembre de 2026, sería:
| Compañía | Probabilidad estimada de ser la primera con una alternativa general comparable |
|---|---|
| NVIDIA | 40% |
| OpenAI | 32% |
| Anthropic | 18% |
| Meta | 10% |
Estas cifras no son probabilidades de mercado calibradas ni información interna.
Son una estimación subjetiva sobre quién parece tener menos distancia técnica y de producto hasta un API general de decisiones.
Veamos por qué.
NVIDIA: 40%
NVIDIA ya tiene una pieza extremadamente cercana en NeMo Evaluator.
La plataforma puede evaluar:
- modelos;
- pipelines RAG;
- agentes;
- respuestas finales;
- trayectorias;
- tool calls;
- métricas personalizadas.
También permite usar modelos como jueces y producir scores a partir de rúbricas.
Para evaluación de agentes, NVIDIA distingue entre evaluar solamente la salida y evaluar la trayectoria completa que llevó al resultado.
Eso significa que la infraestructura ya entiende exactamente el tipo de estado que un decision model podría consumir.
Hoy, sin embargo, muchas de esas métricas siguen utilizando un LLM-as-a-judge.
La propia documentación de métricas agentic señala que gran parte de ellas requieren un judge LLM.
Ese es el hueco.
NVIDIA ya tiene:
traces
 + métricas
 + agent evaluation
 + Nemotron
 + infraestructura de inferencia
 + hardware
Lo que le falta para acercarse mucho más a Jev sería convertir una parte de esa pila en algo como:
state
  ↓
Nemotron Decision
  ↓
typed probabilities
Por eso la coloco ligeramente por delante.
No porque haya anunciado ese producto.
Sino porque el salto desde lo que ya ofrece hasta esa forma de API parece relativamente corto.
OpenAI: 32%
OpenAI es probablemente el caso más interesante desde el punto de vista de API.
La plataforma ya tiene Graders.
Actualmente existen, entre otros:
- string graders;
- similarity graders;
- score-model graders;
- label-model graders;
- combinaciones de varios graders.
Un score-model grader utiliza un modelo para asignar una puntuación.
Un label-model grader utiliza un modelo con structured outputs para asignar etiquetas.
Conceptualmente estamos bastante cerca de:
input
  ↓
model
  ↓
score / label
La diferencia sigue siendo fundamental.
El grader continúa siendo un modelo generativo utilizado como juez.
Jev propone que el modelo mismo esté optimizado para decisiones probabilísticas, no para producir lenguaje y luego restringir su salida.
Si OpenAI decidiera exponer algo parecido, podría integrarlo de forma muy natural:
client.decisions.create(
    state=trace,
    questions={
        "grounded": boolean(),
        "route": choice(["fast", "reasoning", "human"]),
        "quality": score(["bad", "ok", "good", "great"])
    }
)
Eso encajaría bien con Evals, agentes, guardrails y routing.
La razón por la que no pongo a OpenAI primera es que, públicamente, su estrategia sigue aprovechando modelos generales para una gran cantidad de tareas.
Pero si el mercado de decision models resulta grande, OpenAI podría cerrar la distancia muy rápido.
Anthropic: 18%
Anthropic ya utiliza classifiers como parte importante de sus sistemas de seguridad.
En julio de 2026, por ejemplo, publicó detalles sobre clasificadores que acompañan a Claude Fable 5 para detectar y bloquear ciertos usos peligrosos relacionados con ciberseguridad.
Eso demuestra algo importante:
Anthropic ya considera que algunas decisiones críticas no tienen por qué delegarse al mismo modelo que genera la respuesta.
Arquitectónicamente, el patrón se parece a:
request
   ↓
classifier
   ├── allow
   └── block
        ↓
      Claude
El salto conceptual hacia un classifier general programable existe.
Pero públicamente Anthropic ha concentrado estas piezas sobre todo en seguridad.
No ofrece todavía un primitive general equivalente a:
"te doy cualquier estado y una pregunta tipada;
devuélveme una distribución de probabilidad"
Por eso la probabilidad es menor que NVIDIA y OpenAI.
Meta: 10%
Meta quizá tenga el ejemplo más claro de que los modelos pequeños especializados pueden ser extremadamente útiles.
Prompt Guard 2 existe en variantes de 86M y 22M parámetros.
La versión de 22M está diseñada explícitamente para reducir latencia y coste computacional al detectar jailbreaks e inyecciones de prompt.
Meta también tiene Llama Guard para clasificación de seguridad de entradas y respuestas.
Eso demuestra que Meta ya explora esta arquitectura:
modelo pequeño especializado
          ↓
decisión rápida
          ↓
modelo grande / aplicación
Sin embargo, sus herramientas públicas están especializadas principalmente en seguridad.
El paso que falta es convertir esa filosofía en un modelo general de decisiones definido por el usuario.
Además, la estrategia de Meta suele favorecer pesos abiertos y componentes que los desarrolladores operan por su cuenta, mientras Jev se presenta como un API especializado.
Podría aparecer una alternativa abierta potentísima.
Simplemente no parece, por ahora, el camino de producto más directo entre estas cuatro compañías.
Lo importante no es quién copie a Jev
La pregunta más útil no es:
¿quién lanzará un clon de Jev?
Puede que nadie copie exactamente su API.
La señal importante sería que empezáramos a ver términos como:
decision model
judge model
router model
verification model
policy model
semantic classifier
convertirse en productos de primera clase.
En otras palabras, que estas capacidades dejen de ser simplemente:
“usa un LLM barato y pídele que devuelva JSON”
y empiecen a tratarse como una carga de trabajo distinta.
Por qué los agentes podrían acelerar esta transición
Los agentes multiplican el número de decisiones que realiza el software.
Un chatbot puede necesitar un modelo una vez por turno.
Un agente puede tomar muchas decisiones dentro de una sola petición:
1. interpretar intención
2. escoger tool
3. validar argumentos
4. juzgar resultado
5. decidir si reintentar
6. escoger siguiente tool
7. verificar groundedness
8. decidir si escalar
9. aprobar respuesta final
Ahora multiplica eso por millones de ejecuciones.
Si cada microdecisión requiere un LLM grande, el coste y la latencia se acumulan rápidamente.
Por eso un decision model podría actuar como capa de control del agente.
              ┌────────────┐
              │   usuario  │
              └─────┬──────┘
                    ▼
              ┌────────────┐
              │   agente   │
              └─────┬──────┘
                    ▼
         ┌──────────────────────┐
         │    decision model    │
         │ route / score / gate │
         └───┬─────────┬────────┘
             │         │
       continuar    escalar
             │         │
             ▼         ▼
           tool      LLM grande
Ese patrón puede terminar siendo mucho más importante que el uso de decision models como simples evaluators.
El mayor riesgo para Jev
Si Jev fracasa, podría ser porque el mercado realmente no necesita una categoría independiente.
Tal vez los modelos generales bajen de precio y latencia tan rápido que sea suficiente utilizar:
small LLM + structured outputpara estas tareas.
Ese escenario convertiría la ventaja arquitectónica de Jev en una optimización interesante, pero no necesariamente en una categoría de producto.
El otro riesgo es exactamente el contrario.
Jev podría demostrar tan claramente el valor del patrón que los grandes proveedores incorporen capacidades similares directamente en sus plataformas.
Entonces aparecerían:
OpenAI Decisions
NVIDIA Nemotron Judge
Anthropic Classifier API
Meta Decision Llama
Los nombres son hipotéticos.
La presión competitiva no lo sería.
Lo que tendría que ocurrir para considerar la categoría validada
No basta con buenos benchmarks.
Yo buscaría cinco señales.
1. Uso dentro de production loops
No solamente evaluación offline.
Routing, gating y decisiones reales dentro del camino crítico.
2. Alto volumen
Millones o miles de millones de decisiones.
Ahí la ventaja de coste empieza a importar muchísimo.
3. Calibración que permita thresholds útiles
Por ejemplo:
if confidence > 0.97:
    auto_execute()
elif confidence > 0.75:
    ask_large_model()
else:
    human_review()
La probabilidad debe significar algo operacional.
4. Herramientas alrededor del primitive
Observabilidad, datasets, threshold tuning, drift detection y evaluación.
5. Competidores
Paradójicamente, una de las mejores señales de que Jev acertó sería ver a otras empresas construir productos parecidos.
Las categorías importantes rara vez permanecen con un solo proveedor.
Mi expectativa
No existe información pública que indique que NVIDIA, OpenAI, Anthropic o Meta estén preparando un clon directo de Jev.
Por eso cualquier fecha sería especulación.
Pero si durante los próximos meses Jev demuestra que existe una demanda grande por decisiones semánticas:
- baratas;
- rápidas;
- tipadas;
- probabilísticas;
- integrables directamente en código;
me sorprendería que la idea permaneciera exclusivamente en TypeSafe durante mucho tiempo.
Mi hipótesis es que en los próximos 12 a 18 meses podríamos empezar a ver más productos que separen explícitamente:
GENERAR
de
DECIDIR
Y si eso ocurre, Jev habrá hecho algo más importante que lanzar otro modelo.
Habrá ayudado a definir una categoría.
Fuentes
- TypeSafe AI — Introducing System One Models & Jev
- TypeSafe AI — API de System One
- OpenAI — Graders API
- NVIDIA — NeMo Evaluator
- NVIDIA — Agent Evaluation
- NVIDIA — Agentic Evaluation Metrics
- Anthropic — Fable 5 cyber safeguards and safety classifiers
- Meta — Llama protection tools, Llama Guard 4 and Prompt Guard 2