5 de septiembre de 2026 · Capital de Tokens
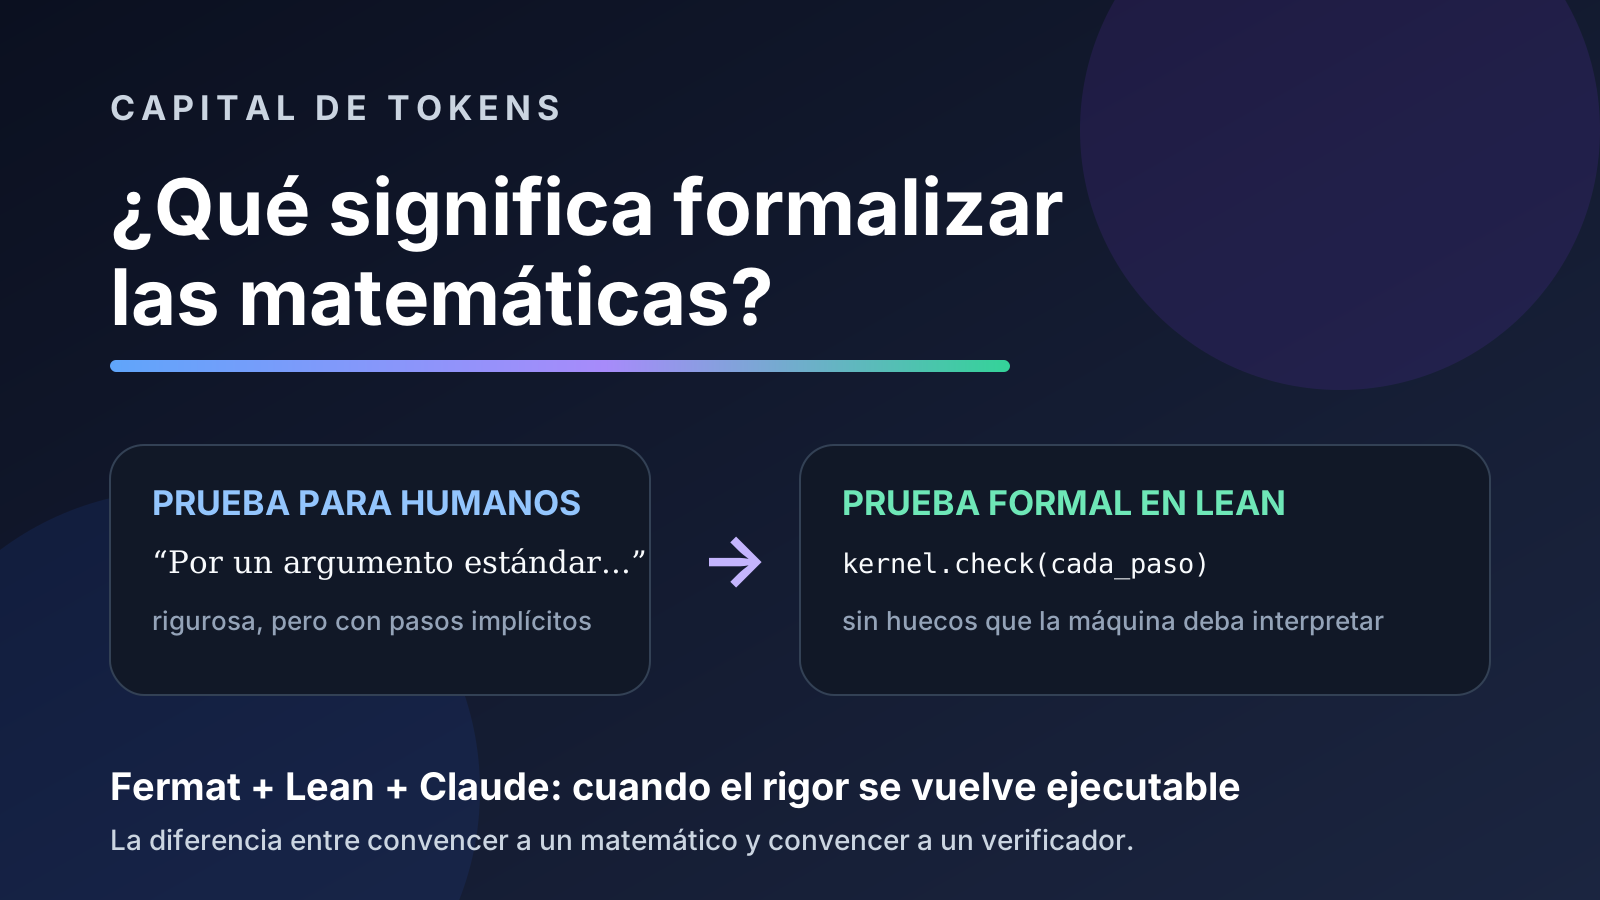
Las matemáticas ya son rigurosas, pero la mayoría de las pruebas no están escritas con el nivel de detalle que necesita una computadora. El caso reciente del Último Teorema de Fermat formalizado en Lean por agentes de Claude muestra qué cambia cuando cada definición, hipótesis y paso lógico debe ser verificable por un kernel.
5 de septiembre de 2026 · Capital de Tokens
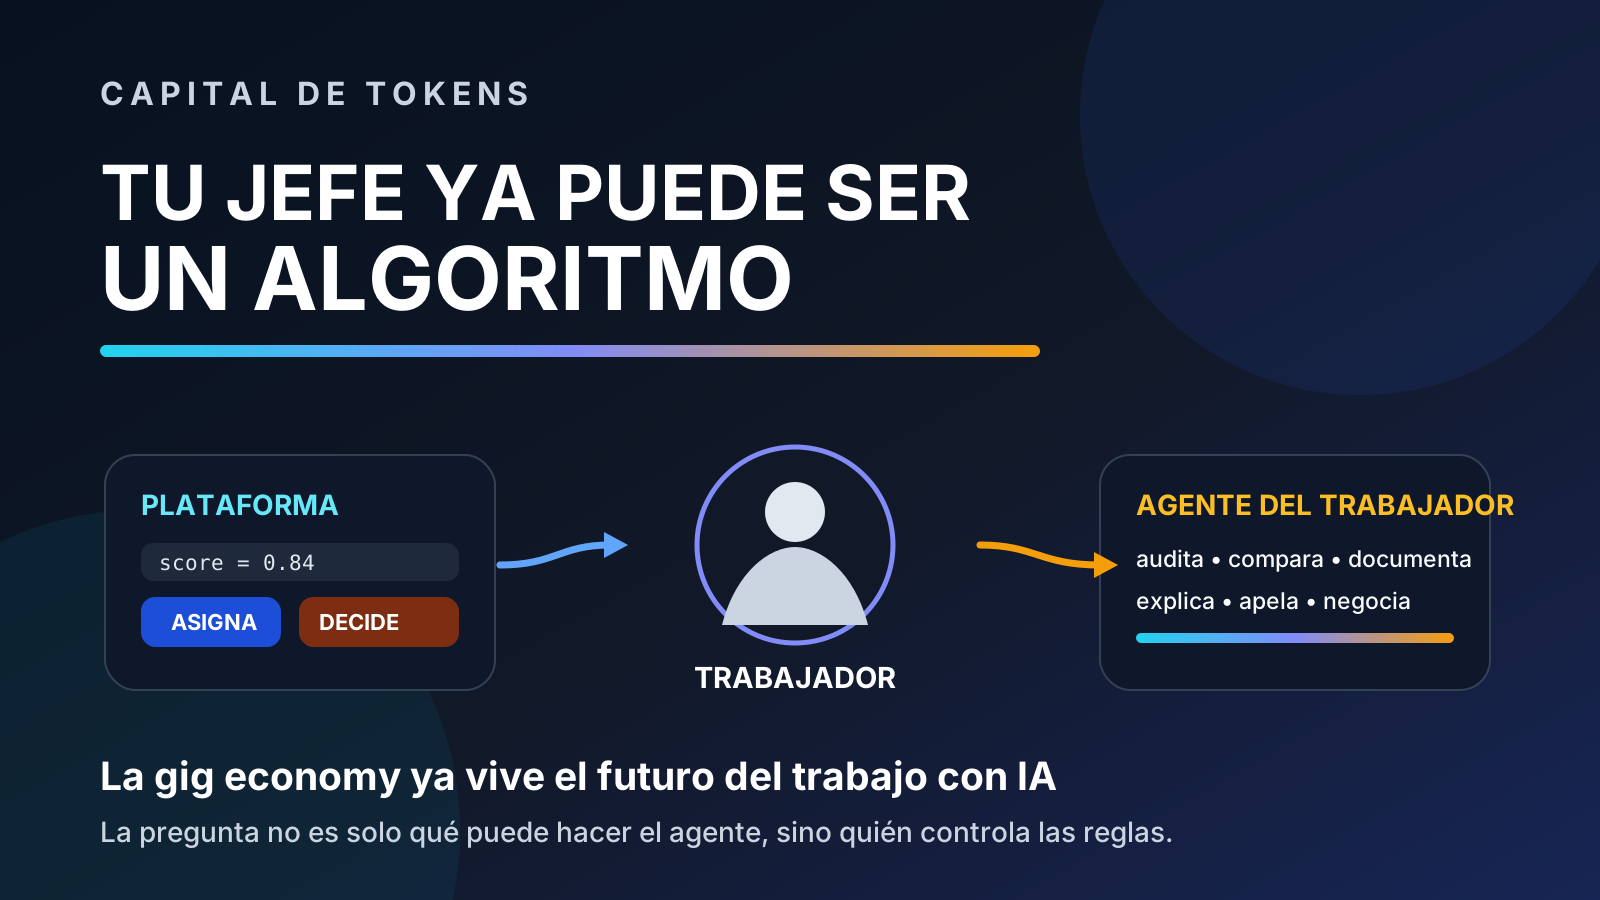
La discusión sobre agentes autónomos suele mirar al futuro, pero Uber, DoorDash y otras plataformas ya muestran qué ocurre cuando un algoritmo asigna trabajo, fija incentivos y puede dejar a una persona sin acceso a su ingreso. La investigación de Andrés Monroy-Hernández en Princeton ofrece una forma más útil de pensar el futuro laboral con IA: no solo como automatización, sino como una cuestión de poder, transparencia y diseño de plataformas.
5 de septiembre de 2026 · Capital de Tokens
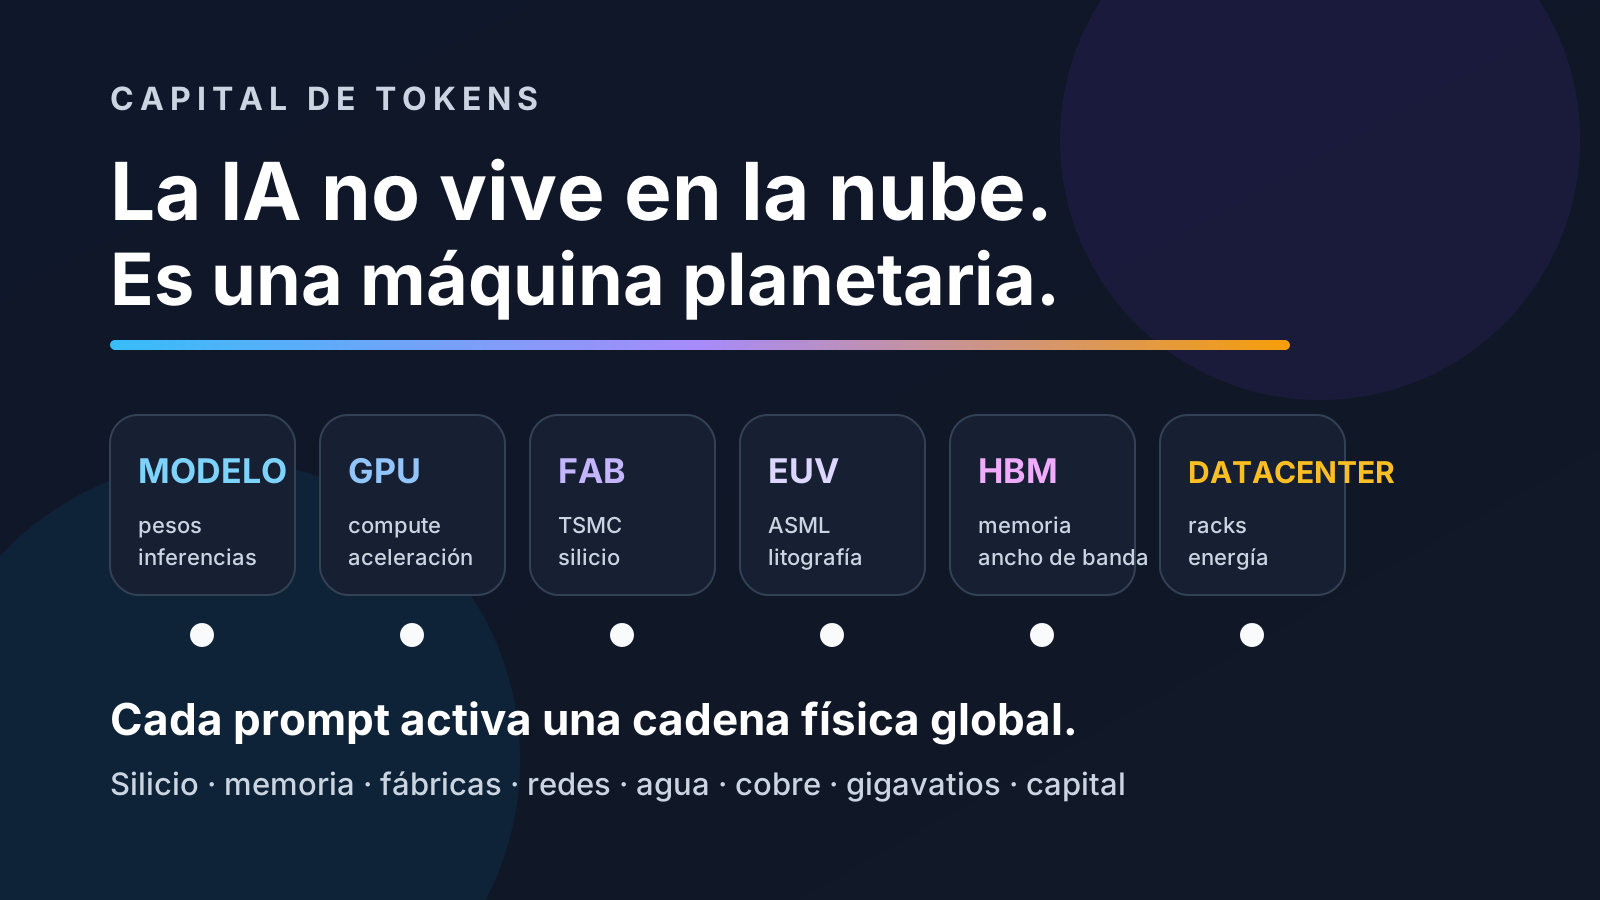
Detrás de cada respuesta de un modelo hay una cadena física de chips, litografía, memoria, centros de datos, redes eléctricas, minerales y capital. La IA no vive sólo en la nube: se está convirtiendo en una de las mayores infraestructuras industriales de nuestra época.
5 de septiembre de 2026 · Capital de Tokens
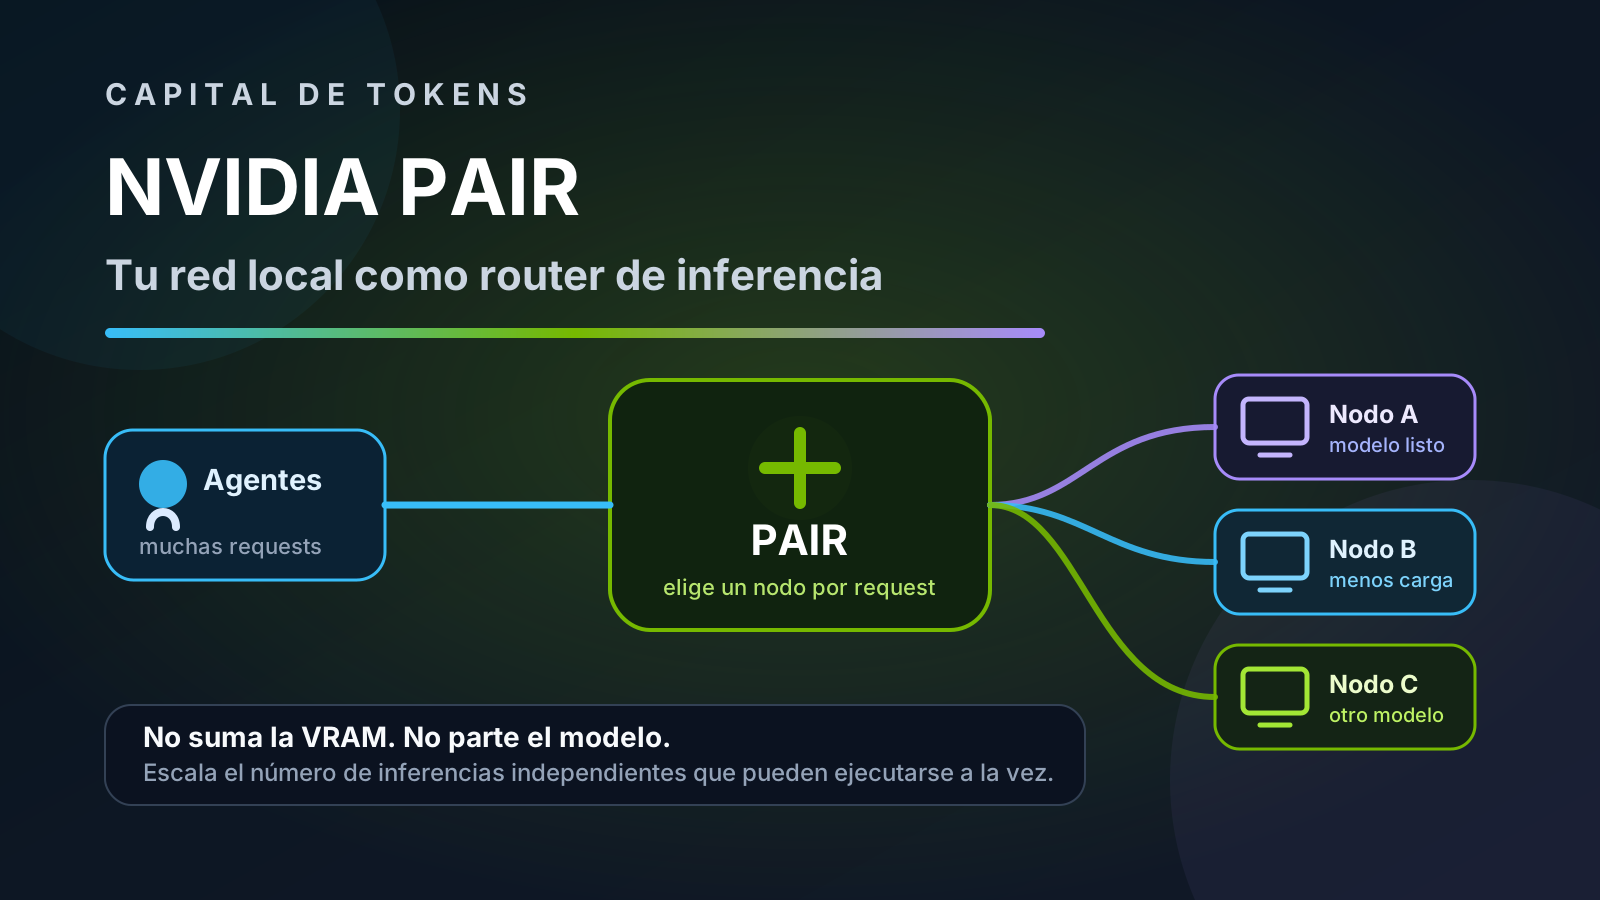
NVIDIA PAIR distribuye requests de inferencia entre equipos compatibles de una red local usando Ollama o LM Studio. No suma VRAM ni divide modelos: su valor está en ejecutar más trabajo independiente en paralelo, especialmente en sistemas multiagente.
4 de septiembre de 2026 · Capital de Tokens
Tesla puso el Cybercab en circulación en Austin. Más allá del vehículo, lo interesante es la ruptura económica: un coche que puede moverse sin conductor cambia el coste por viaje, la propiedad, el taxi, los seguros y hasta el diseño de las ciudades.
4 de septiembre de 2026 · Capital de Tokens
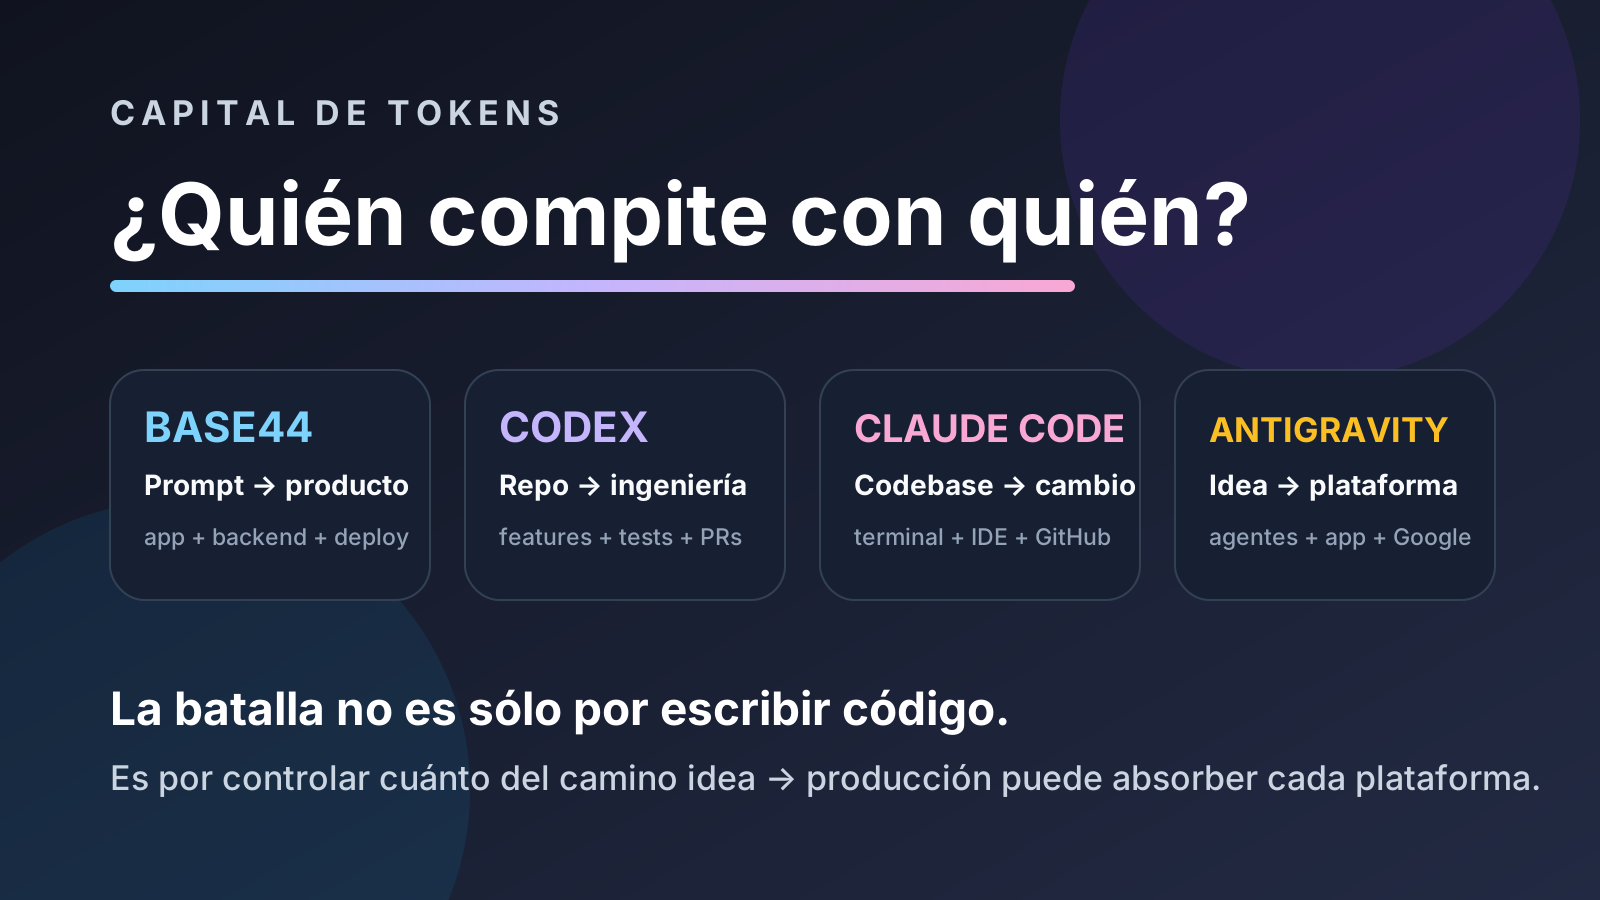
Base44 promete llevar una idea directamente a una app publicada; Codex y Claude Code se enfocan en ingeniería sobre repositorios reales; Antigravity intenta cubrir ambos mundos. La comparación útil no es quién escribe mejor código, sino qué parte del camino desde la idea hasta producción absorbe cada plataforma.
4 de septiembre de 2026 · Capital de Tokens
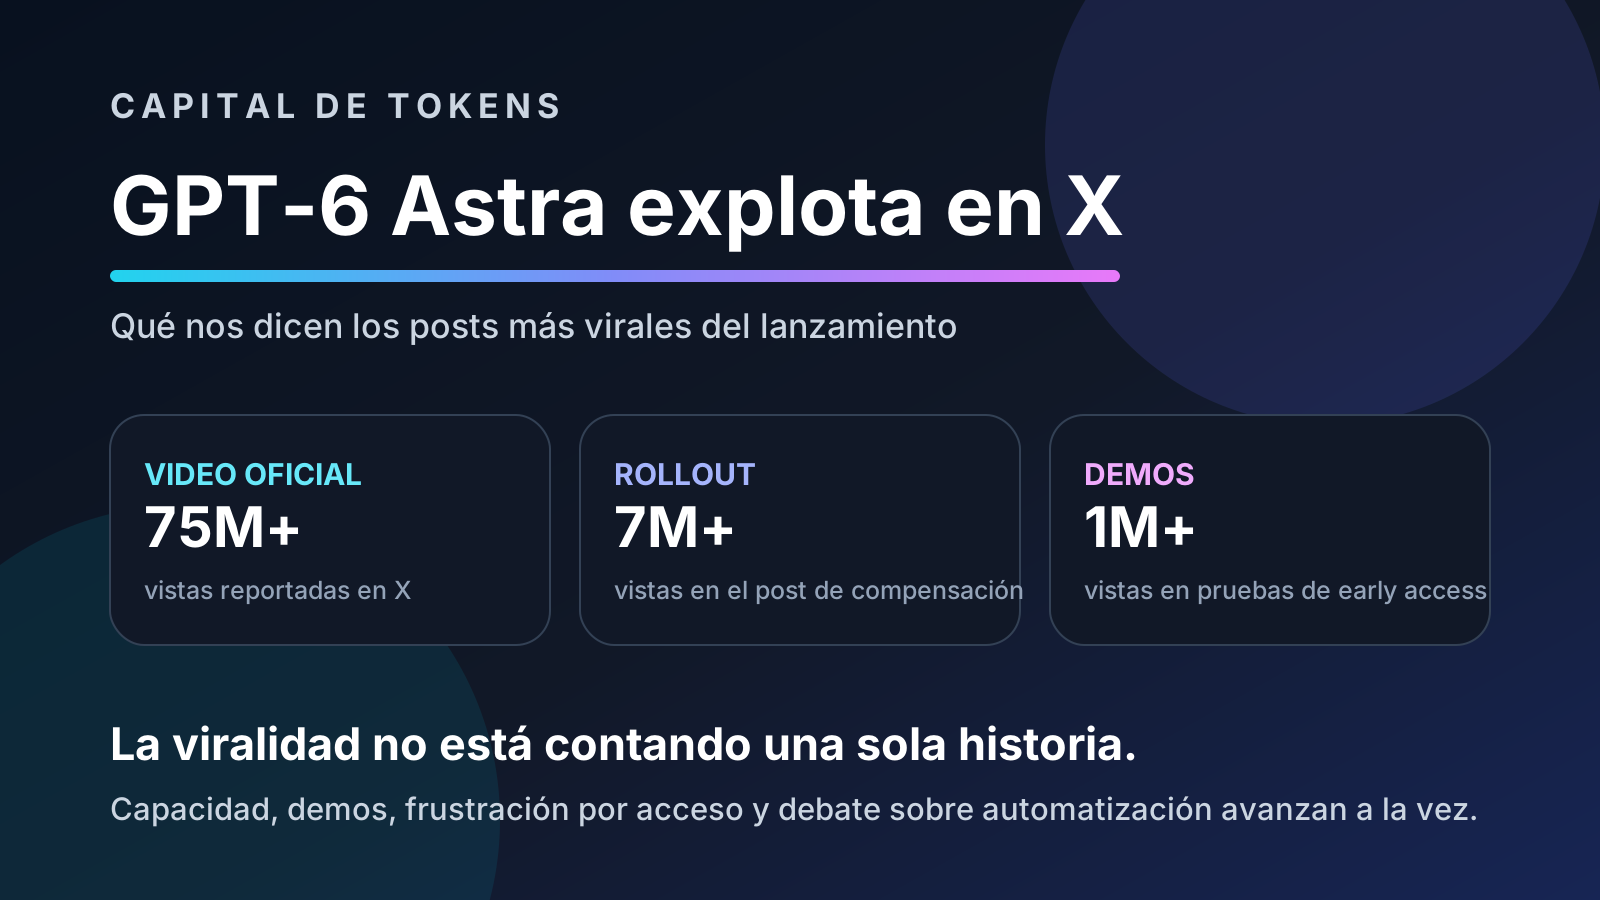
El lanzamiento de GPT-6 Astra produjo una conversación enorme en X: un video oficial con decenas de millones de vistas, demos de early access, entusiasmo por el computer use y una segunda ola de viralidad causada por el rollout. Más que un ranking, estos posts muestran qué parte de Astra está capturando la atención de internet.
3 de septiembre de 2026 · Capital de Tokens
La IA puede convertirse en un atajo cognitivo o en una herramienta para pensar con más rigor. Un método práctico para usarla como adversario intelectual, asistente de investigación, tutor y sistema de reflexión sin delegar el juicio.
2 de septiembre de 2026 · Capital de Tokens
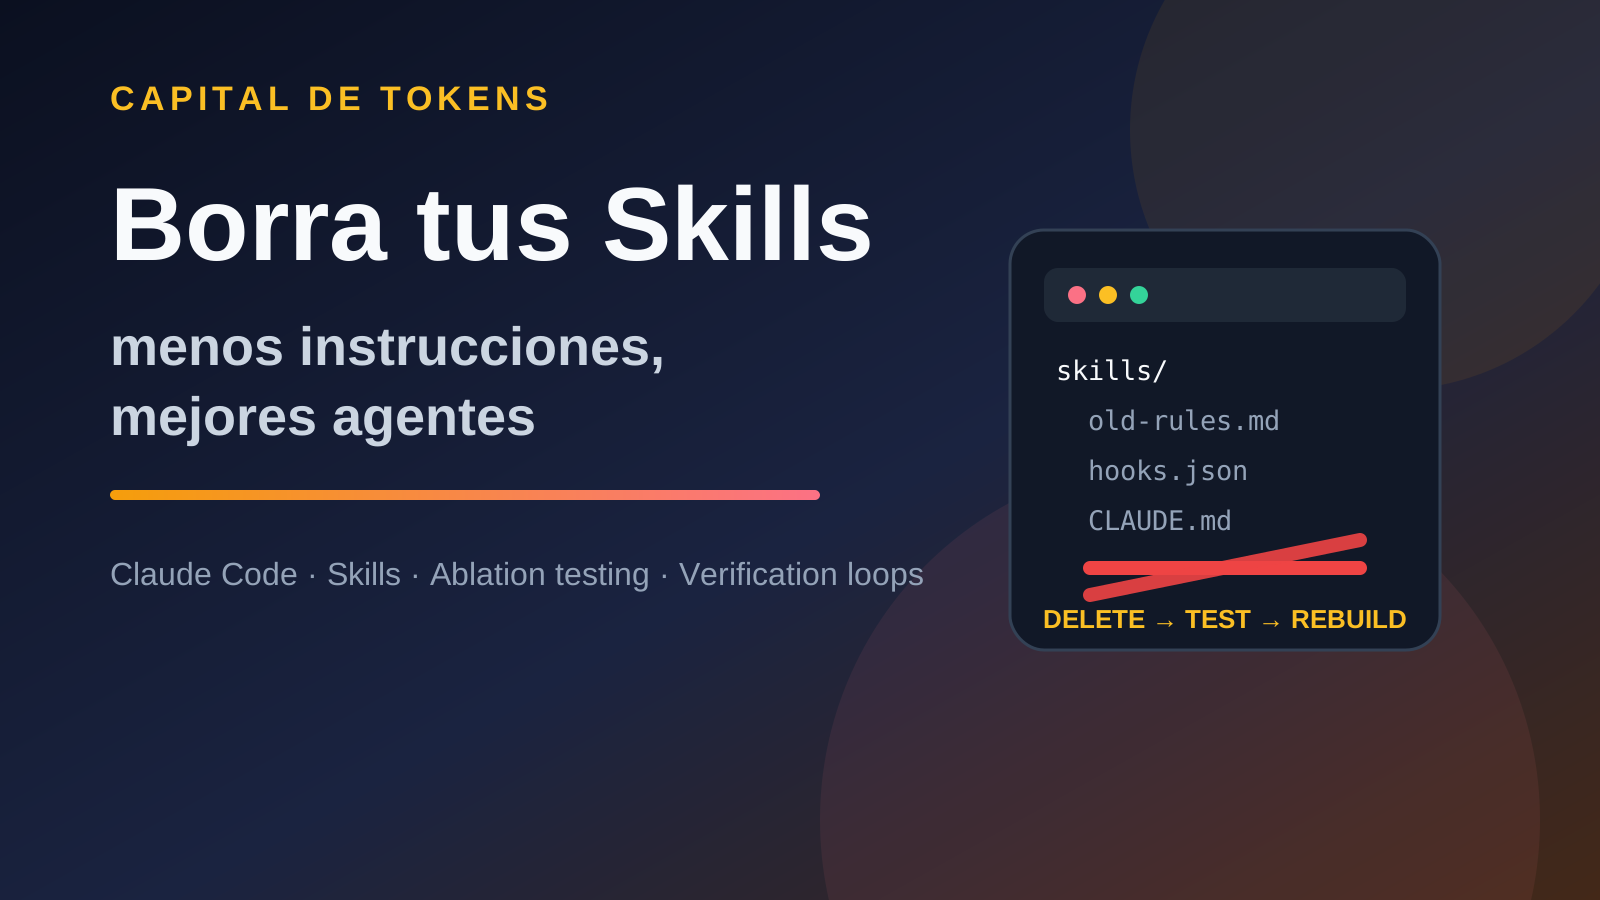
Boris Cherny, creador de Claude Code, recomienda borrar periódicamente CLAUDE.md, Skills y hooks para comprobar qué sigue siendo necesario. La lección no es abandonar los agentes especializados, sino tratar las instrucciones como deuda que debe justificar su costo con resultados medibles.
2 de septiembre de 2026 · Capital de Tokens
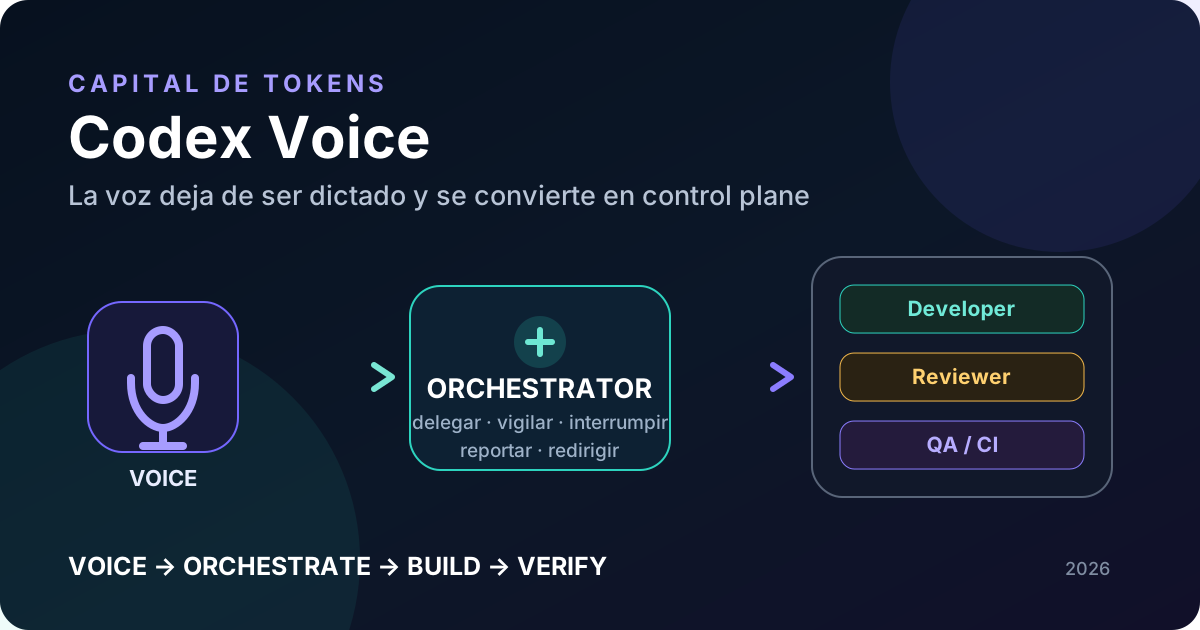
La comunidad está usando Voice en Codex para algo más interesante que hablarle a un editor: coordinar workers, consultar progreso, redirigir tareas y trabajar hands-free. Repasamos los patrones reales, los problemas todavía abiertos y qué arquitectura sugiere todo esto para los agentes de desarrollo por voz.
2 de septiembre de 2026 · Capital de Tokens
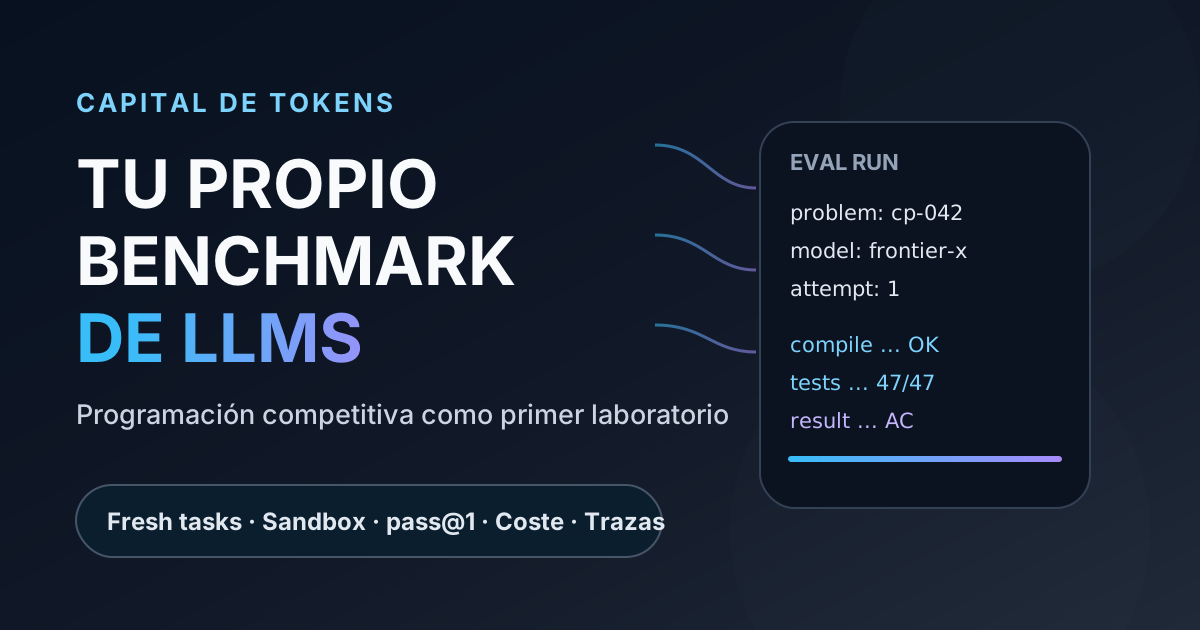
Los rankings públicos no siempre responden a la pregunta que realmente te importa. Diseñamos una arquitectura para evaluar LLMs con benchmarks propios, empezando por problemas frescos de programación competitiva, ejecución reproducible, métricas de coste y una separación clara entre modelo y agente.
2 de septiembre de 2026 · Capital de Tokens
En Platzi Conf 2026, Freddy Vega planteó un escenario deliberadamente optimista para la inteligencia artificial: conocimiento experto casi gratis, ciencia acelerada, software mucho más barato y una ventana estratégica para Latinoamérica. Revisamos qué parte de esa tesis ya tiene evidencia y dónde conviene mantener cautela.
 Capital de Tokens